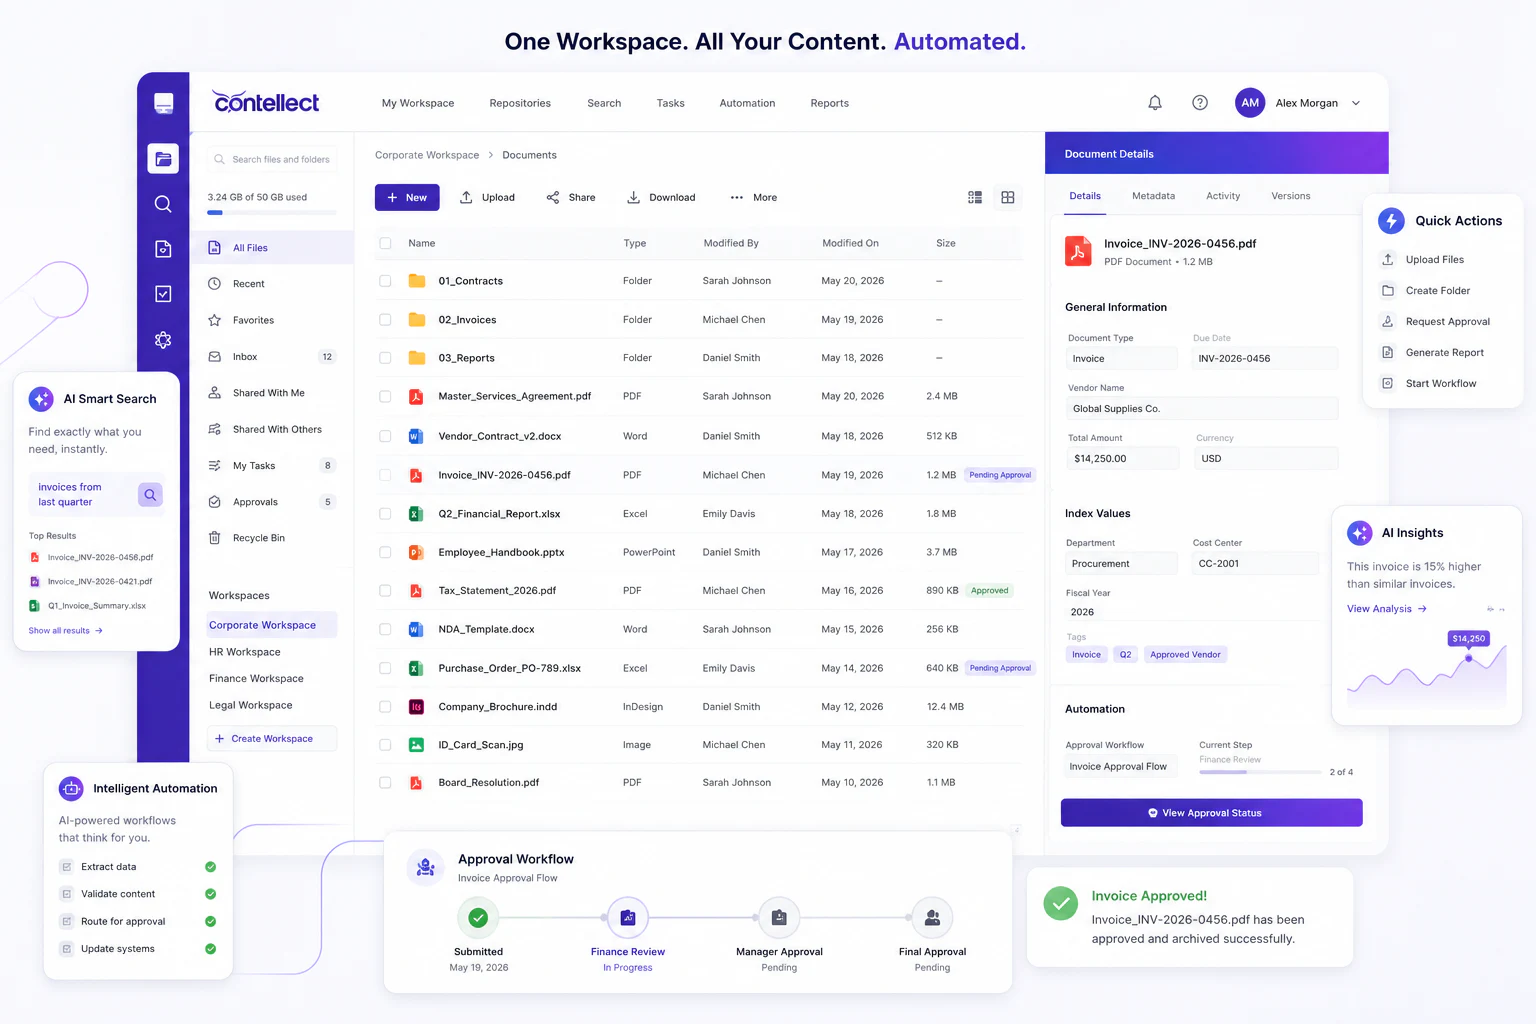
Kennisverrijking voor Enterprise AI
Ontdek hoe kennisverrijking ongestructureerde content verbindt met metadata en herkomst voor betrouwbare, AI-gerede informatie voor search en automatisering.
Enterprise AI faalt zelden omdat een organisatie te weinig content heeft. Het faalt omdat de content moeilijk te interpreteren is. Beleidsdocumenten staan naast achterhaalde concepten, facturen komen binnen als scans, contracten gebruiken inconsistente namen, en belangrijke context blijft vastzitten in mappen of in de hoofden van medewerkers.
Kennisverrijking zet die ongestructureerde content om in informatie die mensen en AI-systemen met vertrouwen kunnen gebruiken. Het voegt structuur, metadata, herkende entiteiten, relaties, herkomst en zakelijke context toe, terwijl het brondocument behouden blijft. Het resultaat is niet zomaar een betere tag. Het is een beheerste laag van betekenis die search, automatisering, analyse en AI-ondersteund werk verbetert.
Belangrijkste inzichten
- Kennisverrijking verbindt content met haar zakelijke betekenis, niet alleen met de bestandseigenschappen.
- Een praktische pijplijn combineert vastlegging, normalisatie, classificatie, extractie, entiteitsherkenning, contextuele koppeling en validatie.
- Betere context verbetert retrieval, vermindert handmatige voorbereiding en geeft AI-agents veiligere grenzen.
- Governance blijft essentieel, omdat verrijking op zichzelf geen gezag, toegang, bewaartermijn of toegestaan gebruik bepaalt.
- Het beste startpunt is een afgebakend proces met een meetbaar resultaat, niet een organisatiebreed tagging-programma.
Wat is kennisverrijking?
Kennisverrijking is het proces waarbij ongestructureerde content begrijpelijk wordt gemaakt binnen een context. Een basale repository weet mogelijk dat een bestand een PDF is, wie het heeft geüpload en wanneer het is gewijzigd. Een verrijkt systeem weet ook dat het bestand een ondertekende leveranciersovereenkomst is, dat Acme Trading en ACME Ltd. naar dezelfde organisatie verwijzen, dat de overeenkomst een specifieke inkooporder regelt, en dat de verlengingsdatum nadert.
Dat onderscheid is belangrijk. Bestandsmetadata beschrijft de container. Verrijkte kennis beschrijft wat de content betekent en hoe die zich verhoudt tot het werk.
| Laag | Vraag die het beantwoordt | Voorbeeld |
|---|---|---|
| Technische metadata | Wat is het bestand? | PDF, 18 pagina’s, aangemaakt op 12 augustus |
| Beschrijvende metadata | Waar gaat het over? | Leveranciersovereenkomst voor facilitaire diensten |
| Geëxtraheerde entiteiten | Welke zakelijke objecten komen voor? | Leverancier, contracteigenaar, rechtsgebied, verlengingsdatum |
| Relaties | Hoe is het verbonden? | Regelt PO-1842 en vervangt overeenkomst C-118 |
| Governancecontext | Hoe mag het worden gebruikt? | Juridische toegangsgroep, bewaartermijn van zeven jaar |
| Operationele context | Wat moet er vervolgens gebeuren? | Waarschuw de eigenaar 90 dagen voor verlenging |
Dit is waarom kennisverrijking meer is dan documentclassificatie. Classificatie bepaalt wat een document is. Verrijking bouwt de bredere context die nodig is om het te vinden, te vergelijken, erover te redeneren en de juiste actie te activeren.
Kennisverrijking versus dataverrijking
De termen klinken vergelijkbaar, maar lossen verschillende problemen op.
Dataverrijking verbetert doorgaans een gestructureerd record door bekende waarden toe te voegen. Een klantrecord kan een branchecode, geografische regio of bedrijfsgrootte krijgen uit een andere database.
Kennisverrijking begint met content waarvan de betekenis nog niet is geordend in rijen en velden. Het analyseert een document, e-mail, afbeelding, transcript of presentatie, identificeert wat ertoe doet, en verbindt die betekenis aan een taxonomie, zakelijk object, proces of kennisgraaf.
Beide benaderingen verbeteren de informatiekwaliteit. Het verschil zit in het startpunt en de diepte van de context. Dataverrijking vult hiaten in een schema. Kennisverrijking helpt het schema en de relaties te creëren vanuit content die deze nog niet had.
Hoe de kennisverrijkingspijplijn werkt
Een betrouwbare pijplijn bewaart eerst bewijs, voegt vervolgens laag voor laag betekenis toe en activeert alleen gevalideerde kennis. Dit voorkomt dat een gepolijste AI-ervaring zwakke context of toegangscontroles onder de oppervlakte verbergt.
Vastleggen en bewaren
Verbind goedgekeurde repositories, e-mail, scanners, applicaties en archieven. Bewaar het origineel, de bronlocatie, tijdstempels en de bewaarketen.
Resultaat: herleidbare broncontentNormaliseer de content
Pas OCR toe, splits samengestelde bestanden, detecteer de taal en standaardiseer datums, eenheden en formaten zonder de originele weergave te wissen.
Resultaat: verwerkbare contentClassificeer het document
Bepaal het documenttype en de zakelijke categorie, zodat de juiste regels voor extractie, rechten en workflow kunnen worden toegepast met betrouwbaarheidsdrempels.
Resultaat: vertrouwde documentklasseExtraheer metadata en entiteiten
Leg expliciete waarden vast en herken personen, organisaties, producten, locaties, datums, gebeurtenissen en zakelijke identificatoren in doorlopende tekst.
Resultaat: gestructureerde feitenHerleid relaties
Normaliseer naamvarianten naar gedeelde identiteiten en koppel documenten aan dossiers, klanten, assets, transacties, polissen en gerelateerde content.
Resultaat: verbonden kennisValideer en beheers
Pas bedrijfsregels, betrouwbaarheidsdrempels, rechten, koppeling aan bewaartermijnen, menselijke beoordeling en bewijs van modelversies toe.
Resultaat: goedgekeurde kennisActiveer de kennis
Schrijf goedgekeurde context terug naar systems of record en maak deze beschikbaar voor enterprise search, workflows, analyse, RAG en geautoriseerde AI-agents.
Uitkomst: betere beslissingen en processenWaarom kennisverrijking belangrijk is voor enterprise AI
Large language models zijn vloeiend, maar vloeiendheid is geen gezag. Een enterprise-assistent moet de juiste beleidsversie ophalen, documentrechten respecteren, een concept onderscheiden van een ondertekende overeenkomst, en laten zien waar het antwoord vandaan komt.
Kennisverrijking verbetert die omgeving op vier manieren:
- Retrievalprecisie. Search kan semantische gelijkenis combineren met documenttype, entiteit, levenscyclusstatus, ingangsdatum en toegangsregels.
- Groundingkwaliteit. AI ontvangt de relevante passage plus de zakelijke context die nodig is om deze te interpreteren.
- Verklaarbaarheid. Antwoorden kunnen verwijzen naar een goedgekeurde bron en de metadata of relatie tonen die ertoe heeft geleid.
- Actieveiligheid. Agents kunnen handelen binnen vastgestelde grenzen, zoals het starten van een verlengingsworkflow alleen voor een ondertekend contract met een gevalideerde datum.
Een AI-assistent die elk bestand ophaalt met “reisbeleid” erin, kan een verouderd concept citeren. Een verrijkt systeem kan retrieval beperken tot goedgekeurde beleidsdocumenten, actuele versies, het rechtsgebied van de gebruiker en de ingangsdatum van de vraag. Dat is het verschil tussen plausibele tekst en betrouwbare operationele ondersteuning.
Zakelijke toepassingen
Kennisverrijking is nuttig overal waar contentvolume en context samenkomen.
| Functie | Verrijkte kennis | Zakelijke impact |
|---|---|---|
| Crediteurenadministratie | Leverancier, factuurnummer, inkooporder, bedrag, btw, goedkeuringsstatus | Snellere matching en minder handmatige handelingen |
| Contractbeheer | Partijen, clausules, verplichtingen, datums, gerelateerde overeenkomsten | Eerdere verlengingsactie en duidelijkere risicobeoordeling |
| Verzekeringen | Claimtype, polis, schadelocatie, schadebewijs, indiener | Snellere triage en completere dossiers |
| Zorg | Patiënt, contactmoment, documenttype, klinische context, gevoeligheid | Betere retrieval met strengere toegangscontrole |
| Klantenservice | Klant, product, probleem, sentiment, eerder dossier | Snellere reacties met relevante geschiedenis |
| Engineering | Asset, tekeningtype, revisie, project, goedkeuringsstatus | Minder tijd nodig om het actuele technische record te vinden |
Het gemeenschappelijke patroon is dat een document waardevoller wordt wanneer de betekenis ervan meereist. Dit ondersteunt document- en contentmanagement en vermindert tegelijk de handmatige tagging die veel repositoryprogramma’s doet vastlopen.
Een praktische implementatieroadmap
Bouw vertrouwen op in zes beheerste fasen. Elke fase levert het bewijs en de waarborgen die nodig zijn voor de volgende.
Definieer een beslissing, geen technologiedoel
Kies een meetbaar resultaat, zoals kortere doorlooptijd voor contractbeoordeling, betere eerste-keer-matching van facturen, of meer succesvolle self-service zoekopdrachten. Documenteer de nulmeting en de kosten van een onjuist resultaat.
Stel een minimaal metadatacontract op
Stel de kleinst mogelijke set velden en relaties samen die nodig zijn voor de use case. Markeer verplichte waarden, de gezaghebbende bron en de betrouwbaarheidsdrempel die automatisering toestaat.
Test representatieve content
Neem slechte scans, zeldzame documenttypen, meerdere talen, handgeschreven toevoegingen, lange documenten en echte uitzonderingen mee. Meet precisie en recall op veldniveau, niet een enkele gemiddelde score.
Voeg menselijke beoordeling toe waar risico dat vereist
Route onzekere resultaten aan de hand van betrouwbaarheidsdrempels. Leg elke correctie en de reden ervan vast, zodat modellen, regels en taxonomie verbeteren zonder dat beoordeling verandert in verborgen opruimwerk.
Integreer met het system of record
Gebruik stabiele identificatoren en gedocumenteerde API's. Voorkom dubbele terugschrijvingen, definieer retrygedrag en houd een spoor bij van elke verrijkte waarde naar haar bron.
Monitor de kwaliteit van kennis in de tijd
Volg uitzonderingen, niet-onderbouwde waarden, taxonomiedrift, retrievalsucces, beoordelaarsinspanning en correcties verderop in het proces. Valideer opnieuw wanneer een bron, model, beleid of proces verandert.
Platformverbinding: Contellect One combineert intelligente datavastlegging, contentmanagement en workflow, zodat verrijking kan bewegen van voorspelling naar beheerste actie.
Metrics die echte waarde onthullen
Beoordeel verrijking niet alleen op basis van hoeveel tags een model creëert. Gebruik metingen die gekoppeld zijn aan kwaliteit en resultaten:
- precisie en recall op veldniveau voor kritieke metadata;
- nauwkeurigheid van entiteitsresolutie;
- percentage content dat wordt verwerkt zonder beoordeling;
- beoordelaarsminuten per document;
- slagingspercentage van zoekopdrachten en tijd om een gezaghebbend antwoord te vinden;
- afname van onvolledige indieningen of correcties verderop in het proces;
- percentage AI-antwoorden met geldige, geautoriseerde bronvermeldingen;
- doorlooptijd van het proces en kosten per afgehandeld dossier.
Een hoge extractiescore kan samengaan met slechte zakelijke waarde als de verrijkte data nooit de workflow bereikt, als gebruikers deze niet kunnen vertrouwen, of als de verkeerde bron gezaghebbend blijft gemarkeerd.
Risico's en beheersmaatregelen
Koppel elk bekend faalpatroon aan een beheersmaatregel die getest, belegd en gecontroleerd kan worden.
Vals vertrouwen
Vereis betrouwbaarheidsscores, validatieregels en menselijke beoordeling voor velden met impact.
Rechtenlekkage
Handhaaf bronrechten tijdens indexering en retrieval. Behandel verrijkte metadata even gevoelig als de bron ervan.
Onduidelijke herkomst
Sla de bron, modelversie, extractietijd en correctiegeschiedenis op voor elke afgeleide waarde.
Taxonomiedrift
Wijs een eigenaar toe en monitor nieuwe of dubbelzinnige waarden, in plaats van categorieën ongecontroleerd te laten vermenigvuldigen.
Ongelijke prestaties
Test over documenttypen, talen, kanalen en getroffen groepen. Een sterk gemiddelde kan een zwak geval verbergen.
Ongereguleerde agent-acties
Scheid retrieval van de bevoegdheid om te handelen. Gebruik goedkeuringen, afgebakende tools, transactielimieten en controleerbare uitkomsten.
Van contentvolume naar bruikbare kennis
Kennisverrijking maakt niet elk document even waardevol, en het maakt governance niet overbodig. Het geeft een organisatie een gedisciplineerde manier om verspreide content om te zetten in contextueel bewijs dat search, workflows, mensen en AI kunnen gebruiken.
Begin klein: een proces, een contentset, een minimaal metadatacontract en een meetbaar resultaat. Zodra de beheersmaatregelen werken, hergebruik de pijplijn voor meer repositories en use cases. Dat creëert een AI-gerede informatiebasis zonder verrijking te veranderen in weer een ongecontroleerd dataproject.
Ontdek of deze aanpak werkt op uw eigen documenten: neem contact op met het Contellect-team en breng een representatieve steekproef mee, inclusief de uitzonderingen die vandaag het moeilijkst te verwerken zijn.