Arricchimento conoscenza: AI aziendale
L'arricchimento della conoscenza rende i contenuti aziendali non strutturati affidabili, contestuali e pronti per l'AI, per la ricerca e l'automazione.
L’AI aziendale raramente fallisce perché un’organizzazione ha troppo poco contenuto. Fallisce perché il contenuto è difficile da interpretare. Le policy convivono con bozze superate, le fatture arrivano come scansioni, i contratti usano nomi incoerenti e il contesto importante resta intrappolato nelle cartelle o nella testa dei dipendenti.
L’arricchimento della conoscenza trasforma quei contenuti non strutturati in informazioni affidabili che le persone e i sistemi di AI possono usare con fiducia. Aggiunge struttura, metadati, entità riconosciute, relazioni, provenienza e contesto aziendale, preservando al contempo il documento di origine. Il risultato non è semplicemente un tag migliore. È un livello di significato governato che migliora la ricerca, l’automazione, l’analisi e il lavoro assistito dall’AI.
Punti chiave
- L’arricchimento della conoscenza collega i contenuti al loro significato aziendale, non solo alle proprietà del file.
- Una pipeline pratica combina acquisizione, normalizzazione, classificazione, estrazione, riconoscimento delle entità, collegamento contestuale e validazione.
- Un contesto migliore migliora il recupero, riduce la preparazione manuale e offre agli agenti AI confini più sicuri.
- La governance resta essenziale perché l’arricchimento da solo non decide autorità, accesso, conservazione o uso consentito.
- Il miglior punto di partenza è un processo delimitato con un risultato misurabile, non un programma di etichettatura esteso a tutta l’azienda.
Cos’è l’arricchimento della conoscenza?
L’arricchimento della conoscenza è il processo che rende comprensibile nel contesto il contenuto non strutturato. Un repository di base può sapere che un file è un PDF, chi lo ha caricato e quando è cambiato. Un sistema arricchito può anche sapere che il file è un accordo con un fornitore firmato, che Acme Trading e ACME Ltd. si riferiscono alla stessa organizzazione, che l’accordo governa un particolare ordine d’acquisto e che la sua data di rinnovo si sta avvicinando.
Questa distinzione è importante. I metadati del file descrivono il contenitore. La conoscenza arricchita descrive cosa significa il contenuto e come si collega al lavoro.
| Livello | Domanda a cui risponde | Esempio |
|---|---|---|
| Metadati tecnici | Cos’è il file? | PDF, 18 pagine, creato il 12 agosto |
| Metadati descrittivi | Di cosa tratta? | Accordo con un fornitore per i servizi di gestione immobiliare |
| Entità estratte | Quali oggetti aziendali compaiono? | Fornitore, responsabile del contratto, giurisdizione, data di rinnovo |
| Relazioni | Come si collega? | Governa l’ordine PO-1842 e sostituisce l’accordo C-118 |
| Contesto di governance | Come può essere usato? | Gruppo di accesso legale, regola di conservazione di sette anni |
| Contesto operativo | Cosa deve succedere dopo? | Avvisare il responsabile 90 giorni prima del rinnovo |
Ecco perché l’arricchimento della conoscenza è più della classificazione dei documenti. La classificazione stabilisce cos’è un documento. L’arricchimento costruisce il contesto più ampio necessario per trovarlo, confrontarlo, ragionarci sopra e attivare l’azione giusta.
Arricchimento della conoscenza contro arricchimento dei dati
I termini suonano simili, ma risolvono problemi diversi.
L’arricchimento dei dati in genere migliora un record strutturato aggiungendo valori noti. Un record cliente può acquisire un codice di settore, una regione geografica o una dimensione aziendale da un altro database.
L’arricchimento della conoscenza parte da contenuti il cui significato non è già organizzato in righe e campi. Analizza un documento, un’email, un’immagine, una trascrizione o una presentazione, identifica ciò che conta e collega quel significato a una tassonomia, un oggetto aziendale, un processo o un knowledge graph.
Entrambi gli approcci migliorano la qualità delle informazioni. La differenza sta nel punto di partenza e nella profondità del contesto. L’arricchimento dei dati colma le lacune in uno schema. L’arricchimento della conoscenza aiuta a creare lo schema e le relazioni a partire da contenuti che non li avevano.
Come funziona la pipeline di arricchimento della conoscenza
Una pipeline affidabile preserva prima le evidenze, aggiunge significato a livelli e attiva solo la conoscenza validata. Questo evita che un'esperienza AI curata nasconda un contesto debole o controlli di accesso insufficienti.
Acquisire e preservare
Collegate repository approvati, email, scanner, applicazioni e archivi. Preservate l'originale, la posizione di origine, le marche temporali e la catena di custodia.
Output: contenuto di origine tracciabileNormalizzare il contenuto
Applicate l'OCR, suddividete i file composti, rilevate la lingua e standardizzate date, unità e formati senza cancellare la presentazione originale.
Output: contenuto elaborabileClassificare il documento
Identificate il tipo di documento e la categoria aziendale, così le regole corrette di estrazione, permessi e flusso di lavoro possono essere applicate con soglie di confidenza.
Output: classe documentale affidabileEstrarre metadati ed entità
Catturate i valori espliciti e riconoscete persone, organizzazioni, prodotti, luoghi, date, eventi e identificatori aziendali nei contenuti narrativi.
Output: fatti strutturatiRisolvere le relazioni
Normalizzate le varianti dei nomi in identità condivise e collegate i documenti a casi, clienti, asset, transazioni, policy e contenuti correlati.
Output: conoscenza connessaValidare e governare
Applicate regole aziendali, soglie di confidenza, permessi, mappatura della conservazione, revisione umana ed evidenza della versione del modello.
Output: conoscenza approvataAttivare la conoscenza
Riscrivete il contesto approvato nei sistemi di record e rendetelo disponibile per la ricerca aziendale, i flussi di lavoro, l'analisi, il RAG e gli agenti AI autorizzati.
Risultato: decisioni e processi miglioriPerché l’arricchimento della conoscenza è importante per l’AI aziendale
I modelli linguistici di grandi dimensioni sono fluenti, ma la fluenza non è autorevolezza. Un assistente aziendale deve recuperare la versione corretta della policy, rispettare i permessi dei documenti, distinguere una bozza da un accordo firmato e mostrare da dove proviene la sua risposta.
L’arricchimento della conoscenza migliora questo ambiente in quattro modi:
- Precisione del recupero. La ricerca può combinare la similarità semantica con tipo di documento, entità, stato del ciclo di vita, data di efficacia e regole di accesso.
- Qualità del grounding. L’AI riceve il passaggio pertinente insieme al contesto aziendale necessario per interpretarlo.
- Spiegabilità. Le risposte possono indicare una fonte approvata ed esporre i metadati o la relazione che le hanno generate.
- Sicurezza dell’azione. Gli agenti possono agire entro confini definiti, ad esempio avviando un flusso di rinnovo solo per un contratto firmato con una data validata.
Un assistente AI che recupera ogni file contenente “travel policy” potrebbe citare una bozza obsoleta. Un sistema arricchito può limitare il recupero alle policy approvate, alle versioni correnti, alla giurisdizione dell’utente e alla data di efficacia della domanda. Questa è la differenza tra testo plausibile e supporto operativo affidabile.
Applicazioni aziendali
L’arricchimento della conoscenza è utile ovunque volume di contenuti e contesto si incontrino.
| Funzione | Conoscenza arricchita | Impatto aziendale |
|---|---|---|
| Contabilità fornitori | Fornitore, numero fattura, ordine d’acquisto, importo, imposta, stato di approvazione | Riconciliazione più rapida e meno interventi manuali |
| Gestione dei contratti | Parti, clausole, obblighi, date, accordi correlati | Azione di rinnovo anticipata e revisione del rischio più chiara |
| Assicurazioni | Tipo di sinistro, polizza, luogo del danno, evidenza del danno, richiedente | Smistamento più rapido e fascicoli più completi |
| Sanità | Paziente, incontro clinico, tipo di documento, contesto clinico, sensibilità | Recupero migliore con controllo di accesso più rigoroso |
| Servizio clienti | Cliente, prodotto, problema, sentiment, caso precedente | Risposte più rapide con lo storico pertinente |
| Ingegneria | Asset, tipo di disegno, revisione, progetto, stato di approvazione | Meno tempo speso a trovare il record tecnico corrente |
Lo schema comune è che un documento diventa più prezioso quando il suo significato può viaggiare con esso. Questo supporta la gestione documentale e dei contenuti riducendo al contempo l’etichettatura manuale che fa arenare molti programmi di repository.
Una roadmap di implementazione pratica
Costruite fiducia in sei fasi controllate. Ogni fase crea l'evidenza e le protezioni necessarie per la successiva.
Definire una decisione, non un obiettivo tecnologico
Scegliete un risultato misurabile, come ridurre i tempi di revisione dei contratti, migliorare la riconciliazione delle fatture al primo passaggio o aumentare le ricerche self-service riuscite. Documentate la baseline e il costo di un risultato errato.
Stabilire un contratto minimo di metadati
Elencate l'insieme minimo di campi e relazioni richiesti per il caso d'uso. Contrassegnate i valori obbligatori, la fonte autorevole e la soglia di confidenza che consente l'automazione.
Testare contenuti rappresentativi
Includete scansioni di scarsa qualità, tipi di documento rari, più lingue, aggiunte manoscritte, documenti lunghi ed eccezioni reali. Misurate la precisione e il richiamo a livello di campo, non un singolo punteggio medio.
Aggiungere revisione umana dove il rischio lo richiede
Instradate i risultati incerti in base a soglie di confidenza. Catturate ogni correzione e la sua motivazione, così che modelli, regole e tassonomia migliorino senza trasformare la revisione in un lavoro di pulizia nascosto.
Integrare con il sistema di record
Usate identificatori stabili e API documentate. Prevenite la riscrittura duplicata, definite il comportamento di retry e mantenete una traccia da ogni valore arricchito fino alla sua fonte.
Monitorare nel tempo la qualità della conoscenza
Monitorate eccezioni, valori non supportati, deriva della tassonomia, successo del recupero, sforzo dei revisori e correzioni a valle. Rivalidate quando una fonte, un modello, una policy o un processo cambia.
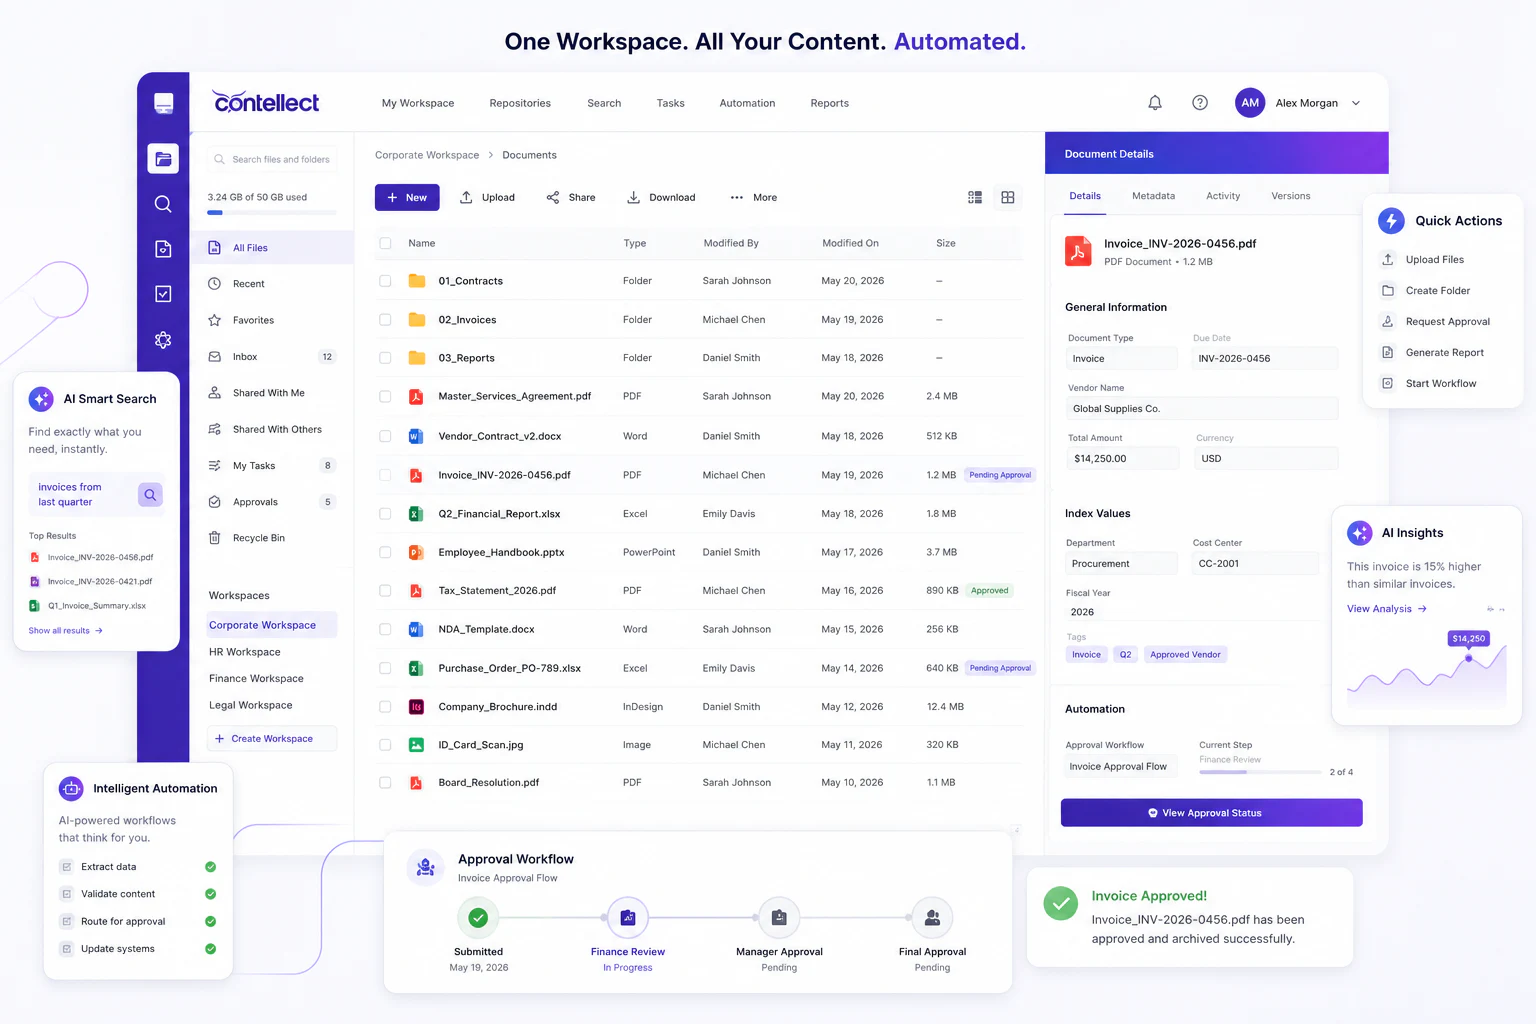
Collegamento con la piattaforma: Contellect One combina l'acquisizione intelligente dei dati, la gestione dei contenuti e il flusso di lavoro, così l'arricchimento può passare dalla previsione all'azione governata.
Metriche che rivelano il valore reale
Non valutate l’arricchimento solo in base a quanti tag genera un modello. Usate metriche legate alla qualità e ai risultati:
- precisione e richiamo a livello di campo per i metadati critici;
- accuratezza della risoluzione delle entità;
- percentuale di contenuti elaborati senza revisione;
- minuti di revisione per documento;
- tasso di successo della ricerca e tempo per trovare una risposta autorevole;
- riduzione delle sottomissioni incomplete o delle correzioni a valle;
- percentuale di risposte AI con citazioni valide e autorizzate;
- tempo di ciclo del processo e costo per caso completato.
Un punteggio di estrazione elevato può coesistere con uno scarso valore aziendale se i dati arricchiti non raggiungono mai il flusso di lavoro, se gli utenti non possono fidarsene o se la fonte sbagliata resta contrassegnata come autorevole.
Rischi e controlli
Abbinate ogni modalità di errore nota a un controllo che possa essere testato, assegnato a un responsabile e verificato.
Falsa sicurezza
Richiedete punteggi di confidenza, regole di validazione e revisione umana per i campi rilevanti.
Fuga di permessi
Applicate i permessi della fonte durante l'indicizzazione e il recupero. Trattate i metadati arricchiti con la stessa sensibilità della loro fonte.
Provenienza poco chiara
Conservate la fonte, la versione del modello, l'ora di estrazione e lo storico delle correzioni per ogni valore derivato.
Deriva della tassonomia
Assegnate un responsabile e monitorate i valori nuovi o ambigui, invece di lasciare che le categorie si moltiplichino senza controllo.
Prestazioni disomogenee
Testate su tipi di documento, lingue, canali e gruppi interessati. Una media elevata può nascondere un caso debole.
Azioni degli agenti non governate
Separate il recupero dall'autorità di agire. Usate approvazioni, strumenti con ambito limitato, limiti di transazione e risultati verificabili.
Dal volume di contenuti alla conoscenza utilizzabile
L’arricchimento della conoscenza non rende ogni documento ugualmente prezioso e non elimina la necessità della governance. Offre a un’organizzazione un modo disciplinato per trasformare contenuti dispersi in evidenze contestuali che ricerca, flussi di lavoro, persone e AI possono utilizzare.
Iniziate in piccolo: un processo, un insieme di contenuti, un contratto minimo di metadati e un risultato misurabile. Una volta che i controlli funzionano, riutilizzate la pipeline su più repository e casi d’uso. Questo crea contenuti aziendali pronti per l’AI, senza trasformare l’arricchimento in un altro progetto di dati incontrollato.
Se volete testare questo approccio sui vostri documenti, contattate il team Contellect e portate un campione rappresentativo, comprese le eccezioni più difficili da elaborare oggi.