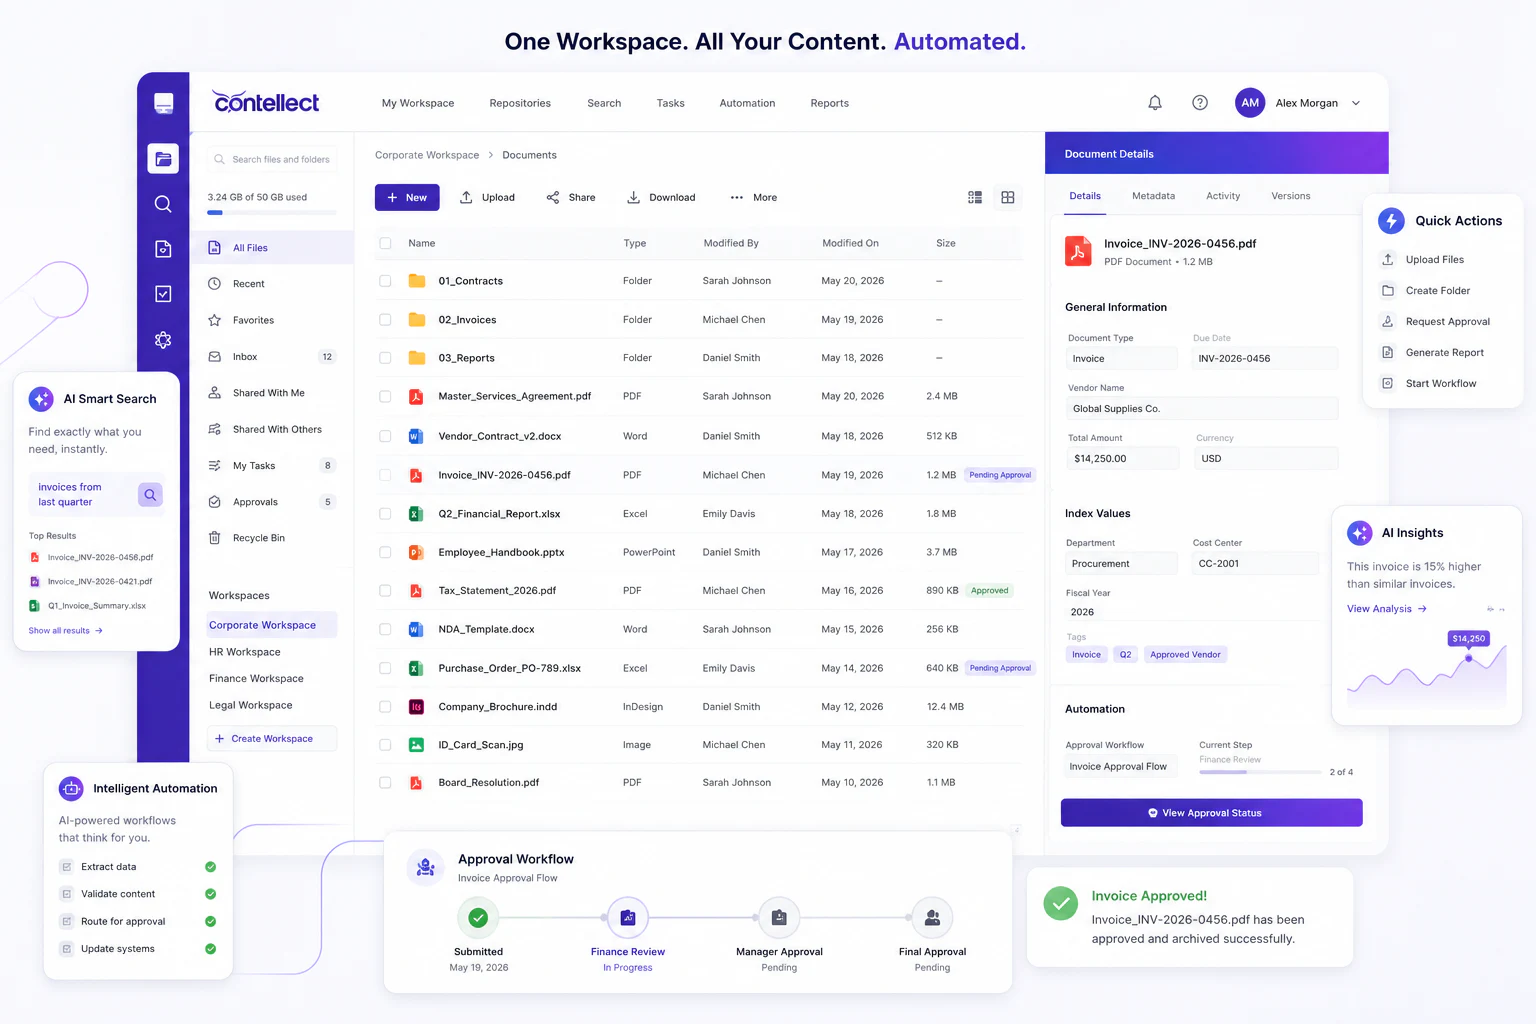
Enrichissement des connaissances pour l'IA
L'enrichissement des connaissances rend le contenu non structuré fiable, contextuel et prêt pour l'IA, la recherche et l'automatisation en entreprise.
L’IA d’entreprise échoue rarement parce qu’une organisation manque de contenu. Elle échoue parce que le contenu est difficile à interpréter. Les politiques côtoient des versions provisoires dépassées, les factures arrivent sous forme de scans, les contrats utilisent des noms incohérents, et un contexte important reste enfermé dans des dossiers ou dans la tête des employés.
L’enrichissement des connaissances transforme ce contenu non structuré en informations que les personnes et les systèmes d’IA peuvent utiliser en toute confiance. Il ajoute de la structure, des métadonnées, des entités reconnues, des relations, une provenance et un contexte métier, tout en préservant le document source. Le résultat n’est pas simplement une meilleure étiquette. C’est une couche de sens gouvernée qui améliore la recherche, l’automatisation, l’analytique et le travail assisté par l’IA.
Points clés à retenir
- L’enrichissement des connaissances relie le contenu à son sens métier, pas seulement à ses propriétés de fichier.
- Un pipeline pratique combine la capture, la normalisation, la classification, l’extraction, la reconnaissance d’entités, la mise en relation contextuelle et la validation.
- Un meilleur contexte améliore la récupération, réduit la préparation manuelle et donne aux agents d’IA des limites plus sûres.
- La gouvernance reste essentielle car l’enrichissement ne décide pas seul de l’autorité, de l’accès, de la conservation ou de l’usage acceptable.
- Le meilleur point de départ est un processus circonscrit avec un résultat mesurable, et non un programme de balisage à l’échelle de l’entreprise.
Qu’est-ce que l’enrichissement des connaissances ?
L’enrichissement des connaissances est le processus qui rend le contenu non structuré compréhensible dans son contexte. Un référentiel basique peut savoir qu’un fichier est un PDF, qui l’a téléversé et quand il a été modifié. Un système enrichi peut aussi savoir que le fichier est un contrat fournisseur signé, qu’Acme Trading et ACME Ltd. désignent la même organisation, que le contrat régit un bon de commande particulier, et que sa date de renouvellement approche.
Cette distinction compte. Les métadonnées du fichier décrivent le contenant. La connaissance enrichie décrit ce que le contenu signifie et comment il se rapporte au travail.
| Couche | Question à laquelle elle répond | Exemple |
|---|---|---|
| Métadonnées techniques | Qu’est-ce que le fichier ? | PDF, 18 pages, créé le 12 août |
| Métadonnées descriptives | De quoi s’agit-il ? | Contrat fournisseur pour services d’installations |
| Entités extraites | Quels objets métier apparaissent ? | Fournisseur, responsable du contrat, juridiction, date de renouvellement |
| Relations | Comment est-il lié ? | Régit le BC-1842 et remplace le contrat C-118 |
| Contexte de gouvernance | Comment peut-il être utilisé ? | Groupe d’accès juridique, règle de conservation de sept ans |
| Contexte opérationnel | Que doit-il se passer ensuite ? | Alerter le responsable 90 jours avant le renouvellement |
C’est pourquoi l’enrichissement des connaissances va au-delà de la classification documentaire. La classification détermine ce qu’est un document. L’enrichissement construit le contexte plus large nécessaire pour le trouver, le comparer, raisonner à son sujet et déclencher la bonne action.
Enrichissement des connaissances et enrichissement des données
Ces termes se ressemblent, mais ils résolvent des problèmes différents.
L’enrichissement des données améliore généralement un enregistrement structuré en y ajoutant des valeurs connues. Un enregistrement client peut ainsi recevoir un code sectoriel, une région géographique ou une taille d’entreprise provenant d’une autre base de données.
L’enrichissement des connaissances part d’un contenu dont le sens n’est pas déjà organisé en lignes et en champs. Il analyse un document, un courriel, une image, une transcription ou une présentation, identifie ce qui compte, et relie ce sens à une taxonomie, un objet métier, un processus ou un graphe de connaissances.
Les deux approches améliorent la qualité de l’information. La différence tient au point de départ et à la profondeur du contexte. L’enrichissement des données comble les lacunes d’un schéma. L’enrichissement des connaissances aide à créer le schéma et les relations à partir d’un contenu qui n’en disposait pas.
Comment fonctionne le pipeline d'enrichissement des connaissances
Un pipeline fiable préserve d'abord les preuves, ajoute du sens contextuel par couches, et n'active que la connaissance validée. Cela évite qu'une expérience d'IA soignée ne dissimule un contexte faible ou des contrôles d'accès insuffisants.
Ingérer et préserver
Connectez les référentiels approuvés, la messagerie, les scanners, les applications et les archives. Préservez l'original, l'emplacement source, les horodatages et la chaîne de conservation.
Résultat : contenu source traçableNormaliser le contenu
Appliquez l'OCR, séparez les fichiers composites, détectez la langue et normalisez les dates, unités et formats sans effacer la présentation d'origine.
Résultat : contenu exploitableClassifier le document
Identifiez le type de document et la catégorie métier afin que les règles d'extraction, de permission et de flux de travail appropriées puissent s'exécuter avec des seuils de confiance.
Résultat : classe de document fiableExtraire les métadonnées et les entités
Capturez les valeurs explicites et reconnaissez les personnes, organisations, produits, lieux, dates, événements et identifiants métier dans le contenu narratif.
Résultat : faits structurésRésoudre les relations
Normalisez les variantes de noms vers des identités partagées et reliez les documents aux dossiers, clients, actifs, transactions, politiques et contenus connexes.
Résultat : connaissance connectéeValider et gouverner
Appliquez des règles métier, des seuils de confiance, des permissions, une correspondance de conservation, une révision humaine et des preuves de version de modèle.
Résultat : connaissance approuvéeActiver la connaissance
Réinscrivez le contexte approuvé dans les systèmes d'enregistrement et rendez-le disponible, prêt pour la recherche d'entreprise, les flux de travail, l'analytique, le RAG et les agents d'IA autorisés.
Résultat final : de meilleures décisions et de meilleurs processusPourquoi l’enrichissement des connaissances compte pour l’IA d’entreprise
Les grands modèles de langage sont fluides, mais la fluidité n’est pas l’autorité. Un assistant d’entreprise doit récupérer la bonne version d’une politique, respecter les permissions des documents, distinguer une version provisoire d’un contrat signé, et montrer d’où provient sa réponse.
L’enrichissement des connaissances améliore cet environnement de quatre façons :
- Précision de la récupération. La recherche peut combiner la similarité sémantique avec le type de document, l’entité, le statut de cycle de vie, la date d’effet et les règles d’accès.
- Qualité de l’ancrage. L’IA reçoit le passage pertinent ainsi que le contexte métier nécessaire pour l’interpréter.
- Explicabilité. Les réponses peuvent pointer vers une source approuvée et exposer la métadonnée ou la relation qui y a conduit.
- Sécurité de l’action. Les agents peuvent agir dans des limites définies, par exemple ne déclencher un flux de renouvellement que pour un contrat signé avec une date validée.
Un assistant d’IA qui récupère chaque fichier contenant « politique de voyage » peut citer une version provisoire obsolète. Un système enrichi peut restreindre la récupération aux politiques approuvées, aux versions actuelles, à la juridiction de l’utilisateur et à la date d’effet de la question. C’est la différence entre un texte plausible et un support opérationnel fiable.
Applications métier
L’enrichissement des connaissances est utile partout où le volume de contenu et le contexte se rencontrent.
| Fonction | Connaissance enrichie | Impact métier |
|---|---|---|
| Comptes fournisseurs | Fournisseur, numéro de facture, bon de commande, montant, taxe, statut d’approbation | Rapprochement plus rapide et moins d’interventions manuelles |
| Gestion des contrats | Parties, clauses, obligations, dates, contrats liés | Action de renouvellement anticipée et revue des risques plus claire |
| Assurance | Type de sinistre, police, lieu du sinistre, preuves de dommages, assuré | Triage plus rapide et dossiers plus complets |
| Santé | Patient, consultation, type de document, contexte clinique, sensibilité | Meilleure récupération avec un contrôle d’accès plus strict |
| Service client | Client, produit, problème, sentiment, dossier antérieur | Réponses plus rapides avec l’historique pertinent |
| Ingénierie | Actif, type de plan, révision, projet, statut d’approbation | Moins de temps passé à retrouver le dossier technique à jour |
Le principe commun est qu’un document prend plus de valeur lorsque son sens peut l’accompagner. Cela soutient la gestion des documents et des contenus tout en réduisant le balisage manuel qui bloque de nombreux programmes de référentiels.
Une feuille de route pratique de mise en œuvre
Construisez la confiance en six étapes contrôlées. Chaque étape crée les preuves et les garde-fous nécessaires à la suivante.
Définir une décision, pas une cible technologique
Choisissez un résultat mesurable, comme réduire le temps de revue des contrats, améliorer le rapprochement des factures dès le premier passage, ou augmenter le taux de réussite des recherches en libre-service. Documentez la référence de départ et le coût d'un résultat incorrect.
Établir un contrat de métadonnées minimal
Recensez le plus petit ensemble de champs et de relations requis pour le cas d'usage. Marquez les valeurs obligatoires, la source faisant autorité et le seuil de confiance qui permet l'automatisation.
Tester un contenu représentatif
Incluez des scans de mauvaise qualité, des types de documents rares, plusieurs langues, des ajouts manuscrits, des documents longs et de véritables exceptions. Mesurez la précision et le rappel au niveau des champs, pas un score moyen unique.
Ajouter une révision humaine là où le risque l'exige
Orientez les résultats incertains selon des seuils de confiance. Enregistrez chaque correction et sa raison afin que les modèles, les règles et la taxonomie s'améliorent, sans transformer la révision en nettoyage caché.
Intégrer avec le système d'enregistrement
Utilisez des identifiants stables et des API documentées. Évitez les réécritures en double, définissez le comportement en cas de nouvelle tentative, et conservez une trace de chaque valeur enrichie jusqu'à sa source.
Surveiller la qualité des connaissances dans le temps
Suivez les exceptions, les valeurs non prises en charge, la dérive de la taxonomie, le taux de réussite de la récupération, l'effort des réviseurs et les corrections en aval. Revalidez lorsqu'une source, un modèle, une politique ou un processus change.
Lien avec la plateforme : Contellect One combine la capture intelligente de données, la gestion de contenu et le flux de travail afin que l'enrichissement puisse passer de la prédiction à l'action gouvernée.
Indicateurs qui révèlent la valeur réelle
N’évaluez pas l’enrichissement uniquement au nombre d’étiquettes qu’un modèle crée. Utilisez des mesures liées à la qualité et aux résultats :
- précision et rappel au niveau des champs pour les métadonnées critiques ;
- exactitude de la résolution d’entités ;
- pourcentage de contenu traité sans révision ;
- minutes de révision par document ;
- taux de réussite des recherches et temps pour trouver une réponse faisant autorité ;
- réduction des soumissions incomplètes ou des corrections en aval ;
- pourcentage de réponses d’IA avec des citations valides et autorisées ;
- temps de cycle du processus et coût par dossier terminé.
Un score d’extraction élevé peut coexister avec une faible valeur métier si les données enrichies n’atteignent jamais le flux de travail, si les utilisateurs ne peuvent pas leur faire confiance, ou si la mauvaise source reste marquée comme faisant autorité.
Risques et contrôles
Associez chaque mode de défaillance connu à un contrôle qui peut être testé, attribué et audité.
Fausse confiance
Exigez des scores de confiance, des règles de validation et une révision humaine pour les champs à fort impact.
Fuite de permissions
Appliquez les permissions de la source lors de l'indexation et de la récupération. Traitez les métadonnées enrichies avec la même sensibilité que leur source.
Provenance incertaine
Conservez la source, la version du modèle, l'horodatage d'extraction et l'historique des corrections pour chaque valeur dérivée.
Dérive de la taxonomie
Attribuez un propriétaire et surveillez les valeurs nouvelles ou ambiguës plutôt que de laisser les catégories se multiplier sans contrôle.
Performance inégale
Testez selon les types de documents, les langues, les canaux et les groupes concernés. Une bonne moyenne peut masquer un cas faible.
Actions d'agents non gouvernées
Séparez la récupération de l'autorité d'agir. Utilisez des approbations, des outils à portée limitée, des plafonds de transaction et des résultats auditables.
Du volume de contenu à une connaissance exploitable
L’enrichissement des connaissances ne rend pas chaque document également précieux, et il ne supprime pas le besoin de gouvernance. Il donne à une organisation une méthode disciplinée pour transformer un contenu dispersé en preuves contextuelles que la recherche, les flux de travail, les personnes et l’IA peuvent utiliser.
Commencez modestement : un processus, un ensemble de contenu, un contrat de métadonnées minimal et un résultat mesurable. Une fois les contrôles opérationnels, réutilisez le pipeline sur davantage de référentiels et de cas d’usage. Cela crée une base d’information prête pour l’IA sans transformer l’enrichissement en un nouveau projet de données incontrôlé.
Si vous souhaitez tester cette approche sur vos propres documents, contactez l’équipe Contellect et apportez un échantillon représentatif, y compris les exceptions les plus difficiles à traiter aujourd’hui.