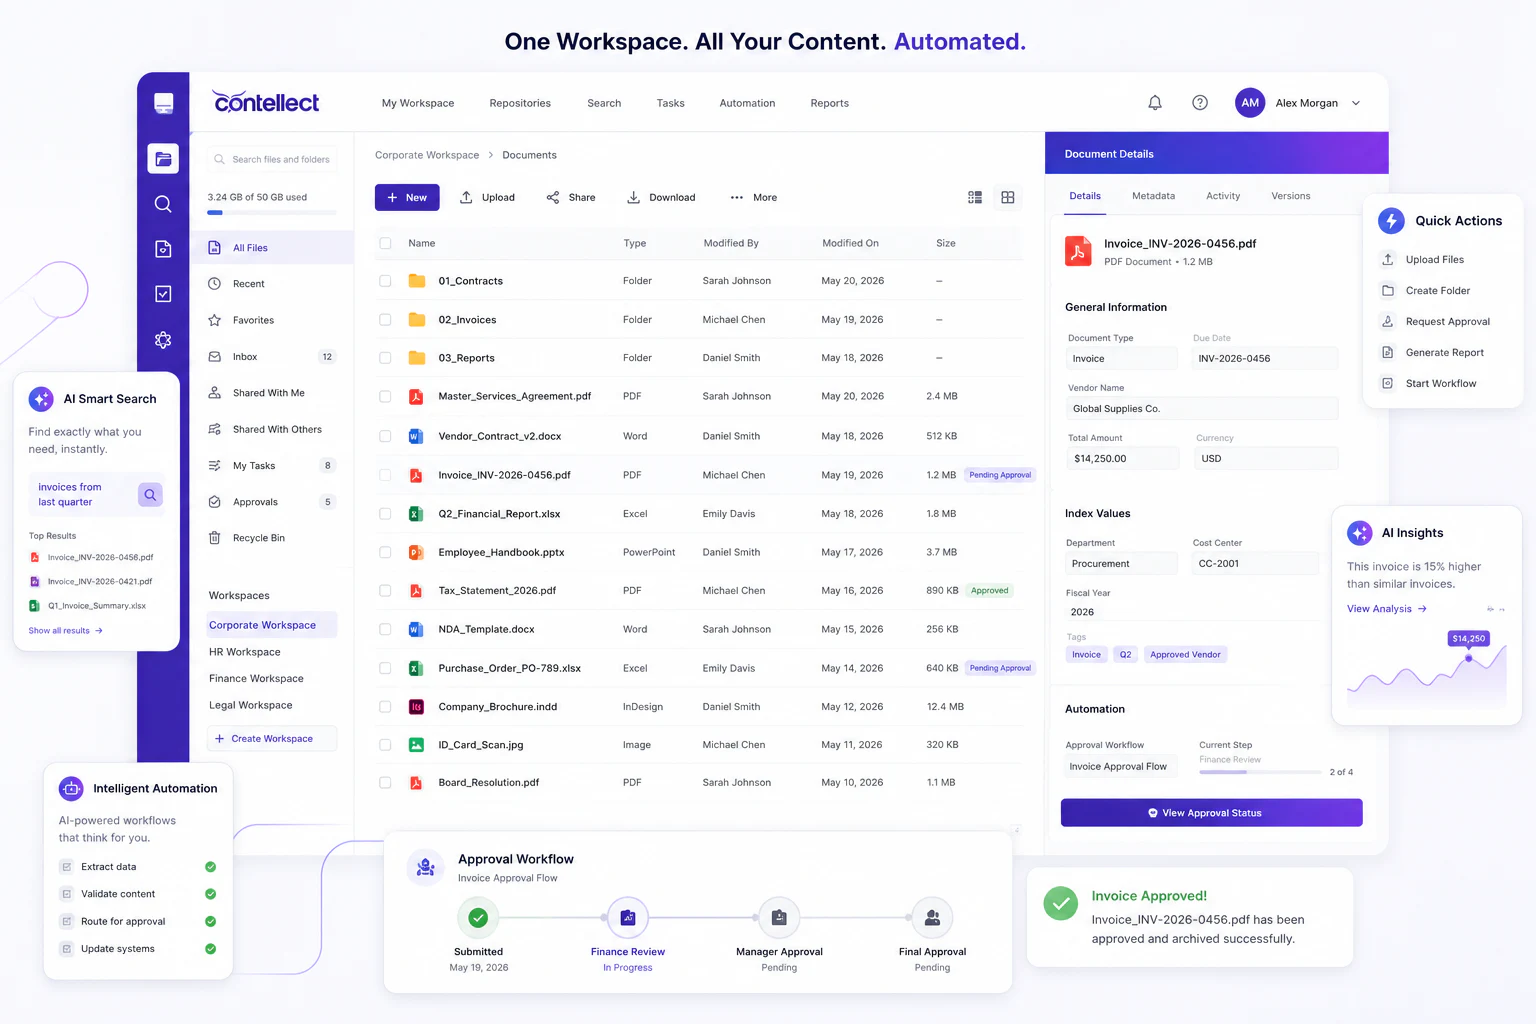
Wissensanreicherung für Unternehmens-KI
Wie Wissensanreicherung unstrukturierten Inhalt in verlässliche, kontextbezogene und KI-taugliche Informationen für Suche und Automatisierung verwandelt.
Unternehmens-KI scheitert selten, weil eine Organisation zu wenig Inhalt hat. Sie scheitert, weil der Inhalt schwer zu interpretieren ist. Richtlinien liegen neben überholten Entwürfen, Rechnungen kommen als Scans, Verträge verwenden uneinheitliche Namen, und wichtiger Kontext bleibt in Ordnern oder in den Köpfen der Mitarbeiter gefangen.
Wissensanreicherung verwandelt diesen unstrukturierten Inhalt in Informationen, die Menschen und KI-Systeme mit Vertrauen nutzen können. Sie fügt Struktur, Metadaten, erkannte Entitäten, Beziehungen, Herkunft und Geschäftskontext hinzu, während das Ausgangsdokument erhalten bleibt. Das Ergebnis ist nicht einfach ein besseres Tag. Es ist eine gesteuerte, kontextbezogene Bedeutungsschicht, die Suche, Automatisierung, Analysen und KI-gestützte Arbeit verbessert.
Die wichtigsten Erkenntnisse
- Wissensanreicherung verbindet Inhalte mit ihrer geschäftlichen Bedeutung, nicht nur mit ihren Dateieigenschaften.
- Eine praktische Pipeline kombiniert Erfassung, Normalisierung, Klassifizierung, Extraktion, Entitätserkennung, kontextuelle Verknüpfung und Validierung.
- Besserer Kontext verbessert das Retrieval, reduziert manuelle Vorbereitung und gibt KI-Agenten sicherere Grenzen.
- Governance bleibt unerlässlich, denn Anreicherung entscheidet nicht von sich aus über Autorität, Zugriff, Aufbewahrung oder zulässige Nutzung.
- Der beste Ausgangspunkt ist ein abgegrenzter Prozess mit einem messbaren Ergebnis, kein unternehmensweites Tagging-Programm.
Was ist Wissensanreicherung?
Wissensanreicherung ist der Prozess, unstrukturierte Inhalte im Kontext verständlich zu machen. Ein einfaches Repository weiß vielleicht, dass eine Datei ein PDF ist, wer sie hochgeladen hat und wann sie geändert wurde. Ein angereichertes System kann darüber hinaus wissen, dass die Datei ein unterzeichneter Liefervertrag ist, dass Acme Trading und ACME Ltd. dieselbe Organisation bezeichnen, dass der Vertrag eine bestimmte Bestellung regelt und dass sein Verlängerungsdatum naht.
Dieser Unterschied ist wichtig. Datei-Metadaten beschreiben den Container. Angereichertes Wissen beschreibt, was der Inhalt bedeutet und wie er sich auf die Arbeit bezieht.
| Ebene | Beantwortete Frage | Beispiel |
|---|---|---|
| Technische Metadaten | Was ist die Datei? | PDF, 18 Seiten, erstellt am 12. August |
| Beschreibende Metadaten | Worum geht es? | Liefervertrag für Facility-Services |
| Extrahierte Entitäten | Welche Geschäftsobjekte kommen vor? | Lieferant, Vertragsverantwortlicher, Gerichtsbarkeit, Verlängerungsdatum |
| Beziehungen | Wie ist es verknüpft? | Regelt PO-1842 und ersetzt Vertrag C-118 |
| Governance-Kontext | Wie darf es genutzt werden? | Legal-Zugriffsgruppe, siebenjährige Aufbewahrungsregel |
| Operativer Kontext | Was sollte als Nächstes geschehen? | Verantwortlichen 90 Tage vor Verlängerung benachrichtigen |
Deshalb ist Wissensanreicherung mehr als Dokumentenklassifizierung. Klassifizierung legt fest, was ein Dokument ist. Anreicherung baut den weiteren Kontext auf, der nötig ist, um es zu finden, zu vergleichen, darüber zu schlussfolgern und die richtige Aktion auszulösen.
Wissensanreicherung im Vergleich zu Datenanreicherung
Die Begriffe klingen ähnlich, lösen aber unterschiedliche Probleme.
Datenanreicherung verbessert typischerweise einen strukturierten Datensatz, indem sie bekannte Werte ergänzt. Ein Kundendatensatz kann aus einer anderen Datenbank einen Branchencode, eine geografische Region oder eine Unternehmensgröße erhalten.
Wissensanreicherung beginnt mit Inhalten, deren Bedeutung noch nicht in Zeilen und Feldern geordnet ist. Sie analysiert ein Dokument, eine E-Mail, ein Bild, ein Transkript oder eine Präsentation, erkennt, was wichtig ist, und verbindet diese Bedeutung mit einer Taxonomie, einem Geschäftsobjekt, einem Prozess oder einem Wissensgraphen.
Beide Ansätze verbessern die Informationsqualität. Der Unterschied liegt im Ausgangspunkt und in der Tiefe des Kontexts. Datenanreicherung füllt Lücken in einem Schema. Wissensanreicherung hilft, das Schema und die Beziehungen aus Inhalten zu erschaffen, die sie zuvor nicht hatten.
Wie die Wissensanreicherungs-Pipeline funktioniert
Eine verlässliche Pipeline bewahrt zuerst die Nachweise, fügt Bedeutung in Schichten hinzu und aktiviert nur validiertes Wissen. Das verhindert, dass eine ausgefeilte KI-Erfahrung schwachen Kontext oder schwache Zugriffskontrollen darunter verbirgt.
Erfassen und bewahren
Verbinden Sie freigegebene Repositorys, E-Mail, Scanner, Anwendungen und Archive. Bewahren Sie das Original, den Quellort, Zeitstempel und die Verwahrungskette.
Ergebnis: nachvollziehbarer QuellinhaltInhalt normalisieren
Wenden Sie OCR an, teilen Sie zusammengesetzte Dateien, erkennen Sie die Sprache und vereinheitlichen Sie Daten, Einheiten und Formate, ohne die ursprüngliche Darstellung zu zerstören.
Ergebnis: verarbeitbarer InhaltDokument klassifizieren
Bestimmen Sie Dokumenttyp und Geschäftskategorie, damit die richtigen Extraktions-, Berechtigungs- und Workflow-Regeln mit Konfidenzschwellenwerten laufen können.
Ergebnis: geprüfte DokumentklasseMetadaten und Entitäten extrahieren
Erfassen Sie explizite Werte und erkennen Sie Personen, Organisationen, Produkte, Orte, Daten, Ereignisse und Geschäftskennungen im Fließtext.
Ergebnis: strukturierte FaktenBeziehungen auflösen
Vereinheitlichen Sie Namensvarianten zu gemeinsamen Identitäten und verknüpfen Sie Dokumente mit Fällen, Kunden, Anlagen, Transaktionen, Richtlinien und verwandten Inhalten.
Ergebnis: vernetztes WissenValidieren und steuern
Wenden Sie Geschäftsregeln, Konfidenzschwellenwerte, Berechtigungen, Aufbewahrungszuordnung, menschliche Prüfung und Modellversionsnachweise an.
Ergebnis: freigegebenes WissenWissen aktivieren
Schreiben Sie freigegebenen Kontext zurück in Systems of Record und stellen Sie ihn für Unternehmenssuche, Workflows, Analysen, RAG und autorisierte KI-Agenten bereit.
Ergebnis: bessere Entscheidungen und ProzesseWarum Wissensanreicherung für Unternehmens-KI wichtig ist
Große Sprachmodelle sind sprachgewandt, aber Gewandtheit ist keine Autorität. Ein Unternehmensassistent muss die richtige Richtlinienversion abrufen, Dokumentberechtigungen respektieren, einen Entwurf von einem unterzeichneten Vertrag unterscheiden und zeigen, woher seine Antwort stammt.
Wissensanreicherung verbessert dieses Umfeld auf vier Arten:
- Retrieval-Präzision. Die Suche kann semantische Ähnlichkeit mit Dokumenttyp, Entität, Lebenszyklusstatus, Gültigkeitsdatum und Zugriffsregeln kombinieren.
- Grounding-Qualität. Die KI erhält die relevante Passage sowie den Geschäftskontext, der zu ihrer Interpretation nötig ist.
- Erklärbarkeit. Antworten können auf eine freigegebene Quelle verweisen und die Metadaten oder Beziehung offenlegen, die zu ihr geführt haben.
- Aktionssicherheit. Agenten können innerhalb festgelegter Grenzen handeln, etwa einen Verlängerungs-Workflow nur für einen unterzeichneten Vertrag mit validiertem Datum zu starten.
Ein KI-Assistent, der jede Datei abruft, die “Reiserichtlinie” enthält, kann einen veralteten Entwurf zitieren. Ein angereichertes System kann das Retrieval auf freigegebene Richtlinien, aktuelle Versionen, die Gerichtsbarkeit des Nutzers und das Gültigkeitsdatum der Frage beschränken. Das ist der Unterschied zwischen plausiblem Text und verlässlicher operativer Unterstützung.
Geschäftsanwendungen
Wissensanreicherung ist überall nützlich, wo Inhaltsvolumen und Kontext zusammentreffen.
| Funktion | Angereichertes Wissen | Geschäftlicher Nutzen |
|---|---|---|
| Kreditorenbuchhaltung | Lieferant, Rechnungsnummer, Bestellung, Betrag, Steuer, Freigabestatus | Schnellerer Abgleich und weniger manuelle Eingriffe |
| Vertragsverwaltung | Parteien, Klauseln, Pflichten, Termine, verwandte Verträge | Frühzeitigere Verlängerungsmaßnahmen und klarere Risikoprüfung |
| Versicherung | Schadenart, Police, Schadenort, Schadensnachweis, Anspruchsteller | Schnellere Triage und vollständigere Fallakten |
| Gesundheitswesen | Patient, Behandlungsfall, Dokumenttyp, klinischer Kontext, Sensibilität | Besseres Retrieval mit strengerer Zugriffskontrolle |
| Kundenservice | Kunde, Produkt, Anliegen, Stimmung, früherer Fall | Schnellere Antworten mit relevanter Historie |
| Engineering | Anlage, Zeichnungstyp, Revision, Projekt, Freigabestatus | Weniger Zeitaufwand, um den aktuellen technischen Datensatz zu finden |
Das gemeinsame Muster ist, dass ein Dokument wertvoller wird, wenn seine Bedeutung mit ihm reisen kann. Das unterstützt Dokumenten- und Content-Management und reduziert zugleich das manuelle Tagging, an dem viele Repository-Programme ins Stocken geraten.
Eine praktische Roadmap zur Einführung
Bauen Sie Vertrauen in sechs kontrollierten Stufen auf. Jede Stufe schafft die Nachweise und Leitplanken, die für die nächste nötig sind.
Eine Entscheidung festlegen, kein Technologieziel
Wählen Sie ein messbares Ergebnis, etwa die Verkürzung der Vertragsprüfungszeit, eine bessere Erstabgleichsquote bei Rechnungen oder mehr erfolgreiche Self-Service-Suchen. Dokumentieren Sie die Ausgangslage und die Kosten eines falschen Ergebnisses.
Einen Mindest-Metadatenvertrag festlegen
Listen Sie die kleinste Menge an Feldern und Beziehungen auf, die für den Anwendungsfall nötig sind. Kennzeichnen Sie Pflichtwerte, die maßgebliche Quelle und den Konfidenzschwellenwert, der Automatisierung erlaubt.
Repräsentative Inhalte testen
Beziehen Sie schlechte Scans, seltene Dokumenttypen, mehrere Sprachen, handschriftliche Ergänzungen, lange Dokumente und echte Ausnahmen ein. Messen Sie Präzision und Trefferquote auf Feldebene, nicht einen einzelnen Durchschnittswert.
Menschliche Prüfung ergänzen, wo Risiko es verlangt
Leiten Sie unsichere Ergebnisse anhand von Konfidenzschwellenwerten weiter. Erfassen Sie jede Korrektur und ihren Grund, damit Modelle, Regeln und Taxonomie sich verbessern, ohne dass Prüfung zu verdeckter Aufräumarbeit wird.
Mit dem System of Record integrieren
Verwenden Sie stabile Kennungen und dokumentierte APIs. Verhindern Sie doppeltes Zurückschreiben, definieren Sie Wiederholungsverhalten und bewahren Sie eine Nachverfolgung von jedem angereicherten Wert bis zu seiner Quelle.
Wissensqualität dauerhaft überwachen
Verfolgen Sie Ausnahmen, nicht belegte Werte, Taxonomie-Drift, Retrieval-Erfolg, Prüferaufwand und nachgelagerte Korrekturen. Validieren Sie erneut, wenn sich eine Quelle, ein Modell, eine Richtlinie oder ein Prozess ändert.
Plattformverbindung: Contellect One kombiniert intelligente Datenerfassung, Content-Management und Workflow, sodass Anreicherung von der Vorhersage zur gesteuerten Aktion übergehen kann.
Kennzahlen, die den wirklichen Wert zeigen
Bewerten Sie Anreicherung nicht nur danach, wie viele Tags ein Modell erzeugt. Verwenden Sie Kennzahlen, die an Qualität und Ergebnisse gebunden sind:
- Präzision und Trefferquote auf Feldebene für kritische Metadaten;
- Genauigkeit der Entitätsauflösung;
- Anteil der Inhalte, die ohne Prüfung verarbeitet werden;
- Prüferminuten pro Dokument;
- Erfolgsquote der Suche und Zeit bis zu einer maßgeblichen Antwort;
- Rückgang unvollständiger Einreichungen oder nachgelagerter Korrekturen;
- Anteil der KI-Antworten mit gültigen, autorisierten Zitaten;
- Prozesszykluszeit und Kosten pro abgeschlossenem Fall.
Ein hoher Extraktionswert kann mit geringem Geschäftswert einhergehen, wenn die angereicherten Daten nie im Workflow ankommen, wenn Nutzer ihnen nicht vertrauen können oder wenn die falsche Quelle weiterhin als maßgeblich markiert bleibt.
Risiken und Kontrollen
Verbinden Sie jeden bekannten Fehlermodus mit einer Kontrolle, die getestet, verantwortet und geprüft werden kann.
Falsche Sicherheit
Verlangen Sie Konfidenzwerte, Validierungsregeln und menschliche Prüfung für folgenreiche Felder.
Berechtigungsleck
Setzen Sie Quellberechtigungen bei Indexierung und Retrieval durch. Behandeln Sie angereicherte Metadaten so sensibel wie ihre Quelle.
Unklare Herkunft
Speichern Sie Quelle, Modellversion, Extraktionszeitpunkt und Korrekturhistorie für jeden abgeleiteten Wert.
Taxonomie-Drift
Weisen Sie einen Verantwortlichen zu und überwachen Sie neue oder mehrdeutige Werte, statt Kategorien unkontrolliert wuchern zu lassen.
Uneinheitliche Leistung
Testen Sie über Dokumenttypen, Sprachen, Kanäle und betroffene Gruppen hinweg. Ein starker Durchschnitt kann einen schwachen Fall verbergen.
Ungesteuerte Agentenaktionen
Trennen Sie Retrieval von der Handlungsbefugnis. Verwenden Sie Freigaben, begrenzte Tools, Transaktionsgrenzen und auditierbare Ergebnisse.
Von Inhaltsvolumen zu nutzbarem Wissen
Wissensanreicherung macht nicht jedes Dokument gleich wertvoll, und sie beseitigt nicht die Notwendigkeit von Governance. Sie gibt einer Organisation einen disziplinierten Weg, verstreute Inhalte in kontextuelle Belege zu verwandeln, die Suche, Workflows, Menschen und KI nutzen können.
Fangen Sie klein an: ein Prozess, ein Inhaltsbestand, ein Mindest-Metadatenvertrag und ein messbares Ergebnis. Sobald die Kontrollen funktionieren, nutzen Sie die Pipeline für weitere Repositorys und Anwendungsfälle wieder. Das schafft eine KI-taugliche Informationsgrundlage, ohne Anreicherung in ein weiteres unkontrolliertes Datenprojekt zu verwandeln.
Wenn Sie diesen Ansatz an Ihren eigenen Dokumenten testen möchten, kontaktieren Sie das Contellect-Team und bringen Sie eine repräsentative Stichprobe mit, einschließlich der Ausnahmen, die heute am schwersten zu verarbeiten sind.