Wat is intelligente datavastlegging?
Wat intelligente datavastlegging is, en hoe AI-gestuurde automatisering handmatige gegevensinvoer vervangt binnen documentworkflows met een hoog volume.
Hoofdstuk 1: de basis begrijpen
Wat is intelligente datavastlegging?
Intelligente datavastlegging (IDC) is een geavanceerde technologie die kunstmatige intelligentie (AI), machine learning (ML) en natural language processing (NLP) gebruikt om data uit uiteenlopende documenttypen automatisch te identificeren, extraheren en structureren.
In tegenstelling tot traditionele oplossingen die documentafbeeldingen simpelweg omzetten in ruwe tekst, “begrijpen” IDC-systemen context. Ze maken onderscheid tussen een factuurtotaal en een telefoonnummer, zelfs wanneer documentformaten sterk verschillen.
De evolutie van tools voor gegevensautomatisering
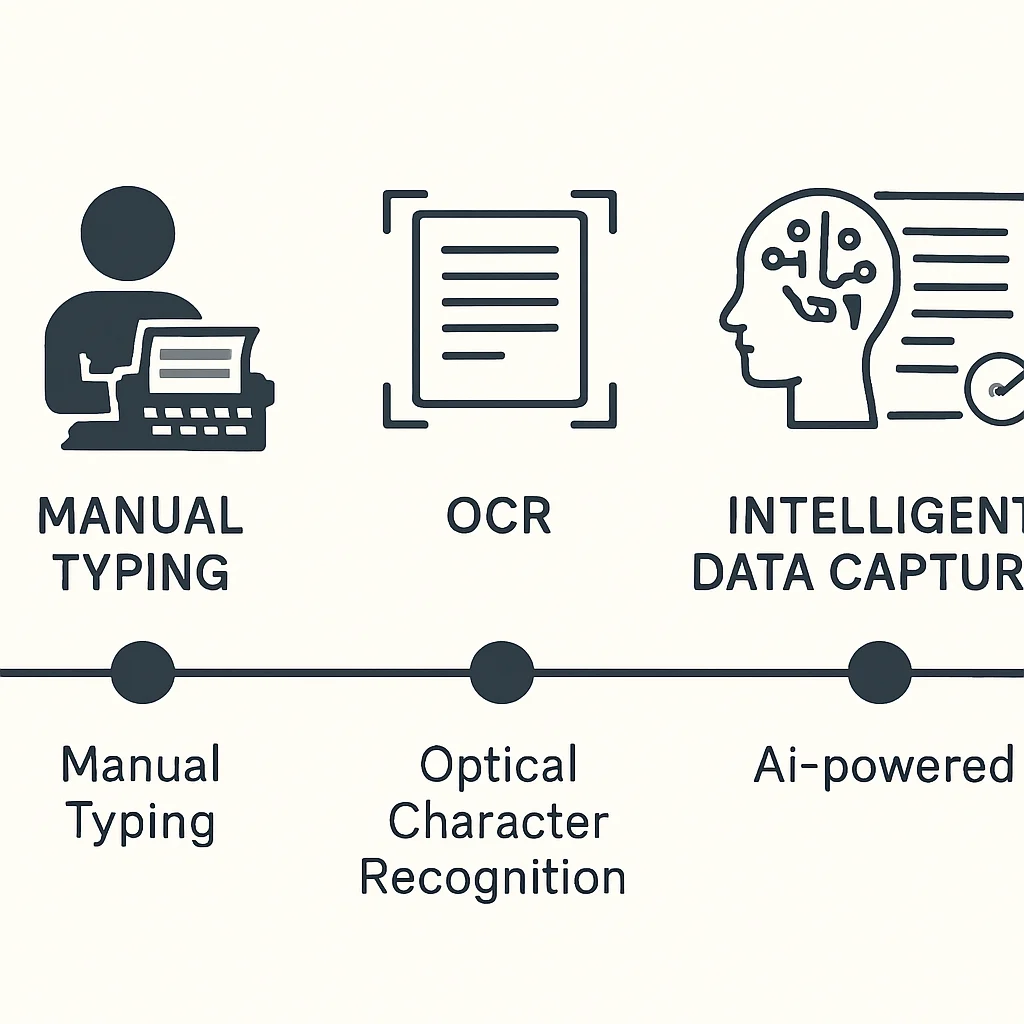
De weg hiernaartoe kende drie fasen:
- Handmatige gegevensinvoer: mensen die documenten fysiek lezen en informatie in databases typen - traag, duur en foutgevoelig.
- Traditionele OCR: software die tekens in afbeeldingen herkent. Sneller dan handmatige invoer, maar afhankelijk van rigide sjablonen die breken zodra documentlay-outs veranderen.
- Intelligente datavastlegging: de moderne standaard die OCR combineert met AI, die leert en zich aanpast zonder rigide sjablonen nodig te hebben.
Hoofdstuk 2: de kerntechnologie uitgelegd
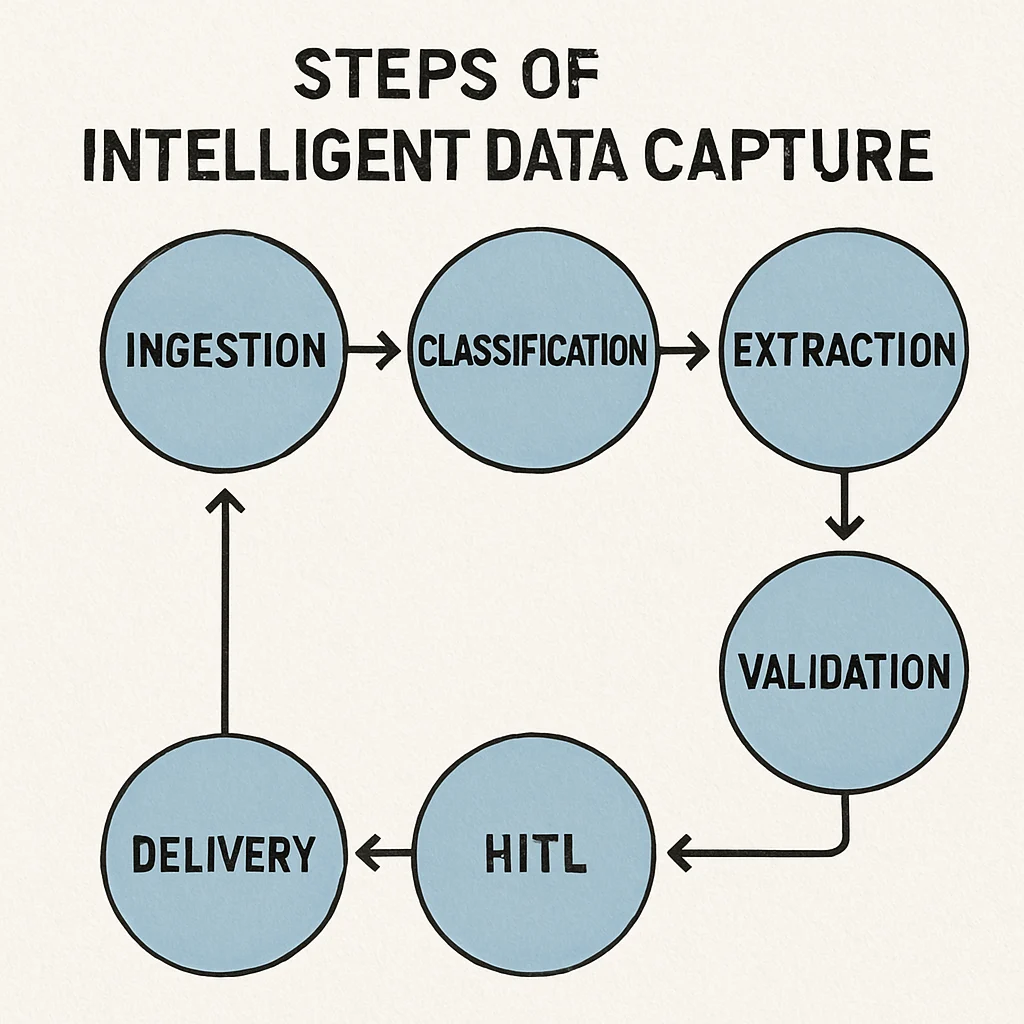
Stap 1: multichannel-inname
Documenten komen binnen via talloze kanalen: e-mailinboxen, FTP-servers, webportalen en uploads via mobiele apps. Intelligente systemen bewaken deze kanalen automatisch en nemen documenten in bij aankomst, waardoor handmatige bestandsroutering overbodig wordt.
Stap 2: documentclassificatie en routering
Het systeem bepaalt het documenttype - inkooporder, belastingformulier, klachtbrief - met machine learning voor documentclassificatie. AI analyseert structuur, trefwoorden en lay-out om direct te categoriseren. Het systeem verbetert continu doordat menselijke operators incidentele verkeerde classificaties corrigeren.
Stap 3: contextuele data-extractie
Na classificatie extraheert het systeem gerichte informatie. Natural language processing bij documentvastlegging stelt de software in staat ongestructureerde tekst te lezen en specifieke entiteiten zoals namen, datums, clausules en financiële cijfers te extraheren.
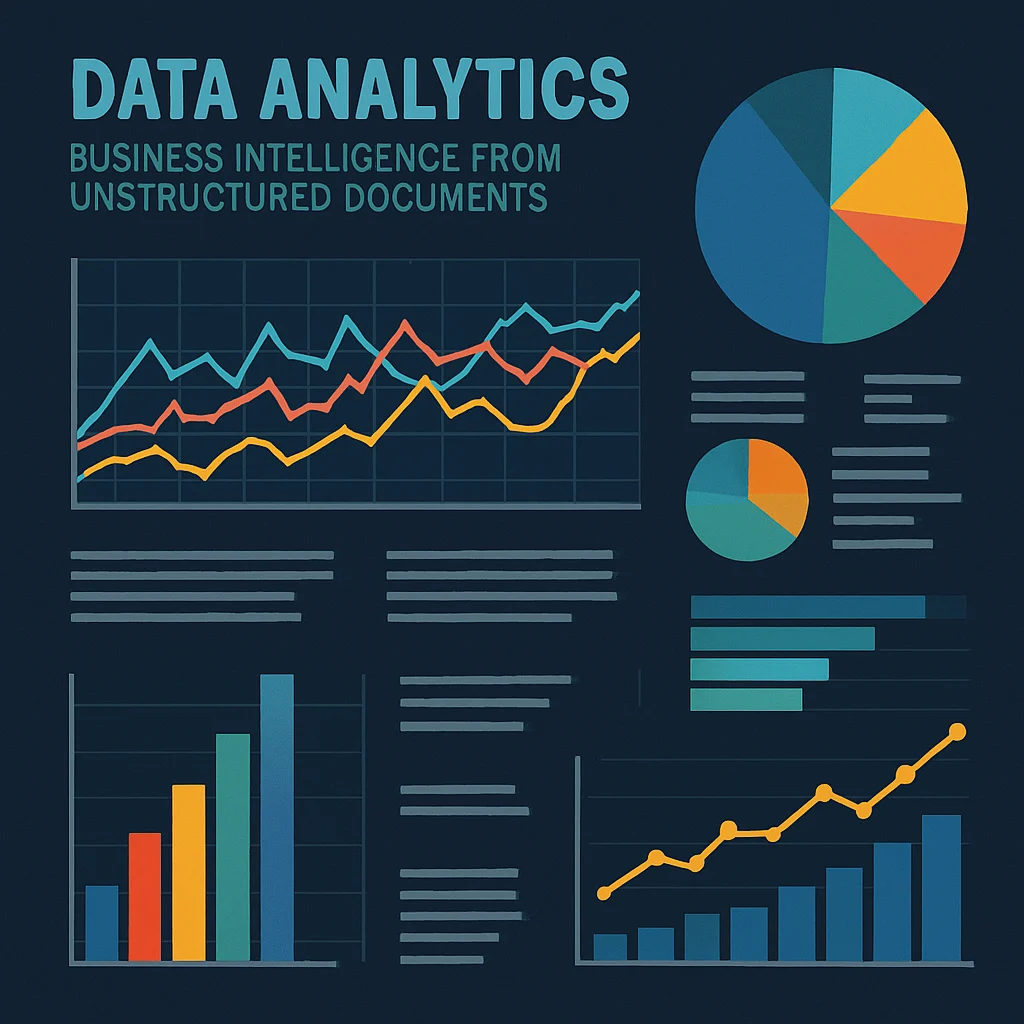
Dit ondersteunt het verwerken van ongestructureerde data voor business intelligence. Juridische teams kunnen NLP gebruiken om automatisch concurrentiebedingen te extraheren uit honderden arbeidscontracten, waardoor ruwe tekst wordt omgezet in een gestructureerde, analyseerbare database.
Stap 4: datavalidatie en -verrijking
Extractie moet nauwkeurig zijn. De software kruisverwijst geëxtraheerde data met bestaande bedrijfsdatabases. Als een leveranciersnaam en inkoopordernummer uit een factuur worden geëxtraheerd, verifieert het systeem dat het PO-nummer bij die leverancier hoort.
Stap 5: human-in-the-loop (uitzonderingsafhandeling)
Sterk gedegradeerde documenten of data die de validatie niet doorstaan, worden gemarkeerd voor menselijke beoordeling. Deze “human-in-the-loop”-aanpak waarborgt 100% gegevensnauwkeurigheid terwijl menselijke inspanning alleen wordt gericht op uitzonderingen.
Stap 6: naadloze systeemlevering
Gevalideerde data wordt geformatteerd en doorgestuurd naar downstreamsystemen - ERP’s, CRM’s, of business-intelligence-dashboards - klaar voor direct gebruik.
Hoofdstuk 3: intelligente documentverwerking versus OCR
Het begrijpen van het verschil tussen IDC en traditionele OCR is cruciaal voor modernisering binnen de onderneming.
Traditionele OCR: de blinde lezer
Standaard optical character recognition zet gepixelde afbeeldingen om in digitale tekstkarakters.
- Sterke punten: uitstekend voor het omzetten van gescande boeken in doorzoekbare PDF’s.
- Zwakke punten: kan geen onderscheid maken tussen geboortedatums en vervaldatums van facturen. Leunt op zonale OCR (sjabloonvakken). Extractie faalt zodra documentlay-outs veranderen.
IDP / IDC: de cognitieve lezer
Intelligente documentverwerking gebruikt OCR als fundamentele stap. Zodra tekst is gedigitaliseerd, neemt AI het over.
- Contextueel bewustzijn: begrijpt wat tekst betekent.
- Zonder sjabloon: heeft geen vakken of regels nodig voor elke leverancierslay-out.
- Aanpassingsvermogen: verwerkt sterk ongestructureerde documenten zoals e-mails of contracten.
De les voor de onderneming: verouderde OCR dwingt IT-teams honderden uren te besteden aan het onderhouden van sjablonen. Overstappen naar intelligente datavastlegging elimineert deze last en verwerkt documentvariatie moeiteloos.
Hoofdstuk 4: belangrijkste voordelen voor de moderne onderneming
1. Drastische vermindering van fouten bij handmatige gegevensinvoer
Mensen hebben moeite met repetitieve transcriptie op hoog volume. Vermoeidheid, afleiding en typefouten veroorzaken fouten met ernstige gevolgen - complianceovertredingen, vertraagde betalingen, verpeste klantervaringen.
Door dit proces te automatiseren, bereiken ondernemingen bijna nul fouten bij handmatige gegevensinvoer. Algoritmen worden niet moe, wat consistente resultaten waarborgt ongeacht het verwerkingsvolume.
2. Versterking van operationele snelheid en productiviteit
Wat een mens vijf minuten kost om te lezen, te begrijpen, te typen en te verifiëren, kost een intelligent systeem een fractie van een seconde. Het verbeteren van de nauwkeurigheid van gegevensextractie met AI versnelt de hele bedrijfslevenscyclus - snellere leningsgoedkeuringen, snellere klantonboarding, versnelde bewegingen in de toeleveringsketen.
3. Cognitieve automatisering voor factuurverwerking mogelijk maken
Cognitieve automatisering voor factuurverwerking stelt bedrijven in staat facturen in tientallen talen en valuta in te nemen, ze automatisch te matchen met inkooporders en ontvangstrapporten (drieweg-matching), en ze te routeren voor goedkeuring. Dit voorkomt boetes voor late betaling, benut kortingen voor vroege betaling en maakt AP-personeel vrij voor leveranciersrelaties.
4. De waarde van verborgen data ontsluiten
Naar schatting zit tot 80% van bedrijfsdata vast in ongestructureerde formaten. De voordelen van AI-gestuurde documentextractie reiken verder dan kostenbesparing en maken echte business intelligence mogelijk. Leidinggevenden krijgen ongekend inzicht in markttrends en operationele knelpunten.
Hoofdstuk 5: implementatieroutekaart voor IDC binnen de onderneming
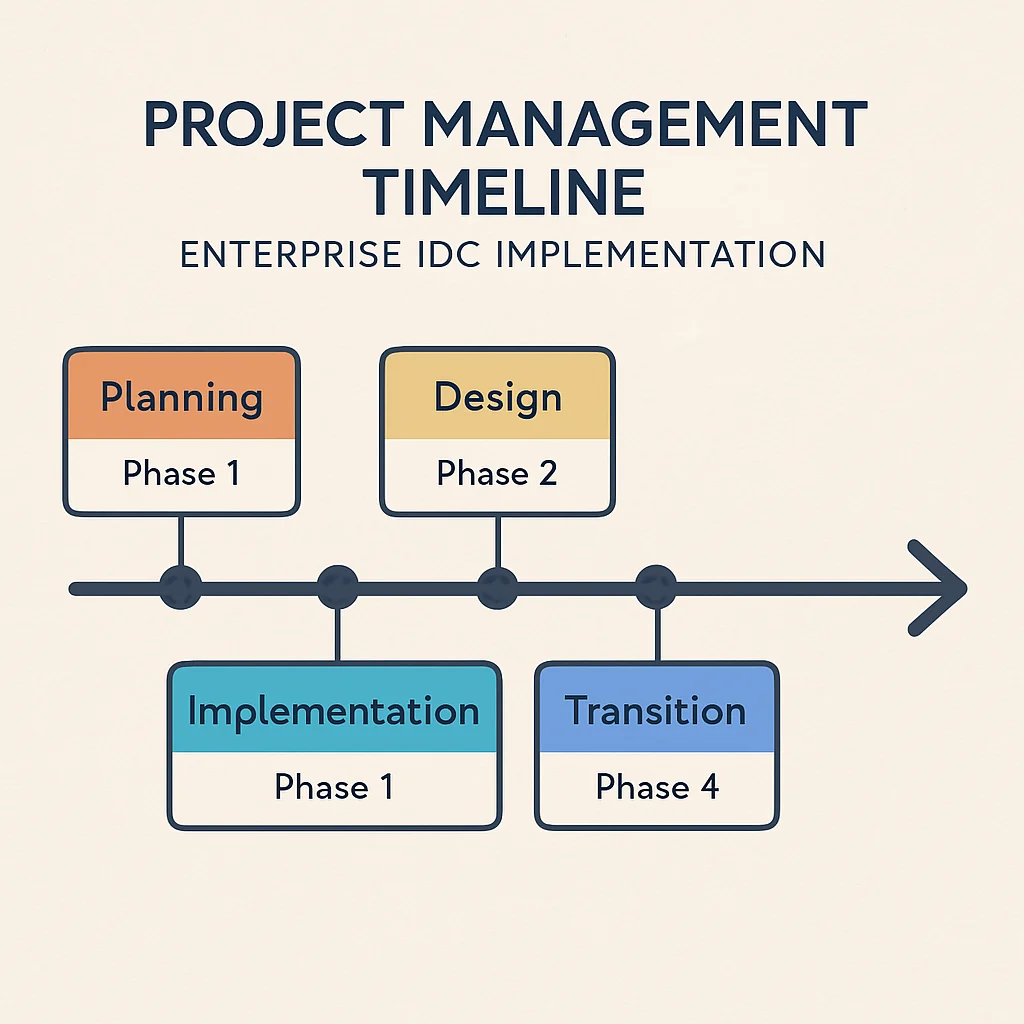
Het succesvol implementeren van intelligente datavastlegging vereist een strategische aanpak over vijf fasen.
Fase 1: behoefteanalyse en prioritering van use cases
Automatiseer niet alle documenten tegelijk. Identificeer processen die lijden onder het hoogste documentvolume, de grootste handmatige inspanning en de hoogste foutpercentages.
Crediteurenadministratie, hr-onboarding en de verwerking van klantclaims zijn traditioneel uitstekende startpunten. Breng huidige handmatige workflows stap voor stap in kaart om nulmetingen voor rendementsberekeningen vast te stellen.
Fase 2: de beste software voor intelligente datavastlegging voor ondernemingen selecteren
Let bij het evalueren van oplossingen op:
- Voorgetrainde AI-modellen: kant-en-klaar begrip van veelvoorkomende zakelijke documenten (facturen, bonnen, identiteitsdocumenten)?
- Gebruiksgemak: kunnen zakelijke gebruikers (niet alleen ontwikkelaars) het systeem trainen via intuïtieve interfaces?
- Integratiemogelijkheden: robuuste API’s en kant-en-klare connectoren voor specifieke technologiestacks?
Fase 3: gegevensbeveiliging prioriteren in geautomatiseerde vastleggingssystemen
Ondernemingen verwerken gevoelige informatie - PII, beschermde medische informatie, bedrijfseigen financiële data. Gegevensbeveiliging in geautomatiseerde vastleggingssystemen mag geen bijzaak zijn.
Zorg dat leveranciers het volgende bieden:
- End-to-end-encryptie (data in rust en tijdens verzending).
- Roltoegangscontroles die alleen bevoegde inzage waarborgen.
- Compliancecertificeringen (SOC 2, GDPR, HIPAA).
- Functies voor het onleesbaar maken van gegevens die gevoelige informatie automatisch verhullen.
Fase 4: geautomatiseerde vastlegging integreren met verouderde systemen
Een systeem voor datavastlegging faalt in isolatie. Het integreren van geautomatiseerde vastlegging met verouderde systemen is vaak het meest complexe aspect van de implementatie.
Er bestaan twee benaderingen:
- API-integratie: de moderne, geprefereerde methode waarbij IDC-software rechtstreeks communiceert met moderne SaaS-databases.
- RPA-integratie: voor verouderde systemen zonder API’s gebruiken Robotic Process Automation-bots gestructureerde data om toetsaanslagen op verouderde interfaces na te bootsen.
Fase 5: pilottesten en training van machine learning
Rol de technologie uit naar beperkte pilotgroepen. Tijdens deze fase komen systemen nieuwe documentformaten tegen. Train personeel op human-in-the-loop-interfaces om uitzonderingen te corrigeren. Elke menselijke correctie traint de machine-learningmodellen, wat de autonomie van het systeem vergroot.
Hoofdstuk 6: opschalen en succes meten
Schaalbare oplossingen voor datavastlegging ontwerpen voor grote organisaties
Naarmate de uitrol wereldwijd uitbreidt, pieken documentvolumes dramatisch rond het einde van fiscale kwartalen of feestdagen. Schaalbare oplossingen voor datavastlegging voor grote organisaties zijn cloud-native. Cloudinfrastructuur zet automatisch rekencapaciteit in tijdens piekmomenten en schaalt af tijdens rustige periodes voor kostenbesparing.
Schaalbare oplossingen maken het mogelijk gecentraliseerde “centers of excellence” in te zetten die bepalen hoe afdelingen workflows bouwen, wat ervoor zorgt dat best practices en beveiliging consistent blijven.
Het rendement van intelligente documentverwerking berekenen
Om uitbreiding te rechtvaardigen, moet u waarde bewijzen aan het leiderschap. Het rendement van intelligente documentverwerking omvat drie dimensies:
- Harde kostenbesparingen (herverdeling van FTE’s): bereken uren besteed aan handmatige gegevensinvoer, vermenigvuldigd met volledig belaste uurtarieven. Vergelijk dit met softwarelicentiekosten. (Let op: de meeste ondernemingen herverdelen personeel eerder dan het te verminderen.)
- Besparingen op foutherstel: bereken eerdere kosten van fouten in gegevensinvoer (compliance-boetes, te veel betaalde bedragen, verloren klanten), vermenigvuldigd met de verlaging van het foutpercentage.
- Waarde van procesversnelling: bereken omzetwinst door orders 80% sneller te verwerken, of leverancierskortingen die worden benut door snelle factuurverwerking.
Belangrijkste KPI-tracker:
- STP-percentage: percentage documenten dat end-to-end wordt verwerkt zonder menselijke tussenkomst.
- Gemiddelde verwerkingstijd: duur van inname tot levering.
- Kosten per document: totale systeemkosten gedeeld door volume.
Hoofdstuk 7: praktische tips voor succes binnen de onderneming
- Pak verandermanagement aan: communiceer dat automatisering vervelende taken wegneemt, waardoor personeel wordt vrijgemaakt voor zinvol werk in plaats van te worden vervangen.
- Optimaliseer brondocumenten: herontwerp interne formulieren die moeilijk te lezen zijn. Kleine lay-outaanpassingen verhogen STP-percentages van 85% naar 98%.
- Zet feedbackloops op: plan maandelijkse beoordelingen met human-in-the-loop-operators. Hun inzichten identificeren terugkerende leveranciersfouten en systeemverbeteringen.
Conclusie
Het tijdperk van handmatige documentverwerking loopt snel ten einde. De overstap naar moderne automatisering is noodzakelijk voor concurrerende, wendbare en beveiligde ondernemingen.
Door te begrijpen hoe intelligente datavastlegging werkt, prioriteit te geven aan naadloze integratie met verouderde systemen, en te focussen op continue verbetering van machine learning, transformeren organisaties ongestructureerde documenten van een operationele last naar een strategisch voordeel.
Omarm de technologie, versterk het personeelsbestand, en ontsluit de intelligentie die verborgen zit in bedrijfsdata.
