Qué Es la Captura Inteligente de Datos
Qué es la captura inteligente de datos y cómo la automatización con IA sustituye la introducción manual en los flujos documentales de alto volumen.
Capítulo 1: Comprender los fundamentos
Qué es la captura inteligente de datos
La captura inteligente de datos (IDC) es una tecnología avanzada que usa inteligencia artificial (IA), aprendizaje automático (ML) y procesamiento del lenguaje natural (NLP) para identificar, extraer y estructurar datos de diversos tipos de documento de forma automática.
A diferencia de las soluciones tradicionales que simplemente convierten imágenes de documentos en texto sin procesar, los sistemas IDC “comprenden” el contexto. Distinguen entre el total de una factura y un número de teléfono, incluso cuando los formatos de documento varían de forma significativa.
La evolución de las herramientas de automatización de datos
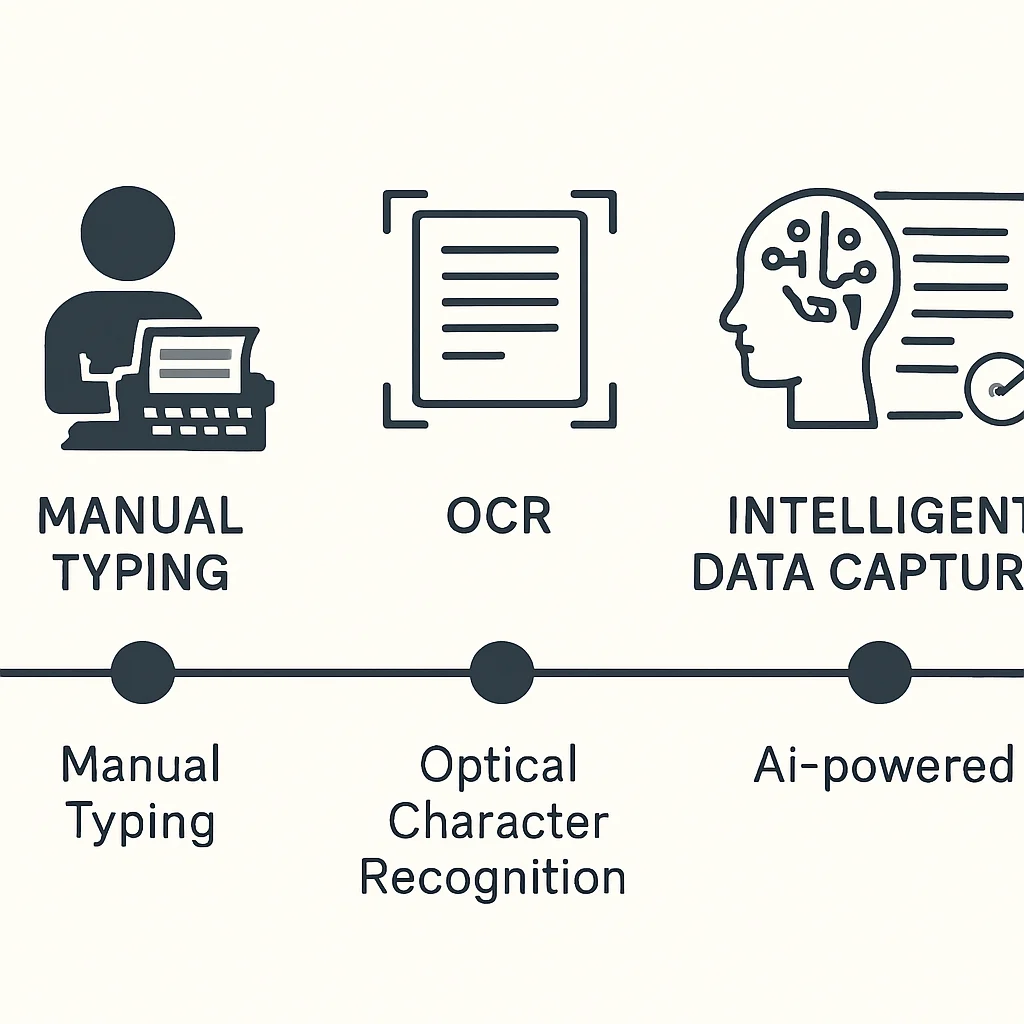
El recorrido ha implicado tres fases:
- Introducción manual de datos: las personas leían físicamente los documentos y escribían la información en bases de datos, algo lento, costoso y propenso a errores.
- OCR tradicional: software que reconoce caracteres de texto en imágenes. Aunque más rápido que la introducción manual, depende de plantillas rígidas que fallan cuando cambia el diseño del documento.
- Captura inteligente de datos: el estándar moderno que combina el OCR con la IA, aprendiendo y adaptándose sin necesitar plantillas rígidas.
Capítulo 2: La tecnología central explicada
Paso 1: ingesta multicanal
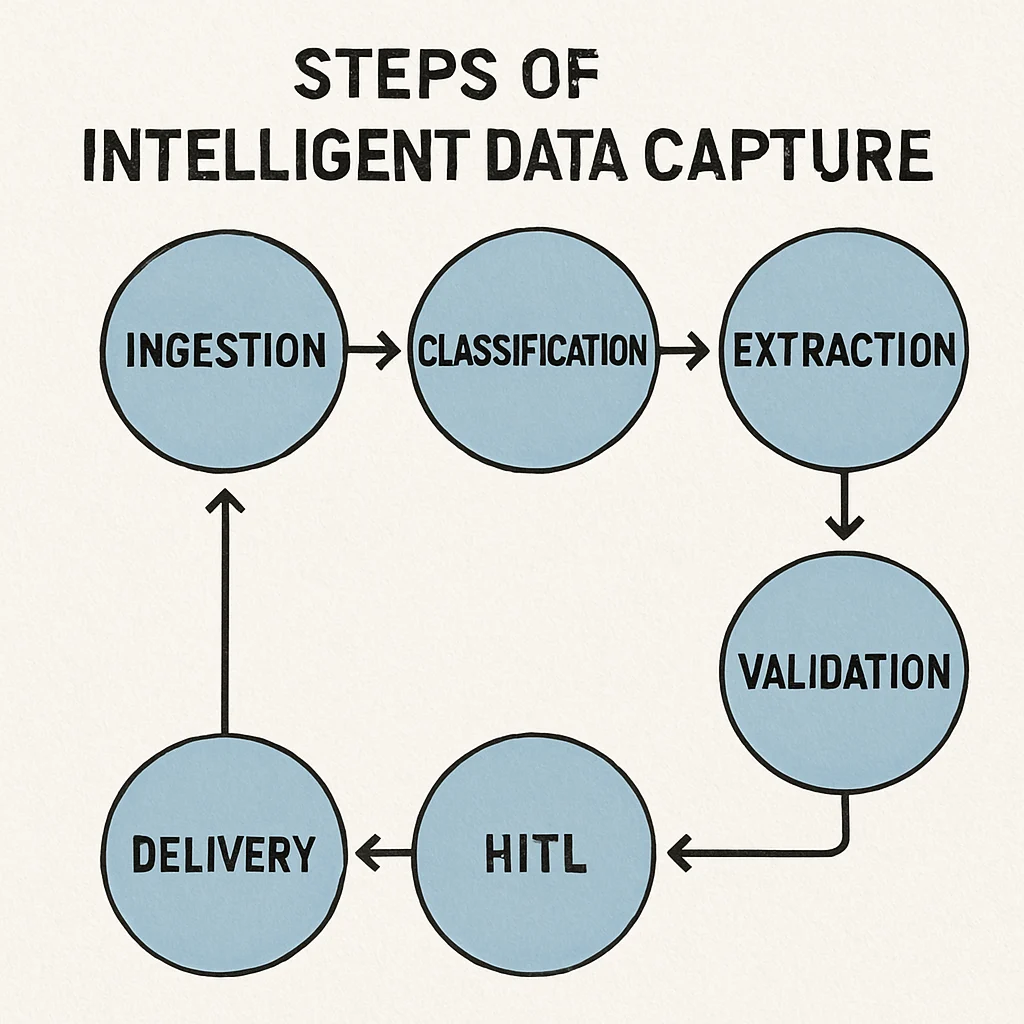
Los documentos llegan a través de innumerables canales: bandejas de correo electrónico, servidores FTP, portales web y cargas desde aplicaciones móviles. Los sistemas inteligentes monitorizan automáticamente estos canales e ingieren los documentos en cuanto llegan, eliminando el enrutamiento manual de archivos.
Paso 2: clasificación y enrutamiento de documentos
El sistema determina el tipo de documento (orden de compra, formulario fiscal, carta de reclamación) mediante el aprendizaje automático para la clasificación de documentos. La IA analiza la estructura, las palabras clave y el diseño para categorizar de forma instantánea. El sistema mejora de forma continua a medida que los operadores humanos corrigen las clasificaciones erróneas ocasionales.
Paso 3: extracción de datos contextual
Tras la clasificación, el sistema extrae la información específica. El procesamiento del lenguaje natural en la captura de documentos permite que el software lea texto no estructurado y extraiga entidades específicas como nombres, fechas, cláusulas y cifras financieras.
Esto respalda el procesamiento de datos no estructurados para la inteligencia de negocio. Los equipos jurídicos pueden usar el NLP para extraer automáticamente cláusulas de no competencia de cientos de contratos laborales, transformando texto sin procesar en una base de datos estructurada y analizable.
Paso 4: validación y enriquecimiento de datos
La extracción debe ser precisa. El software contrasta los datos extraídos con las bases de datos empresariales existentes. Si se extraen de una factura el nombre de un proveedor y un número de orden de compra, el sistema verifica que el número de orden pertenece a ese proveedor.
Paso 5: supervisión humana (gestión de excepciones)
Los documentos muy degradados o los datos que no superan la validación se marcan para revisión humana. Este enfoque de “supervisión humana” garantiza una precisión de datos del 100 % a la vez que concentra el esfuerzo humano solo en las excepciones.
Paso 6: entrega fluida al sistema
Los datos validados se formatean y se envían a los sistemas posteriores (ERP, CRM o paneles de inteligencia de negocio), listos para su uso inmediato.
Capítulo 3: procesamiento inteligente de documentos frente a OCR
Comprender la diferencia entre la IDC y el OCR tradicional es crucial para la modernización empresarial.
OCR tradicional: el lector ciego
El reconocimiento óptico de caracteres estándar traduce imágenes pixeladas en caracteres de texto digital.
- Fortalezas: excelente para convertir libros escaneados en PDF consultables.
- Debilidades: no puede distinguir entre una fecha de nacimiento y la fecha de vencimiento de una factura. Depende del OCR zonal (casillas de plantilla). La extracción falla cuando cambia el diseño del documento.
IDP/IDC: el lector cognitivo
El procesamiento inteligente de documentos usa el OCR como paso fundacional. Una vez digitalizado el texto, la IA toma el relevo.
- Conciencia contextual: comprende qué significa el texto.
- Sin plantillas: no requiere casillas ni reglas para cada diseño de proveedor.
- Adaptabilidad: procesa documentos muy no estructurados, como correos electrónicos o contratos.
La conclusión para la empresa: el OCR heredado obliga a los equipos de TI a dedicar cientos de horas a mantener plantillas. Actualizar a la captura inteligente de datos elimina esta carga y gestiona la variabilidad de los documentos con facilidad.
Capítulo 4: ventajas clave para la empresa moderna
1. Reducir drásticamente los errores de introducción manual de datos
Las personas tienen dificultades con la transcripción repetitiva y de alto volumen. La fatiga, las distracciones y las erratas provocan errores con consecuencias graves: infracciones de cumplimiento, pagos retrasados, experiencias de cliente arruinadas.
Al automatizar este proceso, las empresas logran errores de introducción manual de datos casi nulos. Los algoritmos no se cansan, garantizando resultados coherentes sin importar el volumen de procesamiento.
2. Amplificar la velocidad y la productividad operativas
Lo que a una persona le lleva cinco minutos leer, comprender, escribir y verificar, a un sistema inteligente le lleva fracciones de segundo. Mejorar la precisión de la extracción de datos con IA acelera todo el ciclo de vida del negocio: aprobaciones de préstamos más rápidas, incorporación de clientes más ágil, movimientos de la cadena de suministro más rápidos.
3. Habilitar la automatización cognitiva para el procesamiento de facturas
La automatización cognitiva para el procesamiento de facturas permite a las empresas ingerir facturas en decenas de idiomas y monedas, conciliarlas automáticamente con órdenes de compra e informes de recepción (conciliación a tres bandas) y enrutarlas para su aprobación. Esto evita las penalizaciones por pago tardío, captura los descuentos por pronto pago y libera al personal de cuentas por pagar para las relaciones con proveedores.
4. Desbloquear el valor de los datos ocultos
Se estima que hasta el 80 % de los datos empresariales está atrapado en formatos no estructurados. Las ventajas de la extracción de documentos con IA van más allá del ahorro de costes para habilitar una verdadera inteligencia de negocio. La dirección obtiene una visibilidad sin precedentes de las tendencias del mercado y los cuellos de botella operativos.
Capítulo 5: hoja de ruta de implementación de la IDC empresarial
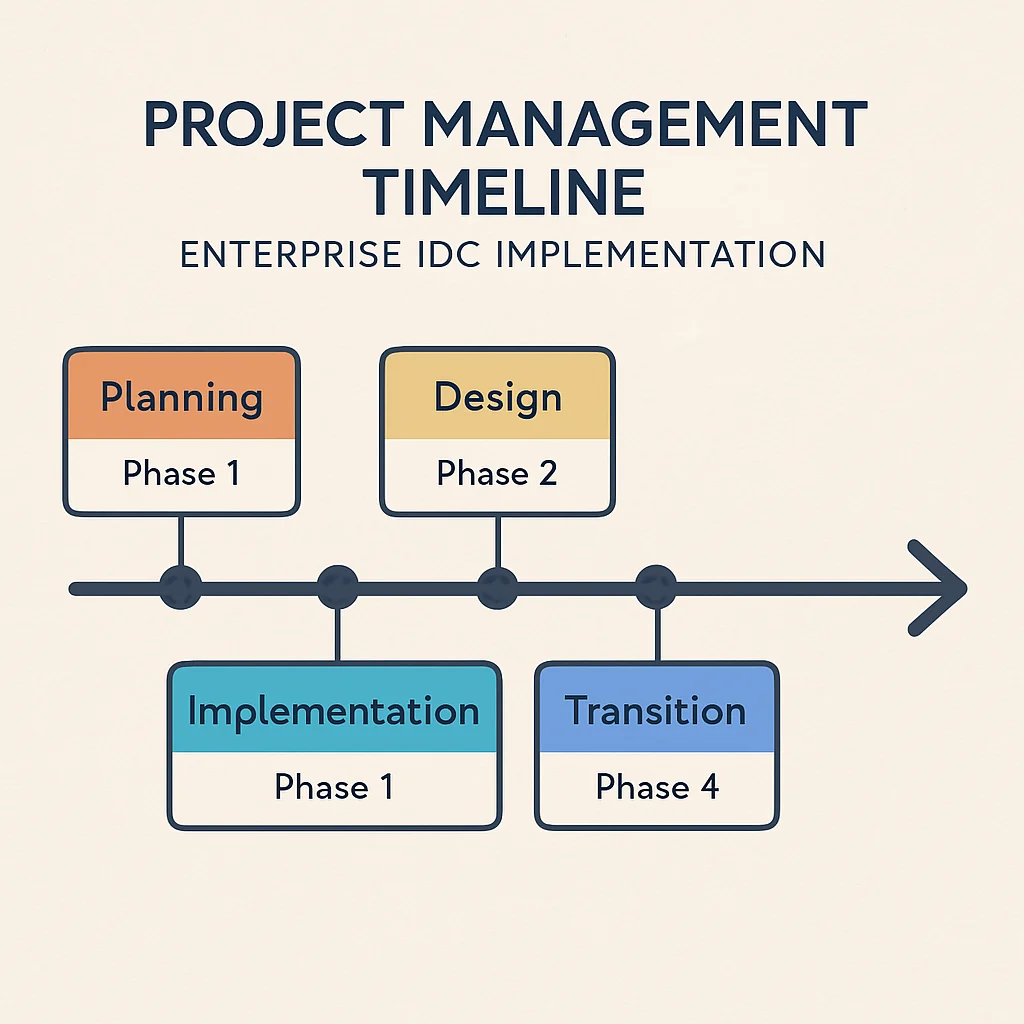
Desplegar con éxito la captura inteligente de datos requiere un enfoque estratégico en cinco fases.
Fase 1: evaluación de necesidades y priorización de casos de uso
No automatice todos los documentos a la vez. Identifique los procesos que sufren el mayor volumen documental, el mayor esfuerzo manual y las mayores tasas de error.
Las cuentas por pagar, la incorporación de RRHH y el procesamiento de reclamaciones de clientes son puntos de partida tradicionalmente excelentes. Mapee los flujos de trabajo manuales actuales paso a paso para establecer cálculos de referencia del retorno de la inversión.
Fase 2: seleccionar el mejor software de captura inteligente de datos para empresas
Al evaluar soluciones, busque:
- Modelos de IA preentrenados: ¿comprensión lista para usar de los documentos de negocio habituales (facturas, recibos, documentos de identidad)?
- Facilidad de uso: ¿pueden los usuarios de negocio (no solo los desarrolladores) entrenar el sistema mediante interfaces intuitivas?
- Capacidades de integración: ¿API sólidas y conectores predefinidos para pilas tecnológicas específicas?
Fase 3: priorizar la seguridad de los datos en los sistemas de captura automatizada
Las empresas gestionan información sensible: PII, información de salud protegida, datos financieros de propiedad exclusiva. La seguridad de los datos en los sistemas de captura automatizada no puede ser una idea de último momento.
Asegúrese de que los proveedores ofrecen:
- Cifrado de extremo a extremo (datos en reposo y en tránsito).
- Controles de acceso basados en roles que garantizan una visualización autorizada exclusivamente.
- Certificaciones de cumplimiento (SOC 2, RGPD, HIPAA).
- Funciones de redacción de datos que ocultan automáticamente la información sensible.
Fase 4: integrar la captura automatizada con los sistemas heredados
Un sistema de captura de datos fracasa si opera de forma aislada. Integrar la captura automatizada con los sistemas heredados suele ser el aspecto más complejo del despliegue.
Existen dos enfoques:
- Integración por API: el método moderno y preferido, en el que el software IDC se comunica directamente con bases de datos SaaS modernas.
- Integración por RPA: para los sistemas heredados que carecen de API, los bots de automatización robótica de procesos usan datos estructurados para imitar pulsaciones de teclas en interfaces heredadas.
Fase 5: pruebas piloto y entrenamiento del aprendizaje automático
Despliegue la tecnología en grupos piloto limitados. Durante esta fase, los sistemas encuentran formatos de documento novedosos. Forme al personal en las interfaces de supervisión humana para corregir excepciones. Cada corrección humana entrena los modelos de aprendizaje automático, aumentando la autonomía del sistema.
Capítulo 6: escalar y medir el éxito
Diseñar soluciones de captura de datos escalables para grandes organizaciones
A medida que el despliegue se expande globalmente, los volúmenes de documentos se disparan de forma drástica en los cierres de trimestre fiscal o durante los periodos vacacionales. Las soluciones de captura de datos escalables para grandes organizaciones son nativas de la nube. La infraestructura en la nube activa automáticamente recursos de computación durante los picos y los reduce durante los periodos tranquilos para ahorrar costes.
Las soluciones escalables permiten desplegar “centros de excelencia” centralizados que rigen cómo construyen los departamentos sus flujos de trabajo, garantizando que las buenas prácticas y la seguridad se mantengan coherentes.
Calcular el retorno de la inversión del procesamiento inteligente de documentos
Para justificar la expansión, demuestre el valor ante la dirección. El retorno de la inversión del procesamiento inteligente de documentos abarca tres dimensiones:
- Ahorro de costes concreto (reasignación de personal): calcule las horas dedicadas a la introducción manual de datos multiplicadas por las tarifas horarias cargadas. Compárelo con los costes de licencia del software. (Nota: la mayoría de las empresas reasignan al personal en lugar de reducirlo.)
- Ahorro por remediación de errores: calcule los costes pasados de los errores de introducción de datos (multas de cumplimiento, sobrepagos, clientes perdidos) multiplicados por las reducciones de la tasa de error.
- Valor de la aceleración de procesos: calcule los ingresos obtenidos al procesar pedidos un 80 % más rápido, o los descuentos de proveedores capturados mediante el procesamiento rápido de facturas.
Panel de KPI clave:
- Tasa de procesamiento directo: porcentaje de documentos procesados de principio a fin sin intervención humana.
- Tiempo de procesamiento promedio: duración desde la ingesta hasta la entrega.
- Coste por documento: coste total del sistema dividido por el volumen.
Capítulo 7: consejos prácticos para el éxito empresarial
- Aborde la gestión del cambio: comunique que la automatización elimina las tareas tediosas, capacitando al personal para un trabajo con más sentido en lugar de sustituirlo.
- Optimice los documentos de origen: rediseñe los formularios internos difíciles de leer. Pequeños ajustes de diseño pueden elevar las tasas de procesamiento directo del 85 % al 98 %.
- Establezca bucles de retroalimentación: programe revisiones mensuales con los operadores de supervisión humana. Sus observaciones identifican errores recurrentes de proveedores y mejoras del sistema.
Conclusión
La era del procesamiento manual de documentos está llegando rápidamente a su fin. La transición a la automatización moderna es imperativa para las empresas competitivas, ágiles y seguras.
Al comprender cómo funciona la captura inteligente de datos, priorizar una integración fluida con los sistemas heredados y centrarse en la mejora continua del aprendizaje automático, las organizaciones transforman los documentos no estructurados de una carga operativa en una ventaja estratégica.
Adopte la tecnología, capacite a los equipos y desbloquee la inteligencia oculta en los datos empresariales.
