La capture intelligente de données
Ce qu'est la capture intelligente de données, et comment l'IA remplace la saisie manuelle dans les flux documentaires d'entreprise à fort volume.
Chapitre 1 : comprendre les fondamentaux
Qu’est-ce que la capture intelligente de données ?
La capture intelligente de données (IDC) est une technologie avancée qui utilise l’intelligence artificielle (IA), le machine learning (ML) et le traitement automatique du langage naturel (NLP) pour identifier, extraire et structurer automatiquement les données issues de divers types de documents.
Contrairement aux solutions traditionnelles qui se contentent de convertir des images de documents en texte brut, les systèmes IDC « comprennent » le contexte. Ils font la différence entre un montant total de facture et un numéro de téléphone, même lorsque les formats des documents varient considérablement.
L’évolution des outils d’automatisation des données
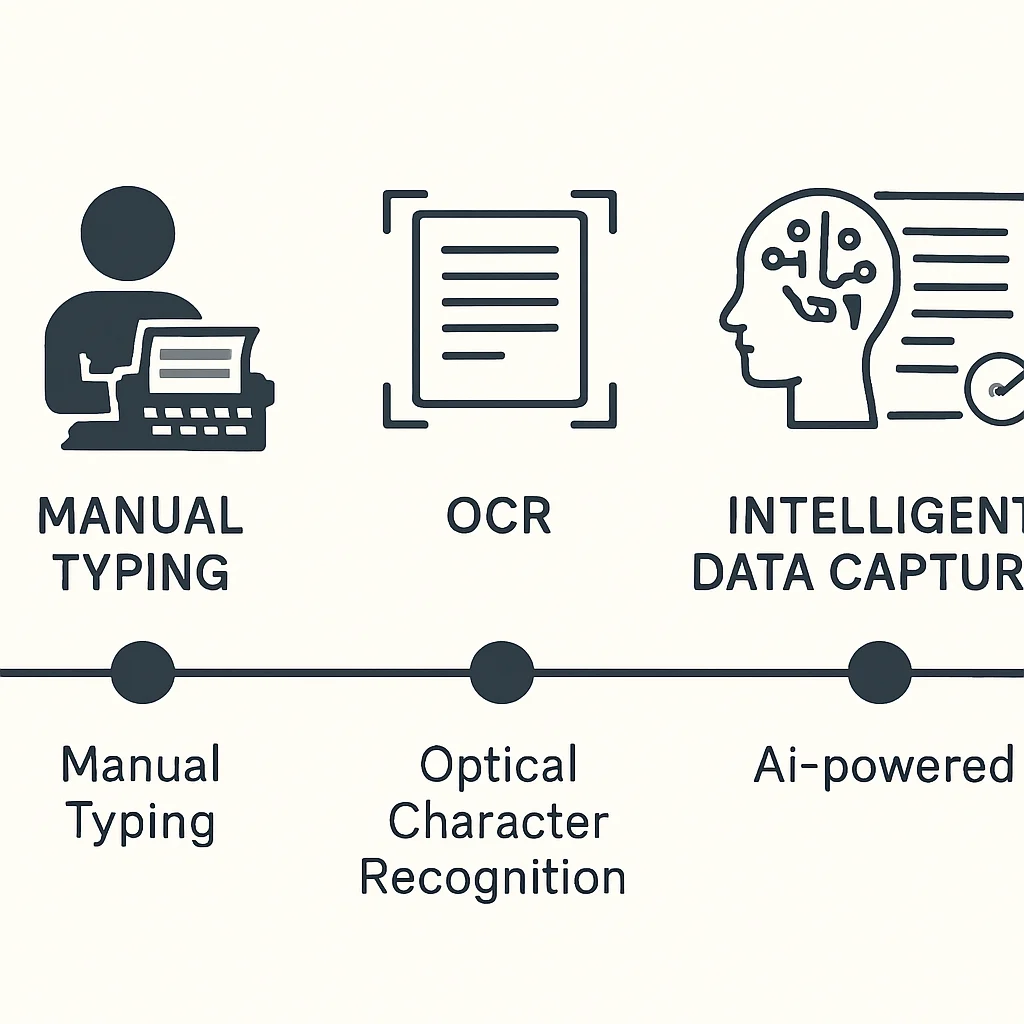
Ce parcours s’est déroulé en trois phases :
- Saisie manuelle des données : des personnes lisant physiquement les documents et saisissant les informations dans des bases de données - lent, coûteux et source d’erreurs.
- OCR traditionnel : des logiciels reconnaissant les caractères de texte dans des images. Bien que plus rapide que la saisie manuelle, il repose sur des modèles rigides qui échouent dès que la mise en page des documents change.
- Capture intelligente de données : la norme moderne combinant l’OCR et l’IA, apprenant et s’adaptant sans exiger de modèles rigides.
Chapitre 2 : la technologie fondamentale expliquée
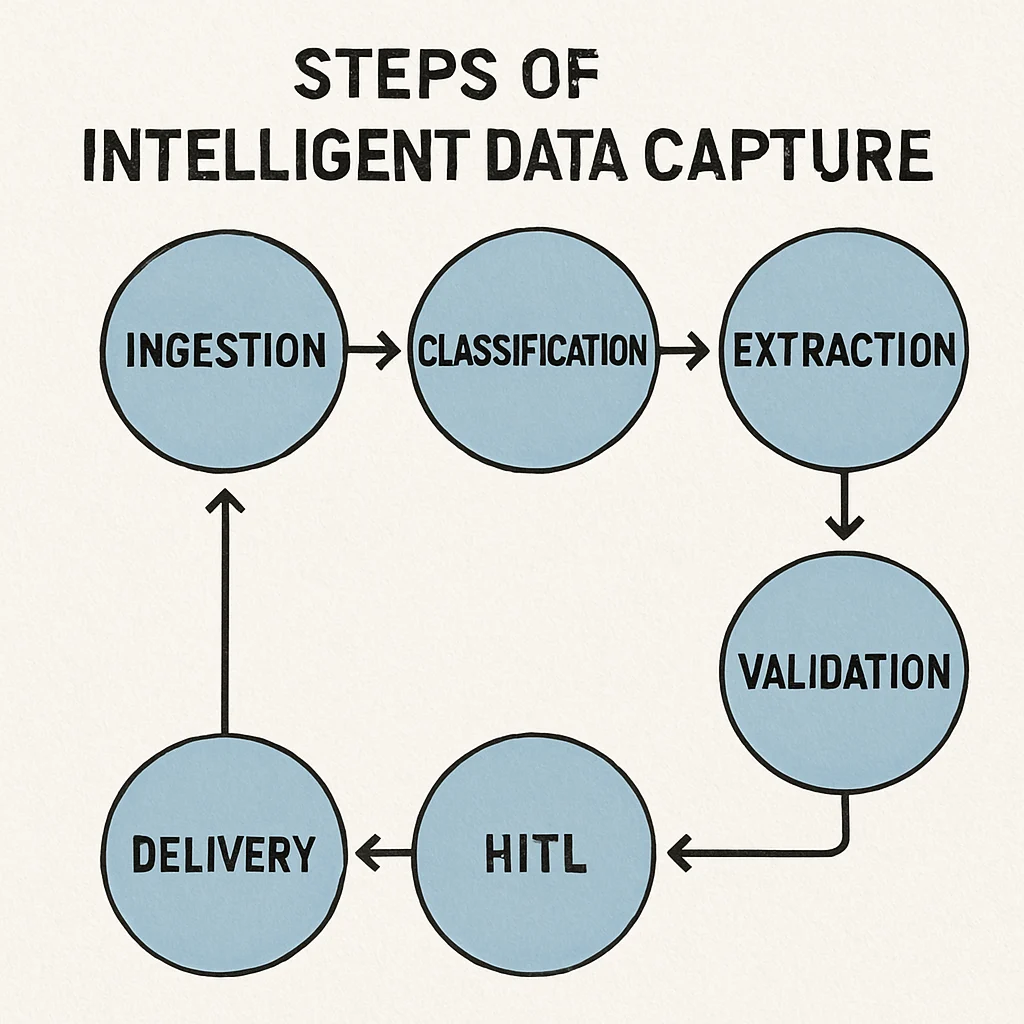
Étape 1 : ingestion multicanal
Les documents arrivent par d’innombrables canaux : boîtes de réception, serveurs FTP, portails web et téléversements depuis des applications mobiles. Les systèmes intelligents surveillent automatiquement ces canaux et ingèrent les documents dès leur arrivée, éliminant l’orientation manuelle des fichiers.
Étape 2 : classification et orientation des documents
Le système détermine le type de document - bon de commande, formulaire fiscal, lettre de réclamation - à l’aide du machine learning pour la classification documentaire. L’IA analyse la structure, les mots-clés et la mise en page pour catégoriser instantanément. Le système s’améliore en continu à mesure que les opérateurs humains corrigent les rares erreurs de classification.
Étape 3 : extraction contextuelle des données
Après la classification, le système extrait les informations ciblées. Le traitement automatique du langage naturel dans la capture documentaire permet au logiciel de lire du texte non structuré et d’extraire des entités spécifiques telles que noms, dates, clauses et chiffres financiers.
Cela soutient le traitement des données non structurées pour l’intelligence d’affaires. Les équipes juridiques peuvent utiliser le NLP pour extraire automatiquement des clauses de non-concurrence de centaines de contrats de travail, transformant du texte brut en une base de données structurée et analysable.
Étape 4 : validation et enrichissement des données
L’extraction doit être précise. Le logiciel recoupe les données extraites avec les bases de données existantes de l’entreprise. Si un nom de fournisseur et un numéro de bon de commande sont extraits d’une facture, le système vérifie que ce numéro de bon de commande appartient bien à ce fournisseur.
Étape 5 : l’humain dans la boucle (gestion des exceptions)
Les documents fortement dégradés ou les données ne passant pas la validation sont signalés pour une revue humaine. Cette approche « humain dans la boucle » garantit une précision des données de 100 % tout en concentrant l’effort humain sur les seules exceptions.
Étape 6 : livraison transparente vers les systèmes
Les données validées sont formatées et transmises aux systèmes en aval - ERP, CRM ou tableaux de bord d’intelligence d’affaires - prêtes à un usage immédiat.
Chapitre 3 : traitement intelligent des documents et OCR
Comprendre la différence entre l’IDC et l’OCR traditionnel est essentiel pour la modernisation de l’entreprise.
L’OCR traditionnel : le lecteur aveugle
La reconnaissance optique de caractères standard traduit des images pixelisées en caractères de texte numérique.
- Points forts : excellent pour convertir des livres numérisés en PDF consultables.
- Faiblesses : ne peut distinguer une date de naissance d’une date d’échéance de facture. Repose sur l’OCR zonal (zones modèles). L’extraction échoue dès que la mise en page des documents change.
IDP / IDC : le lecteur cognitif
Le traitement intelligent des documents utilise l’OCR comme étape fondatrice. Une fois le texte numérisé, l’IA prend le relais.
- Compréhension contextuelle : comprend ce que le texte signifie.
- Sans modèle : ne nécessite ni zones ni règles pour chaque mise en page fournisseur.
- Adaptabilité : traite des documents hautement non structurés comme des courriels ou des contrats.
Ce qu’il faut retenir pour l’entreprise : l’OCR hérité oblige les équipes informatiques à consacrer des centaines d’heures à la maintenance des modèles. Passer à la capture intelligente de données élimine cette charge et gère facilement la variabilité des documents.
Chapitre 4 : principaux avantages pour l’entreprise moderne
1. Réduire drastiquement les erreurs de saisie manuelle
Les humains peinent face à une transcription répétitive et à fort volume. Fatigue, distractions et fautes de frappe provoquent des erreurs aux conséquences sérieuses - violations de conformité, paiements retardés, expériences clients gâchées.
En automatisant ce processus, les entreprises atteignent des erreurs de saisie manuelle quasi nulles. Les algorithmes ne se fatiguent pas, garantissant des résultats constants quel que soit le volume traité.
2. Amplifier la vitesse opérationnelle et la productivité
Ce qui prend cinq minutes à un humain pour lire, comprendre, taper et vérifier prend une fraction de seconde à un système intelligent. Améliorer la précision de l’extraction des données grâce à l’IA accélère l’ensemble du cycle de vie métier - approbations de prêts plus rapides, intégration client plus rapide, mouvements de chaîne d’approvisionnement accélérés.
3. Permettre l’automatisation cognitive du traitement des factures
L’automatisation cognitive du traitement des factures permet aux entreprises d’ingérer des factures dans des dizaines de langues et de devises, de les rapprocher automatiquement des bons de commande et des rapports de réception (rapprochement à trois voies), et de les orienter pour approbation. Cela évite les pénalités de retard de paiement, capte les remises pour paiement anticipé et libère le personnel des comptes fournisseurs pour les relations avec les fournisseurs.
4. Libérer la valeur des données cachées
Selon certaines estimations, jusqu’à 80 % des données d’entreprise sont piégées dans des formats non structurés. Les avantages de l’extraction documentaire pilotée par l’IA vont au-delà des économies de coûts pour permettre une véritable intelligence d’affaires. La direction gagne une visibilité inédite sur les tendances du marché et les goulots d’étranglement opérationnels.
Chapitre 5 : feuille de route de mise en œuvre de l’IDC en entreprise
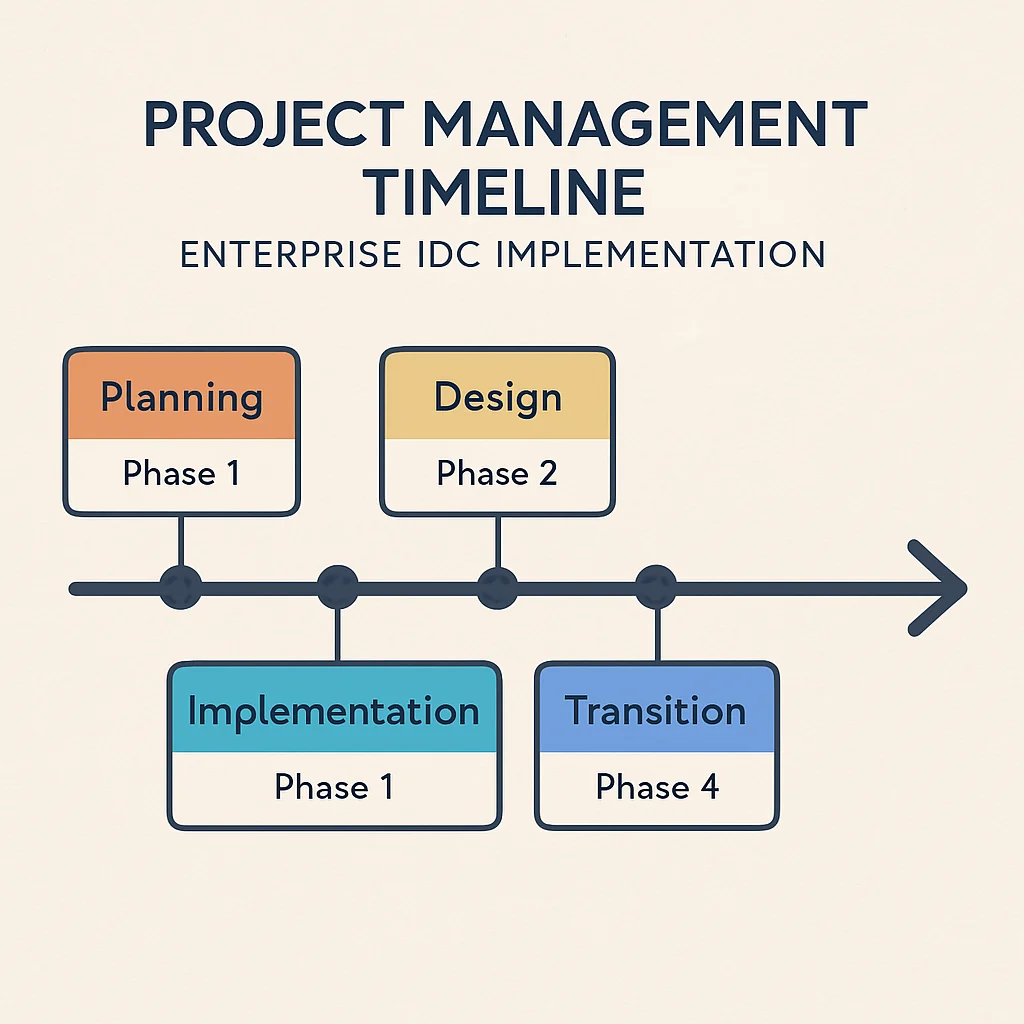
Déployer avec succès la capture intelligente de données exige une approche stratégique en cinq phases.
Phase 1 : évaluation des besoins et priorisation des cas d’usage
N’automatisez pas tous les documents à la fois. Identifiez les processus souffrant du plus grand volume documentaire, du plus grand effort manuel et des taux d’erreur les plus élevés.
Les comptes fournisseurs, l’intégration RH et le traitement des sinistres clients constituent traditionnellement d’excellents points de départ. Cartographiez étape par étape les flux de travail manuels actuels pour établir des calculs de retour sur investissement de référence.
Phase 2 : sélectionner le meilleur logiciel de capture intelligente de données pour l’entreprise
Lors de l’évaluation des solutions, recherchez :
- Modèles d’IA pré-entraînés : une compréhension prête à l’emploi des documents métier courants (factures, reçus, pièces d’identité) ?
- Facilité d’utilisation : les utilisateurs métier (et pas seulement les développeurs) peuvent-ils entraîner le système via des interfaces intuitives ?
- Capacités d’intégration : des API robustes et des connecteurs préconstruits pour des piles technologiques spécifiques ?
Phase 3 : prioriser la sécurité des données dans les systèmes de capture automatisée
Les entreprises traitent des informations sensibles - données personnelles identifiables, informations de santé protégées, données financières propriétaires. La sécurité des données dans les systèmes de capture automatisée ne peut pas être une réflexion après coup.
Assurez-vous que les fournisseurs proposent :
- Un chiffrement de bout en bout (données au repos et en transit).
- Des contrôles d’accès basés sur les rôles garantissant une consultation réservée aux personnes autorisées.
- Des certifications de conformité (SOC 2, GDPR, HIPAA).
- Des fonctionnalités de rédaction automatique masquant les informations sensibles.
Phase 4 : intégrer la capture automatisée aux systèmes hérités
Un système de capture de données échoue s’il reste isolé. L’intégration de la capture automatisée aux systèmes hérités est souvent l’aspect le plus complexe du déploiement.
Deux approches existent :
- Intégration par API : la méthode moderne et privilégiée, où le logiciel IDC communique directement avec les bases de données SaaS modernes.
- Intégration par RPA : pour les systèmes hérités dépourvus d’API, des robots d’automatisation robotisée des processus utilisent les données structurées pour reproduire des frappes clavier sur les interfaces héritées.
Phase 5 : tests pilotes et entraînement du machine learning
Déployez la technologie auprès de groupes pilotes limités. Durant cette phase, les systèmes rencontrent des formats de documents inédits. Formez le personnel aux interfaces d’humain dans la boucle pour corriger les exceptions. Chaque correction humaine entraîne les modèles de machine learning, augmentant l’autonomie du système.
Chapitre 6 : mettre à l’échelle et mesurer la réussite
Concevoir des solutions de capture de données évolutives pour les grandes organisations
À mesure que le déploiement s’étend à l’échelle mondiale, les volumes de documents connaissent des pics importants lors des clôtures trimestrielles ou des périodes de congés. Les solutions de capture de données évolutives pour les grandes organisations sont natives du cloud. L’infrastructure cloud active automatiquement des ressources de calcul pendant les pics et les réduit pendant les périodes calmes, pour des économies de coûts.
Les solutions évolutives permettent de déployer des « centres d’excellence » centralisés régissant la façon dont les services conçoivent leurs flux de travail, garantissant la cohérence des bonnes pratiques et de la sécurité.
Calculer le retour sur investissement du traitement intelligent des documents
Pour justifier l’expansion, il faut démontrer la valeur à la direction. Le retour sur investissement du traitement intelligent des documents couvre trois dimensions :
- Économies de coûts directes (réaffectation des équivalents temps plein) : calculez les heures consacrées à la saisie manuelle multipliées par les taux horaires chargés. Comparez au coût des licences logicielles. (Remarque : la plupart des entreprises réaffectent le personnel plutôt que de le réduire.)
- Économies liées à la remédiation des erreurs : calculez les coûts passés des erreurs de saisie (amendes de conformité, trop-perçus, clients perdus) multipliés par la réduction du taux d’erreur.
- Valeur de l’accélération des processus : calculez le chiffre d’affaires généré par un traitement des commandes 80 % plus rapide, ou les remises fournisseurs captées grâce à un traitement rapide des factures.
Suivi des indicateurs clés :
- Taux de traitement direct (STP) : pourcentage de documents traités de bout en bout sans intervention humaine.
- Temps de traitement moyen : durée entre l’ingestion et la livraison.
- Coût par document : coût total du système divisé par le volume.
Chapitre 7 : conseils pratiques pour réussir en entreprise
- Prendre en compte la conduite du changement : communiquez que l’automatisation élimine les tâches fastidieuses, en donnant au personnel les moyens d’un travail porteur de sens plutôt qu’en le remplaçant.
- Optimiser les documents source : repensez les formulaires internes difficiles à lire. De petits ajustements de mise en page font passer les taux de traitement direct de 85 % à 98 %.
- Instaurer des boucles de rétroaction : planifiez des revues mensuelles avec les opérateurs d’humain dans la boucle. Leurs observations permettent d’identifier les erreurs récurrentes des fournisseurs et les améliorations à apporter au système.
Conclusion
L’ère du traitement manuel des documents touche rapidement à sa fin. La transition vers l’automatisation moderne est impérative pour des entreprises compétitives, agiles et sécurisées.
En comprenant le fonctionnement de la capture intelligente de données, en priorisant une intégration fluide avec les systèmes hérités, et en se concentrant sur l’amélioration continue du machine learning, les organisations transforment les documents non structurés d’une charge opérationnelle en un avantage stratégique.
Adoptez la technologie, donnez à vos équipes les moyens d’agir, et libérez l’intelligence cachée dans les données de l’entreprise.
