Was ist Intelligente Datenerfassung?
Was intelligente Datenerfassung ist und wie KI-gestützte Automatisierung die manuelle Dateneingabe in umfangreichen Dokumenten-Workflows ersetzt.
Kapitel 1: Die Grundlagen verstehen
Was ist Intelligente Datenerfassung?
Intelligente Datenerfassung (IDC) ist eine fortschrittliche Technologie, die künstliche Intelligenz (KI), maschinelles Lernen (ML) und Verarbeitung natürlicher Sprache (NLP) nutzt, um Daten aus verschiedenen Dokumenttypen automatisch zu identifizieren, zu extrahieren und zu strukturieren.
Anders als traditionelle Lösungen, die Dokumentbilder lediglich in Rohtext umwandeln, “verstehen” IDC-Systeme den Kontext. Sie unterscheiden zwischen einem Rechnungsbetrag und einer Telefonnummer, selbst wenn sich Dokumentformate erheblich unterscheiden.
Die Entwicklung der Datenautomatisierung
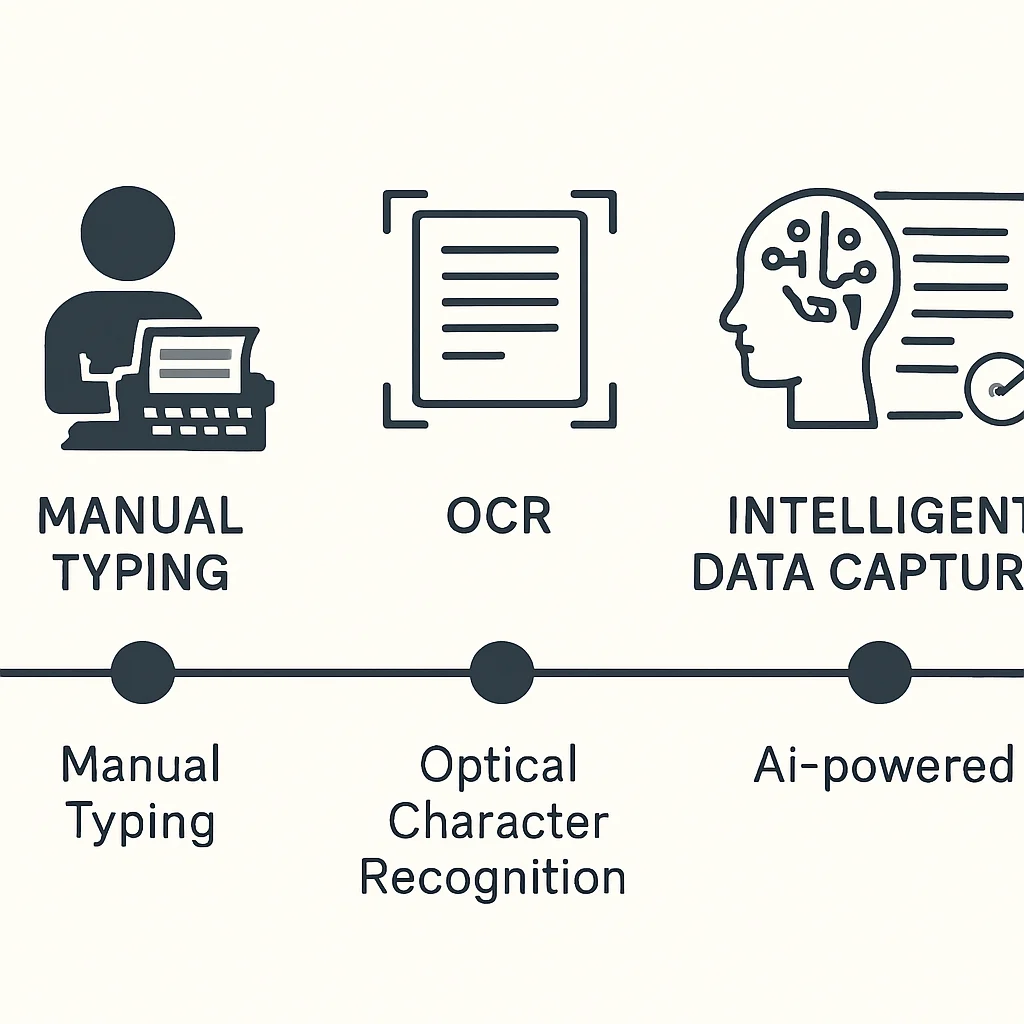
Der Weg dorthin umfasste drei Phasen:
- Manuelle Dateneingabe: Menschen lesen Dokumente und tippen Informationen in Datenbanken - langsam, teuer und fehleranfällig.
- Traditionelles OCR: Software erkennt Textzeichen in Bildern. Schneller als manuelle Eingabe, aber auf starre Vorlagen angewiesen, die bei geänderten Dokumentlayouts versagen.
- Intelligente Datenerfassung: Der moderne Standard, der OCR mit KI verbindet, lernt und sich anpasst, ohne starre Vorlagen zu benötigen.
Kapitel 2: Die Kerntechnologie erklärt
Schritt 1: Multichannel-Erfassung
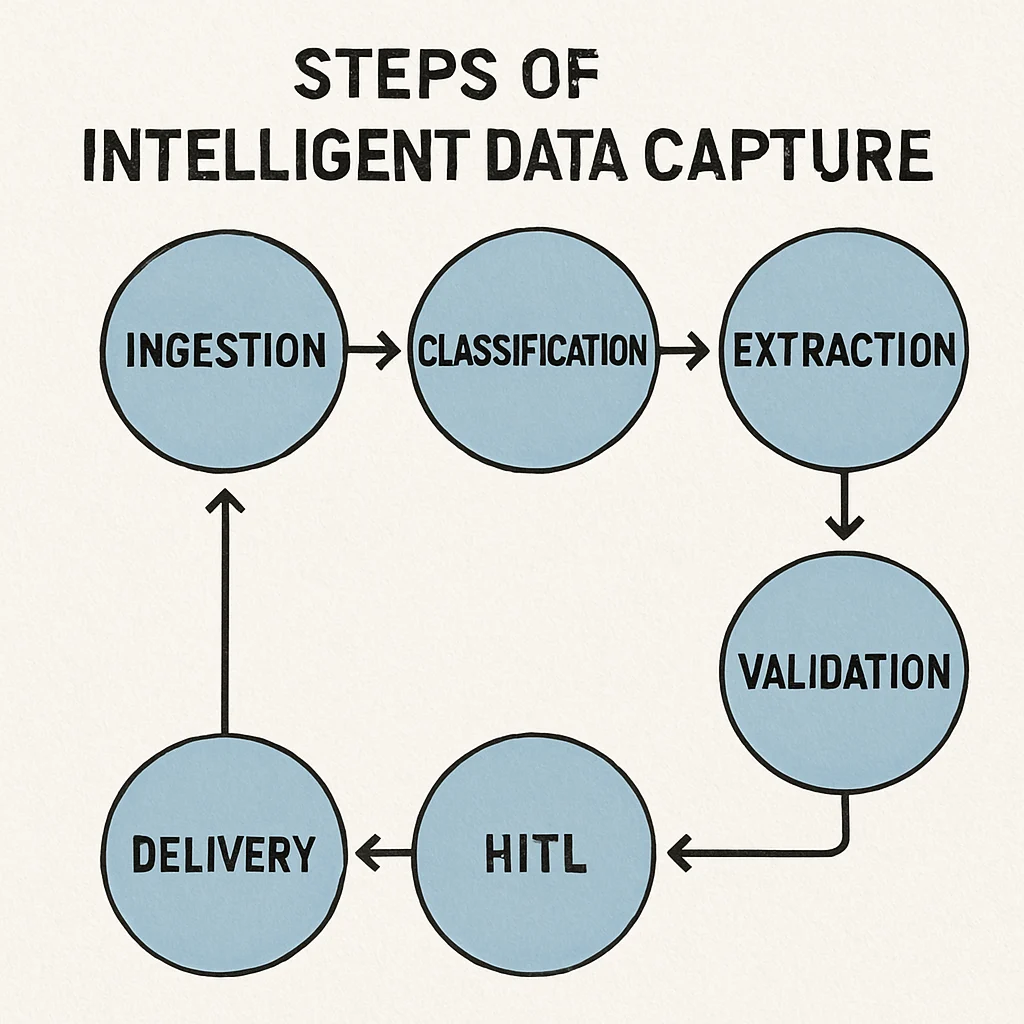
Dokumente kommen über zahlreiche Kanäle an: E-Mail-Postfächer, FTP-Server, Webportale und Uploads über mobile Apps. Intelligente Systeme überwachen diese Kanäle automatisch und erfassen Dokumente bei Ankunft, wodurch manuelle Dateiweiterleitung entfällt.
Schritt 2: Dokumentenklassifizierung und -weiterleitung
Das System bestimmt den Dokumenttyp - Bestellung, Steuerformular, Beschwerdebrief - mithilfe von maschinellem Lernen für die Dokumentenklassifizierung. KI analysiert Struktur, Schlüsselwörter und Layout, um sofort zu kategorisieren. Das System verbessert sich kontinuierlich, wenn menschliche Bediener gelegentliche Fehlklassifizierungen korrigieren.
Schritt 3: Kontextbezogene Datenextraktion
Nach der Klassifizierung extrahiert das System gezielte Informationen. Verarbeitung natürlicher Sprache bei der Dokumentenerfassung ermöglicht es der Software, unstrukturierten Text zu lesen und bestimmte Entitäten wie Namen, Daten, Klauseln und Finanzzahlen zu extrahieren.
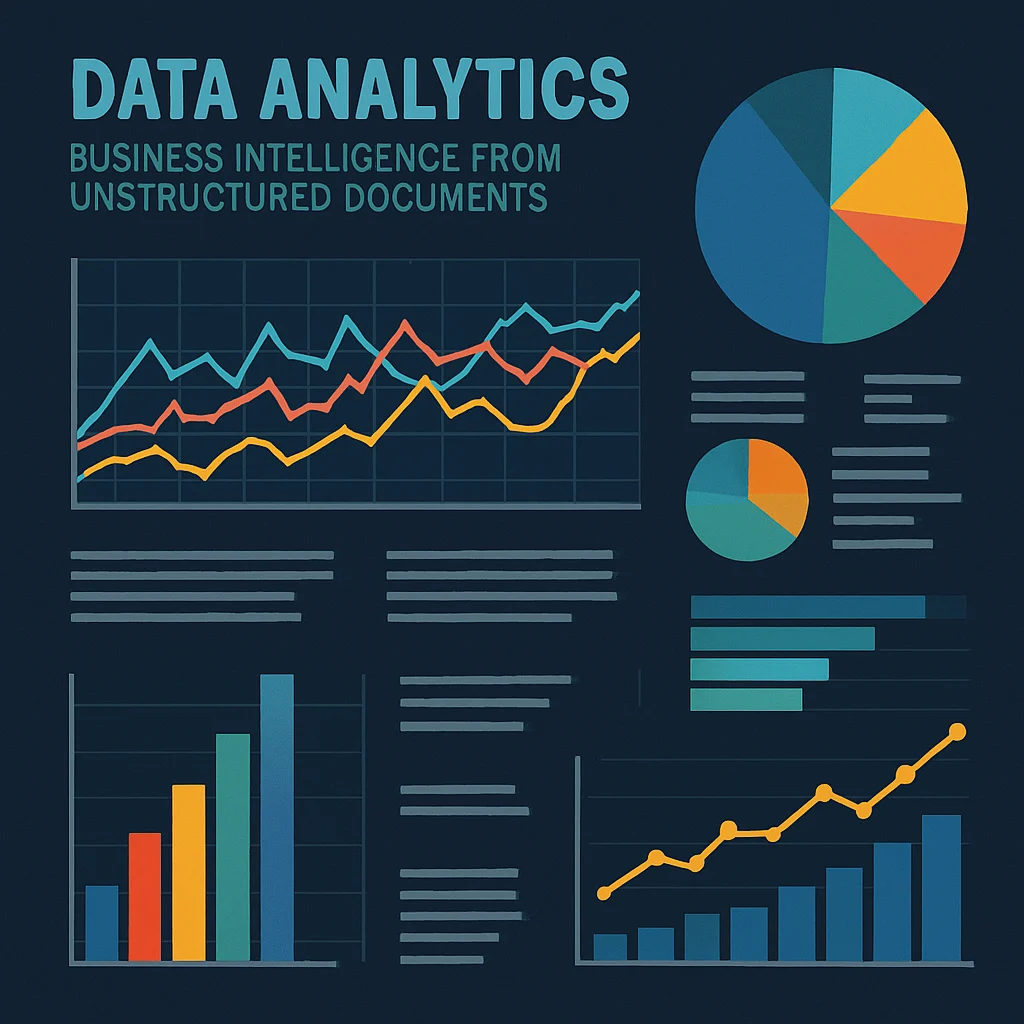
Das unterstützt die Verarbeitung unstrukturierter Daten für Business Intelligence. Rechtsteams können mit NLP automatisch Wettbewerbsverbotsklauseln aus Hunderten von Arbeitsverträgen extrahieren und Rohtext in eine strukturierte, auswertbare Datenbank verwandeln.
Schritt 4: Datenvalidierung und -anreicherung
Die Extraktion muss präzise sein. Die Software gleicht extrahierte Daten mit bestehenden Unternehmensdatenbanken ab. Werden aus einer Rechnung ein Lieferantenname und eine Bestellnummer extrahiert, prüft das System, ob die Bestellnummer zu diesem Lieferanten gehört.
Schritt 5: Human-in-the-Loop (Ausnahmebehandlung)
Stark beschädigte Dokumente oder Daten, die die Validierung nicht bestehen, werden für die menschliche Prüfung markiert. Dieser “Human-in-the-Loop”-Ansatz sichert 100 % Datengenauigkeit, während menschlicher Aufwand nur auf Ausnahmen konzentriert wird.
Schritt 6: Nahtlose Systemübergabe
Validierte Daten werden formatiert und in nachgelagerte Systeme übertragen - ERPs, CRMs oder Business-Intelligence-Dashboards - sofort einsatzbereit.
Kapitel 3: Intelligente Dokumentenverarbeitung im Vergleich zu OCR
Den Unterschied zwischen IDC und traditionellem OCR zu verstehen, ist für die Modernisierung von Unternehmen entscheidend.
Traditionelles OCR: Der blinde Leser
Standard-OCR wandelt pixelige Bilder in digitale Textzeichen um.
- Stärken: Hervorragend geeignet, um gescannte Bücher in durchsuchbare PDFs umzuwandeln.
- Schwächen: Kann nicht zwischen Geburtsdaten und Rechnungsfälligkeitsdaten unterscheiden. Ist auf zonales OCR (Vorlagenfelder) angewiesen. Die Extraktion schlägt fehl, wenn sich Dokumentlayouts ändern.
IDP / IDC: Der kognitive Leser
Intelligente Dokumentenverarbeitung nutzt OCR als Grundlagenschritt. Sobald der Text digitalisiert ist, übernimmt die KI.
- Kontextverständnis: Versteht, was der Text bedeutet.
- Vorlagenfrei: Benötigt keine Felder oder Regeln für jedes Lieferantenlayout.
- Anpassungsfähigkeit: Verarbeitet hochgradig unstrukturierte Dokumente wie E-Mails oder Verträge.
Die zentrale Erkenntnis für Unternehmen: Veraltetes OCR zwingt IT-Teams, Hunderte von Stunden mit der Pflege von Vorlagen zu verbringen. Der Umstieg auf intelligente Datenerfassung beseitigt diese Last und bewältigt Dokumentvariabilität mühelos.
Kapitel 4: Wichtige Vorteile für das moderne Unternehmen
1. Drastische Reduzierung von Fehlern bei der manuellen Dateneingabe
Menschen tun sich schwer mit repetitiver Erfassung großer Datenmengen. Ermüdung, Ablenkungen und Tippfehler verursachen Fehler mit schwerwiegenden Folgen - Compliance-Verstöße, verzögerte Zahlungen, beeinträchtigte Kundenerfahrungen.
Durch die Automatisierung dieses Prozesses erreichen Unternehmen nahezu null Fehler bei der manuellen Dateneingabe. Algorithmen ermüden nicht und liefern unabhängig vom Verarbeitungsvolumen konsistente Ergebnisse.
2. Steigerung von operativer Geschwindigkeit und Produktivität
Was ein Mensch in fünf Minuten liest, versteht, eintippt und prüft, erledigt ein intelligentes System in Bruchteilen einer Sekunde. Höhere Genauigkeit bei der Datenextraktion durch KI beschleunigt den gesamten Geschäftszyklus - schnellere Kreditgenehmigungen, zügigeres Kunden-Onboarding, beschleunigte Bewegungen in der Lieferkette.
3. Kognitive Automatisierung für die Rechnungsverarbeitung ermöglichen
Kognitive Automatisierung für die Rechnungsverarbeitung ermöglicht es Unternehmen, Rechnungen in Dutzenden von Sprachen und Währungen zu erfassen, automatisch mit Bestellungen und Wareneingangsberichten abzugleichen (Drei-Wege-Abgleich) und zur Genehmigung weiterzuleiten. Das verhindert Verzugsstrafen, sichert Skonti und gibt dem AP-Team Zeit für die Lieferantenbeziehungen frei.
4. Den Wert verborgener Daten erschließen
Schätzungen zufolge sind bis zu 80 % der Unternehmensdaten in unstrukturierten Formaten gefangen. Die Vorteile KI-gestützter Dokumentenextraktion gehen über Kosteneinsparungen hinaus und ermöglichen echte Business Intelligence. Die Führungsebene gewinnt beispiellose Einblicke in Markttrends und operative Engpässe.
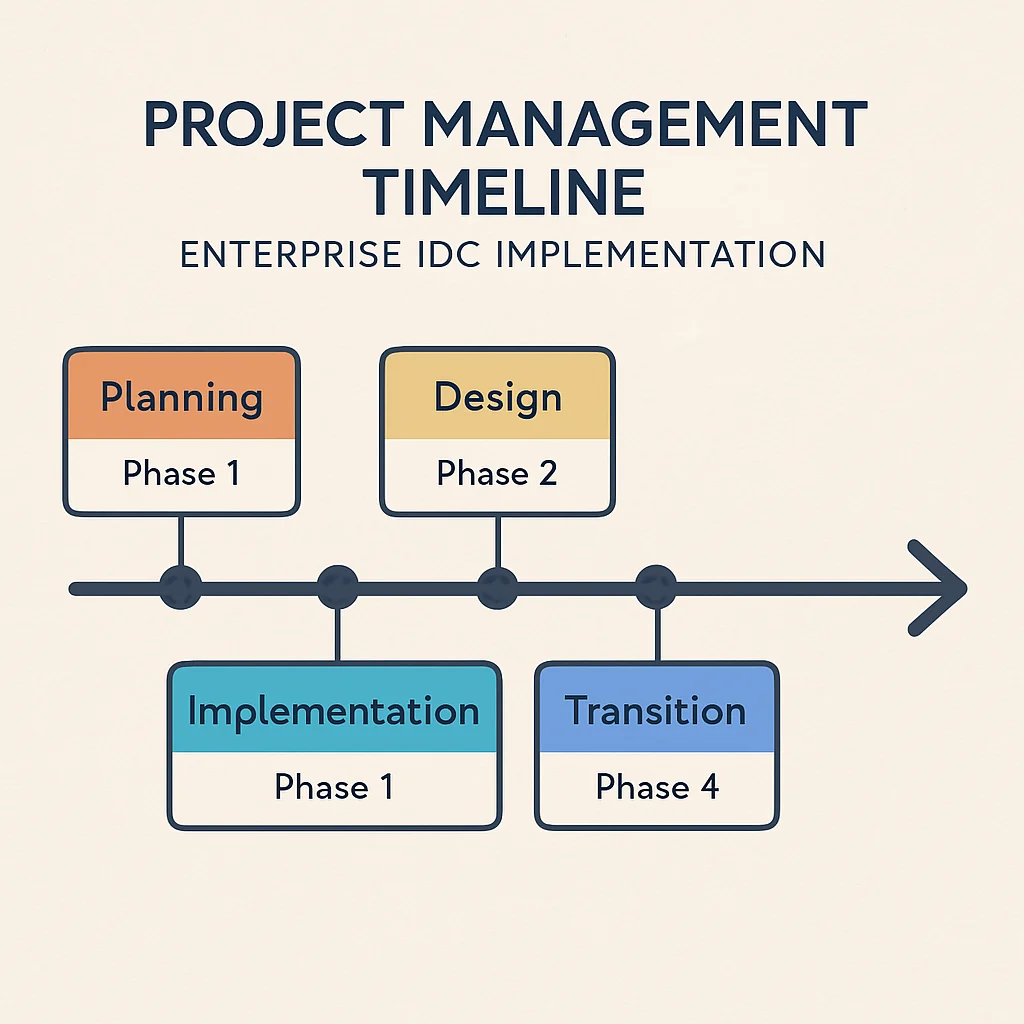
Kapitel 5: Roadmap zur Einführung von IDC im Unternehmen
Die erfolgreiche Einführung intelligenter Datenerfassung erfordert einen strategischen Ansatz über fünf Phasen.
Phase 1: Bedarfsanalyse und Priorisierung von Anwendungsfällen
Automatisieren Sie nicht alle Dokumente auf einmal. Identifizieren Sie Prozesse mit dem höchsten Dokumentenvolumen, dem größten manuellen Aufwand und den höchsten Fehlerquoten.
Kreditorenbuchhaltung, HR-Onboarding und die Bearbeitung von Kundenschäden sind traditionell hervorragende Ausgangspunkte. Kartieren Sie aktuelle manuelle Workflows Schritt für Schritt, um Basis-ROI-Berechnungen zu erstellen.
Phase 2: Die beste Software für intelligente Datenerfassung für Unternehmen auswählen
Achten Sie bei der Bewertung von Lösungen auf:
- Vortrainierte KI-Modelle: Sofort einsatzbereites Verständnis gängiger Geschäftsdokumente (Rechnungen, Belege, Ausweisdokumente)?
- Benutzerfreundlichkeit: Können Fachanwender (nicht nur Entwickler) das System über intuitive Oberflächen trainieren?
- Integrationsfähigkeiten: Robuste APIs und vorgefertigte Konnektoren für bestimmte Tech-Stacks?
Phase 3: Datensicherheit in automatisierten Erfassungssystemen priorisieren
Unternehmen verarbeiten sensible Informationen - personenbezogene Daten, geschützte Gesundheitsinformationen, vertrauliche Finanzdaten. Datensicherheit in automatisierten Erfassungssystemen darf kein nachträglicher Gedanke sein.
Stellen Sie sicher, dass Anbieter Folgendes bieten:
- Ende-zu-Ende-Verschlüsselung (Daten im Ruhezustand und bei der Übertragung).
- Rollenbasierte Zugriffskontrollen, die nur autorisierte Einsicht zulassen.
- Compliance-Zertifizierungen (SOC 2, GDPR, HIPAA).
- Funktionen zur Datenschwärzung, die sensible Informationen automatisch unkenntlich machen.
Phase 4: Automatisierte Erfassung mit Legacy-Systemen integrieren
Ein Datenerfassungssystem scheitert isoliert betrachtet. Die Integration automatisierter Erfassung mit Legacy-Systemen ist oft der komplexeste Aspekt der Einführung.
Es gibt zwei Ansätze:
- API-Integration: Die moderne, bevorzugte Methode, bei der IDC-Software direkt mit modernen SaaS-Datenbanken kommuniziert.
- RPA-Integration: Für Legacy-Systeme ohne APIs nutzen Robotic-Process-Automation-Bots strukturierte Daten, um Tastatureingaben auf Legacy-Oberflächen nachzuahmen.
Phase 5: Pilottests und Training des maschinellen Lernens
Führen Sie die Technologie in begrenzten Pilotgruppen ein. In dieser Phase begegnen Systeme neuartigen Dokumentformaten. Schulen Sie Mitarbeiter an Human-in-the-Loop-Oberflächen, um Ausnahmen zu korrigieren. Jede menschliche Korrektur trainiert die Modelle des maschinellen Lernens und erhöht die Autonomie des Systems.
Kapitel 6: Skalierung und Erfolgsmessung
Skalierbare Datenerfassungslösungen für große Organisationen gestalten
Mit der weltweiten Ausweitung der Einführung steigen die Dokumentenvolumina an Quartalsenden oder Feiertagen dramatisch an. Skalierbare Datenerfassungslösungen für große Organisationen sind cloud-nativ. Die Cloud-Infrastruktur fährt Rechenressourcen bei Spitzen automatisch hoch und in ruhigen Zeiten zur Kostenersparnis wieder herunter.
Skalierbare Lösungen ermöglichen den Einsatz zentraler “Centers of Excellence”, die steuern, wie Abteilungen Workflows aufbauen, und so Best Practices und Sicherheit konsistent halten.
Den ROI der intelligenten Dokumentenverarbeitung berechnen
Um eine Erweiterung zu rechtfertigen, weisen Sie der Führungsebene den Nutzen nach. Der ROI der intelligenten Dokumentenverarbeitung umfasst drei Dimensionen:
- Harte Kosteneinsparungen (Umverteilung von Vollzeitstellen): Berechnen Sie die für manuelle Dateneingabe aufgewendeten Stunden multipliziert mit den vollen Stundensätzen. Vergleichen Sie dies mit den Softwarelizenzkosten. (Hinweis: Die meisten Unternehmen verteilen Personal um, statt es abzubauen.)
- Einsparungen durch Fehlerbehebung: Berechnen Sie frühere Kosten durch Dateneingabefehler (Compliance-Strafen, Überzahlungen, verlorene Kunden) multipliziert mit der Reduzierung der Fehlerquote.
- Wert der Prozessbeschleunigung: Berechnen Sie den Umsatzgewinn durch 80 % schnellere Auftragsverarbeitung oder gesicherte Lieferantenrabatte durch schnelle Rechnungsverarbeitung.
Wichtige KPI-Übersicht:
- Quote durchgängiger Verarbeitung: Anteil der Dokumente, die durchgängig ohne menschliches Eingreifen verarbeitet werden.
- Durchschnittliche Bearbeitungszeit: Dauer von der Erfassung bis zur Übergabe.
- Kosten pro Dokument: Gesamte Systemkosten geteilt durch das Volumen.
Kapitel 7: Umsetzbare Tipps für den Unternehmenserfolg
- Change-Management berücksichtigen: Kommunizieren Sie, dass Automatisierung mühsame Aufgaben beseitigt und Mitarbeitern sinnvolle Arbeit ermöglicht, statt sie zu ersetzen.
- Quelldokumente optimieren: Gestalten Sie schwer lesbare interne Formulare neu. Kleine Layout-Anpassungen steigern die Quote durchgängiger Verarbeitung von 85 % auf 98 %.
- Feedbackschleifen etablieren: Planen Sie monatliche Reviews mit Human-in-the-Loop-Bedienern. Ihre Erkenntnisse zeigen wiederkehrende Lieferantenfehler und Systemverbesserungen auf.
Fazit
Die Ära der manuellen Dokumentenverarbeitung endet rasch. Der Übergang zu moderner Automatisierung ist für wettbewerbsfähige, agile und sichere Unternehmen unerlässlich.
Indem Organisationen verstehen, wie intelligente Datenerfassung funktioniert, nahtlose Legacy-System-Integration priorisieren und sich auf kontinuierliche Verbesserungen des maschinellen Lernens konzentrieren, verwandeln sie unstrukturierte Dokumente von einer operativen Last in einen strategischen Vorteil.
Nutzen Sie die Technologie, stärken Sie Ihre Belegschaft und erschließen Sie die Intelligenz, die in Unternehmensdaten verborgen liegt.
