Cos'è l'acquisizione intelligente dei dati?
Che cos'è l'acquisizione intelligente dei dati (IDC) e come l'automazione AI sostituisce l'inserimento manuale nei flussi documentali aziendali.
Capitolo 1: Comprendere le basi
Che cos’è l’acquisizione intelligente dei dati?
L’acquisizione intelligente dei dati (IDC) è una tecnologia avanzata che usa l’intelligenza artificiale (AI), il machine learning (ML) e l’elaborazione del linguaggio naturale (NLP) per identificare, estrarre e strutturare automaticamente i dati da vari tipi di documento.
A differenza delle soluzioni tradizionali che si limitano a convertire le immagini dei documenti in testo grezzo, i sistemi IDC “comprendono” il contesto. Distinguono tra il totale di una fattura e un numero di telefono, anche quando i formati dei documenti variano significativamente.
L’evoluzione degli strumenti di automazione dei dati
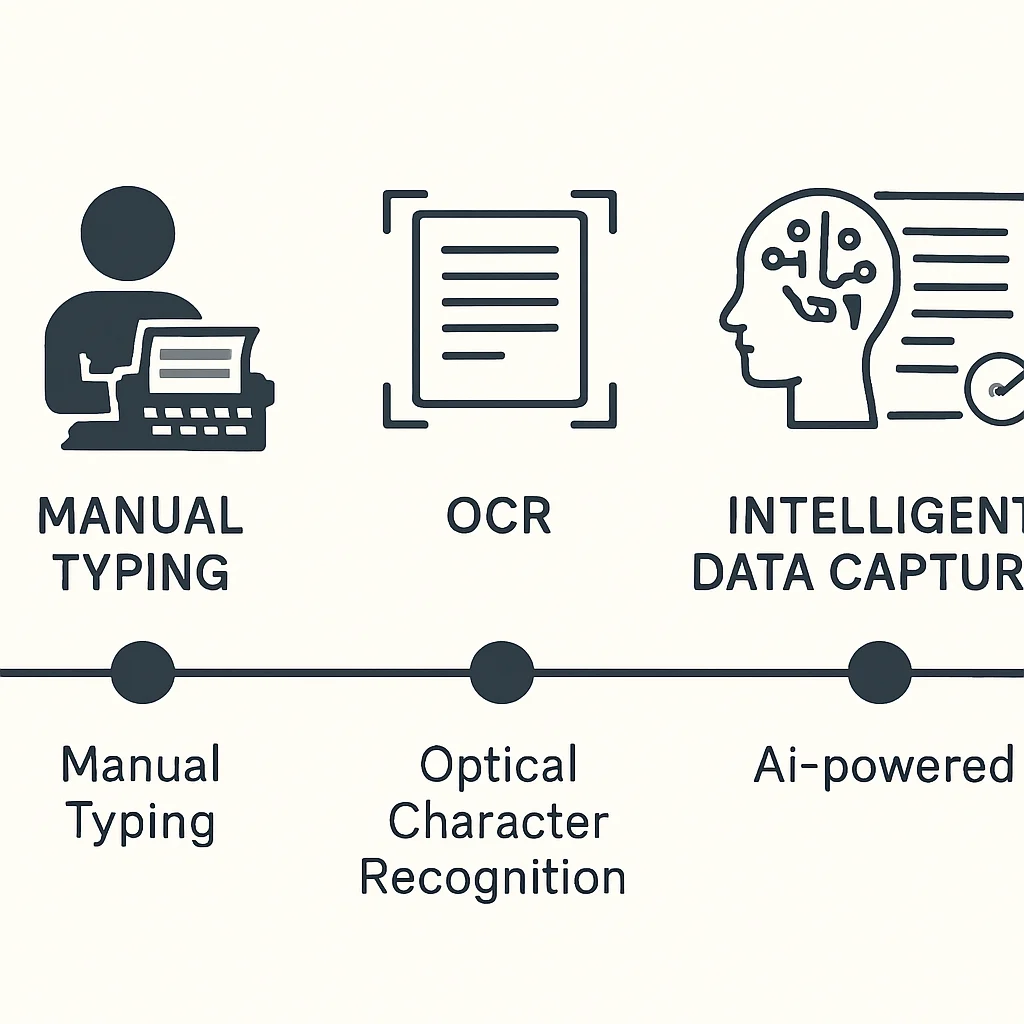
Il percorso ha coinvolto tre fasi:
- Inserimento manuale dei dati: persone che leggono fisicamente i documenti e digitano le informazioni nei database - lento, costoso e soggetto a errori.
- OCR tradizionale: software che riconosce i caratteri di testo nelle immagini. Sebbene più veloce dell’inserimento manuale, si basa su template rigidi che si rompono quando i layout dei documenti cambiano.
- Acquisizione intelligente dei dati: lo standard moderno che combina l’OCR con l’AI, imparando e adattandosi senza richiedere template rigidi.
Capitolo 2: la tecnologia di base spiegata
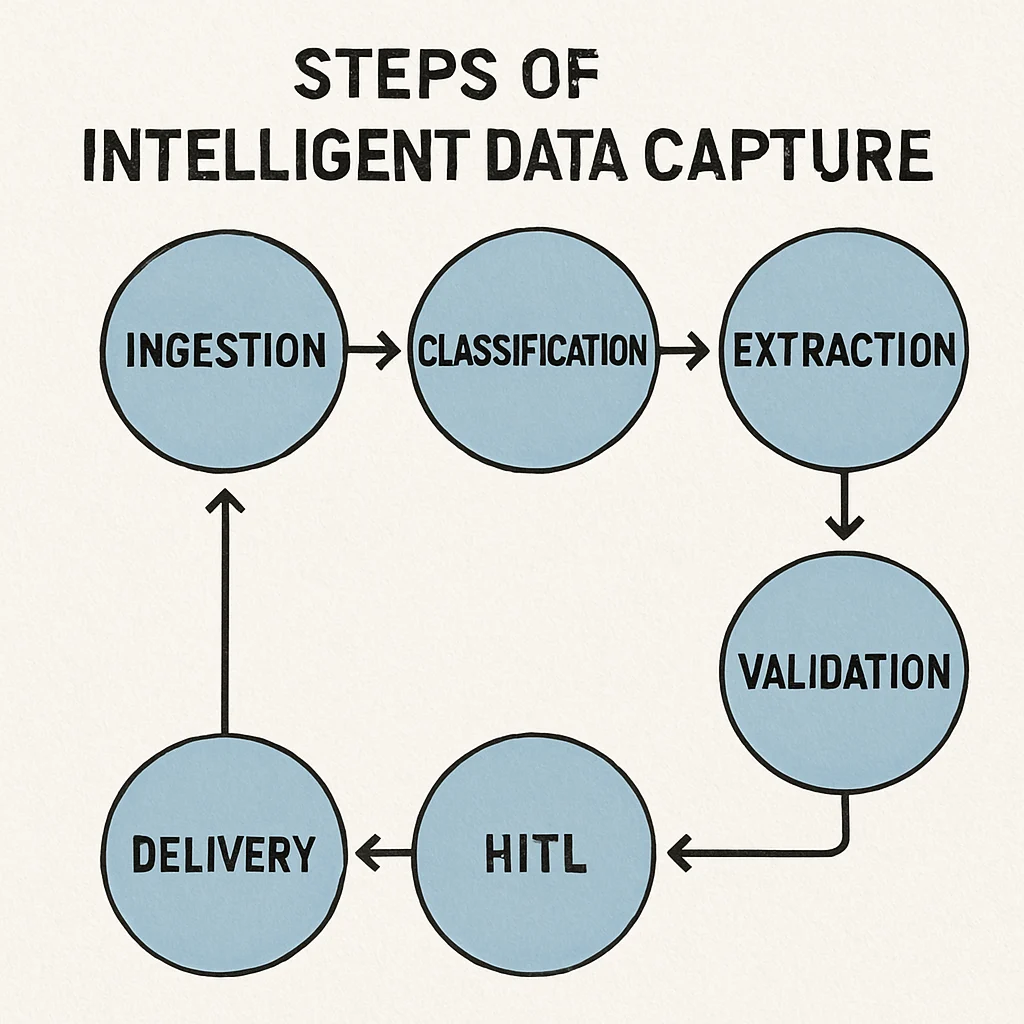
Fase 1: ingestione multicanale
I documenti arrivano attraverso innumerevoli canali: caselle email, server FTP, portali web e caricamenti da app mobile. I sistemi intelligenti monitorano automaticamente questi canali e acquisiscono i documenti al loro arrivo, eliminando l’instradamento manuale dei file.
Fase 2: classificazione e instradamento dei documenti
Il sistema determina il tipo di documento - ordine di acquisto, modulo fiscale, lettera di reclamo - usando il machine learning per la classificazione documentale. L’AI analizza struttura, parole chiave e layout per categorizzare istantaneamente. Il sistema migliora continuamente man mano che gli operatori umani correggono le occasionali classificazioni errate.
Fase 3: estrazione contestuale dei dati
Dopo la classificazione, il sistema estrae le informazioni mirate. L’elaborazione del linguaggio naturale nell’acquisizione documentale consente al software di leggere testo non strutturato ed estrarre entità specifiche come nomi, date, clausole e cifre finanziarie.
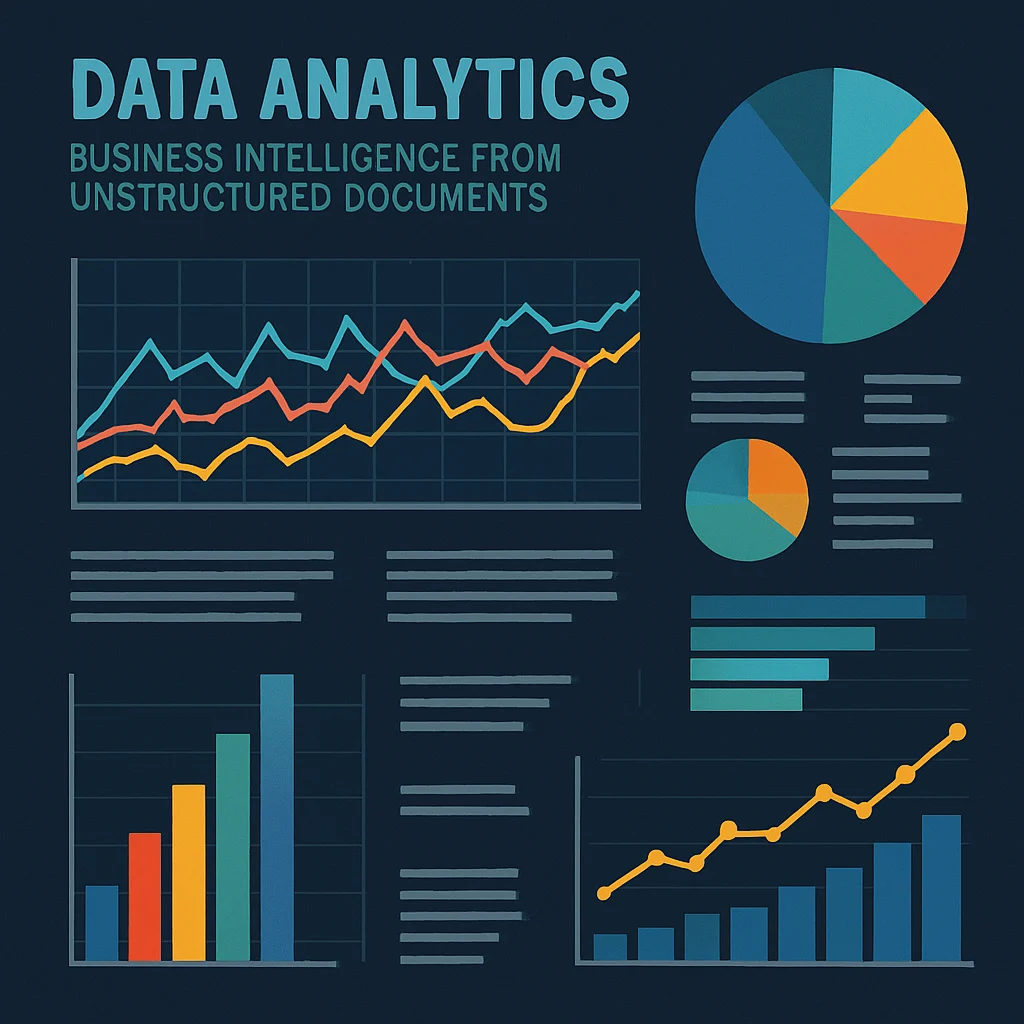
Questo supporta l’elaborazione di dati non strutturati per la business intelligence. I team legali possono usare l’NLP per estrarre automaticamente le clausole di non concorrenza da centinaia di contratti di lavoro, trasformando il testo grezzo in un database strutturato e analizzabile.
Fase 4: validazione e arricchimento dei dati
L’estrazione deve essere accurata. Il software incrocia i dati estratti con i database aziendali esistenti. Se da una fattura vengono estratti il nome del fornitore e il numero dell’ordine di acquisto, il sistema verifica che il numero d’ordine appartenga a quel fornitore.
Fase 5: human-in-the-loop (gestione delle eccezioni)
I documenti molto degradati o i dati che non superano la validazione vengono segnalati per la revisione umana. Questo approccio “human-in-the-loop” garantisce un’accuratezza dei dati del 100% concentrando lo sforzo umano solo sulle eccezioni.
Fase 6: consegna al sistema senza interruzioni
I dati validati vengono formattati e inviati ai sistemi a valle - ERP, CRM o dashboard di business intelligence - pronti per l’uso immediato.
Capitolo 3: elaborazione documentale intelligente contro OCR
Comprendere la differenza tra IDC e OCR tradizionale è fondamentale per la modernizzazione aziendale.
OCR tradizionale: il lettore cieco
Il riconoscimento ottico dei caratteri standard traduce le immagini pixelate in caratteri di testo digitali.
- Punti di forza: eccellente per convertire libri scansionati in PDF ricercabili.
- Punti deboli: non riesce a distinguere tra date di nascita e date di scadenza delle fatture. Si basa sull’OCR zonale (caselle template). L’estrazione fallisce quando i layout dei documenti cambiano.
IDP / IDC: il lettore cognitivo
L’elaborazione documentale intelligente usa l’OCR come fase fondamentale. Una volta digitalizzato il testo, l’AI prende il sopravvento.
- Consapevolezza contestuale: comprende ciò che il testo significa.
- Senza template: non richiede caselle o regole per ogni layout di fornitore.
- Adattabilità: elabora documenti altamente non strutturati come email o contratti.
Il punto chiave per le aziende: l’OCR legacy costringe i team IT a dedicare centinaia di ore alla manutenzione dei template. Passare all’acquisizione intelligente dei dati elimina questo onere e gestisce con facilità la variabilità dei documenti.
Capitolo 4: vantaggi chiave per l’azienda moderna
1. Ridurre drasticamente gli errori di inserimento manuale dei dati
Gli esseri umani faticano con la trascrizione ripetitiva e ad alto volume. Stanchezza, distrazioni ed errori di battitura causano errori con conseguenze gravi - violazioni di conformità, pagamenti ritardati, esperienze cliente compromesse.
Automatizzando questo processo, le aziende raggiungono errori di inserimento manuale dei dati quasi nulli. Gli algoritmi non si stancano, garantendo output coerenti indipendentemente dal volume di elaborazione.
2. Amplificare la velocità operativa e la produttività
Ciò che richiede a un essere umano cinque minuti per leggere, comprendere, digitare e verificare, richiede a un sistema intelligente frazioni di secondo. Migliorare l’accuratezza dell’estrazione dei dati con l’AI accelera l’intero ciclo di vita del business - approvazioni dei prestiti più rapide, onboarding dei clienti più veloce, movimenti della catena di fornitura più rapidi.
3. Abilitare l’automazione cognitiva per l’elaborazione delle fatture
L’automazione cognitiva per l’elaborazione delle fatture consente alle aziende di acquisire fatture in decine di lingue e valute, abbinarle automaticamente agli ordini di acquisto e ai rapporti di ricezione (three-way matching) e instradarle per l’approvazione. Questo previene le penali per pagamento tardivo, cattura gli sconti per pagamento anticipato e libera il personale AP per le relazioni con i fornitori.
4. Sbloccare il valore dei dati nascosti
Le stime suggeriscono che fino all’80% dei dati aziendali è intrappolato in formati non strutturati. I vantaggi dell’estrazione documentale basata su AI vanno oltre il risparmio sui costi per abilitare una vera business intelligence. I leader ottengono una visibilità senza precedenti sulle tendenze di mercato e sui colli di bottiglia operativi.
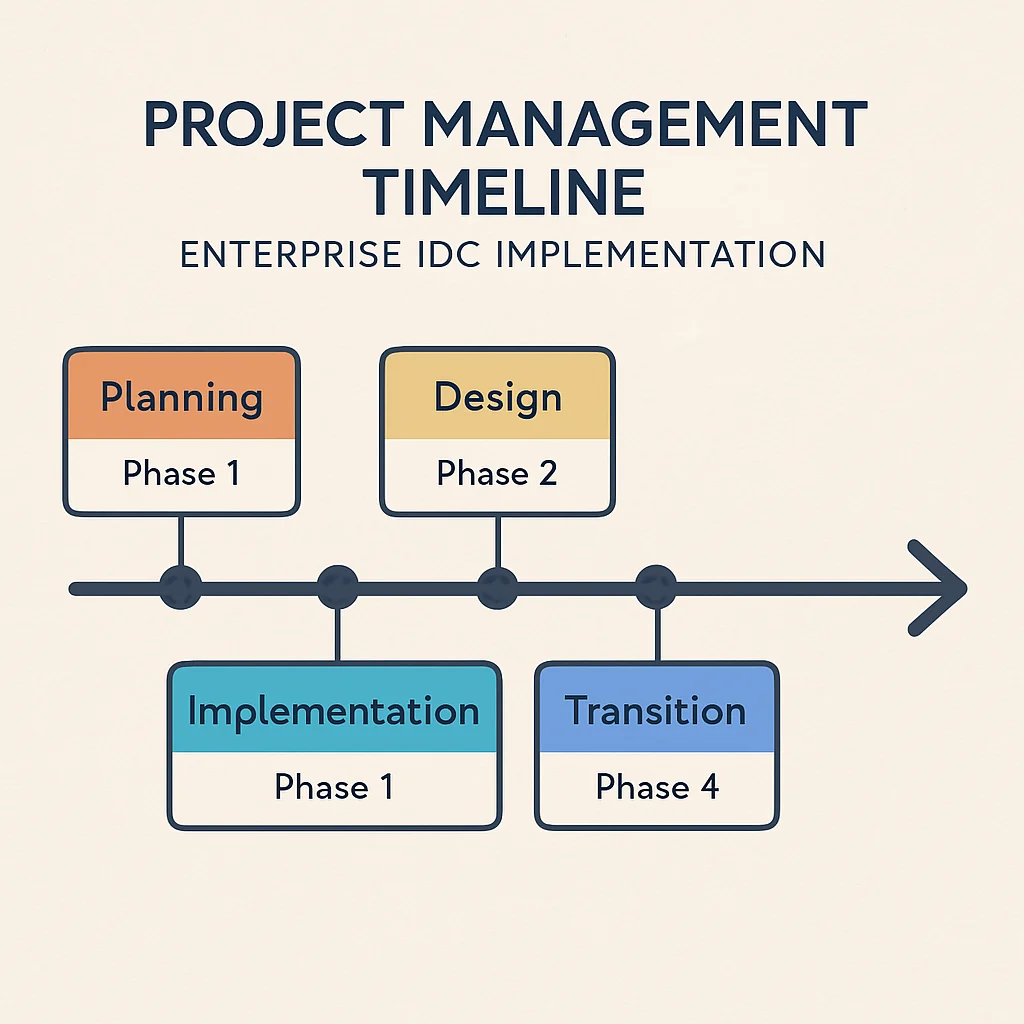
Capitolo 5: roadmap di implementazione IDC per l’azienda
Implementare con successo l’acquisizione intelligente dei dati richiede un approccio strategico su cinque fasi.
Fase 1: valutazione delle esigenze e priorizzazione dei casi d’uso
Non automatizzate tutti i documenti in una volta. Identificate i processi che soffrono del maggior volume documentale, del maggiore sforzo manuale e dei tassi di errore più elevati.
La contabilità fornitori, l’onboarding HR e l’elaborazione dei sinistri dei clienti sono tradizionalmente ottimi punti di partenza. Mappate i flussi di lavoro manuali attuali passo dopo passo per stabilire i calcoli di ROI di riferimento.
Fase 2: selezionare il miglior software di acquisizione intelligente dei dati per le aziende
Quando valutate le soluzioni, cercate:
- Modelli AI pre-addestrati: comprensione immediata dei documenti aziendali comuni (fatture, ricevute, documenti d’identità)?
- Facilità d’uso: gli utenti aziendali (non solo gli sviluppatori) possono addestrare il sistema tramite interfacce intuitive?
- Capacità di integrazione: API robuste e connettori preconfigurati per stack tecnologici specifici?
Fase 3: dare priorità alla sicurezza dei dati nei sistemi di acquisizione automatizzata
Le aziende gestiscono informazioni sensibili - PII, informazioni sanitarie protette, dati finanziari proprietari. La sicurezza dei dati nei sistemi di acquisizione automatizzata non può essere un ripensamento.
Assicuratevi che i fornitori offrano:
- Crittografia end-to-end (dati a riposo e in transito).
- Controlli di accesso basati sui ruoli che garantiscono la sola visualizzazione autorizzata.
- Certificazioni di conformità (SOC 2, GDPR, HIPAA).
- Funzionalità di redazione dei dati che oscurano automaticamente le informazioni sensibili.
Fase 4: integrare l’acquisizione automatizzata con i sistemi legacy
Un sistema di acquisizione dati fallisce se isolato. L’integrazione dell’acquisizione automatizzata con i sistemi legacy è spesso l’aspetto più complesso dell’implementazione.
Esistono due approcci:
- Integrazione API: il metodo moderno e preferito, in cui il software IDC comunica direttamente con i moderni database SaaS.
- Integrazione RPA: per i sistemi legacy privi di API, i bot di Robotic Process Automation usano dati strutturati per simulare la digitazione sulle interfacce legacy.
Fase 5: test pilota e addestramento del machine learning
Distribuite la tecnologia a gruppi pilota limitati. Durante questa fase, i sistemi incontrano nuovi formati di documento. Formate il personale sulle interfacce human-in-the-loop per correggere le eccezioni. Ogni correzione umana addestra i modelli di machine learning, aumentando l’autonomia del sistema.
Capitolo 6: scalare e misurare il successo
Progettare soluzioni di acquisizione dati scalabili per le grandi organizzazioni
Man mano che il rollout si espande a livello globale, i volumi documentali aumentano drasticamente alla fine dei trimestri fiscali o durante le festività. Le soluzioni di acquisizione dati scalabili per le grandi organizzazioni sono cloud-native. L’infrastruttura cloud attiva automaticamente le risorse di calcolo durante i picchi e le riduce nei periodi tranquilli per risparmiare sui costi.
Le soluzioni scalabili consentono di distribuire “centri di eccellenza” centralizzati che governano il modo in cui i reparti costruiscono i flussi di lavoro, garantendo che best practice e sicurezza rimangano coerenti.
Calcolare il ROI dell’elaborazione documentale intelligente
Per giustificare l’espansione, dimostrate il valore alla leadership. Il ROI dell’elaborazione documentale intelligente si articola su tre dimensioni:
- Risparmi sui costi diretti (riallocazione FTE): calcolate le ore dedicate all’inserimento manuale dei dati moltiplicate per le tariffe orarie complete. Confrontate con i costi di licenza del software. (Nota: la maggior parte delle aziende rialloca il personale invece di ridurlo.)
- Risparmi da correzione degli errori: calcolate i costi passati degli errori di inserimento dati (multe di conformità, sovrapagamenti, clienti persi) moltiplicati per le riduzioni del tasso di errore.
- Valore dell’accelerazione dei processi: calcolate i ricavi ottenuti elaborando gli ordini l’80% più velocemente, o gli sconti dei fornitori catturati grazie all’elaborazione rapida delle fatture.
Tracker dei KPI chiave:
- Tasso STP: percentuale di documenti elaborati end-to-end senza intervento umano.
- Tempo medio di elaborazione: durata dall’ingestione alla consegna.
- Costo per documento: costo totale del sistema diviso per il volume.
Capitolo 7: consigli pratici per il successo aziendale
- Affrontate il change management: comunicate che l’automazione elimina le attività noiose, mettendo il personale nelle condizioni di svolgere un lavoro significativo invece di sostituirlo.
- Ottimizzate i documenti sorgente: riprogettate i moduli interni difficili da leggere. Piccole modifiche al layout aumentano i tassi STP dall’85% al 98%.
- Stabilite cicli di feedback: programmate revisioni mensili con gli operatori human-in-the-loop. I loro spunti individuano errori ricorrenti dei fornitori e miglioramenti al sistema.
Conclusione
L’era dell’elaborazione documentale manuale sta finendo rapidamente. Passare all’automazione moderna è imperativo per le aziende competitive, agili e sicure.
Comprendendo come funziona l’acquisizione intelligente dei dati, dando priorità a un’integrazione senza interruzioni con i sistemi legacy e concentrandosi su miglioramenti continui del machine learning, le organizzazioni trasformano i documenti non strutturati da onere operativo a vantaggio strategico.
Abbracciate la tecnologia, responsabilizzate la forza lavoro e sbloccate l’intelligenza nascosta nei dati aziendali.
