Softwaregids voor documentclassificatie
Een leveranciersneutrale gids voor software voor documentclassificatie: hoe u nauwkeurigheid test op uw eigen documenten en wat het echt kost.
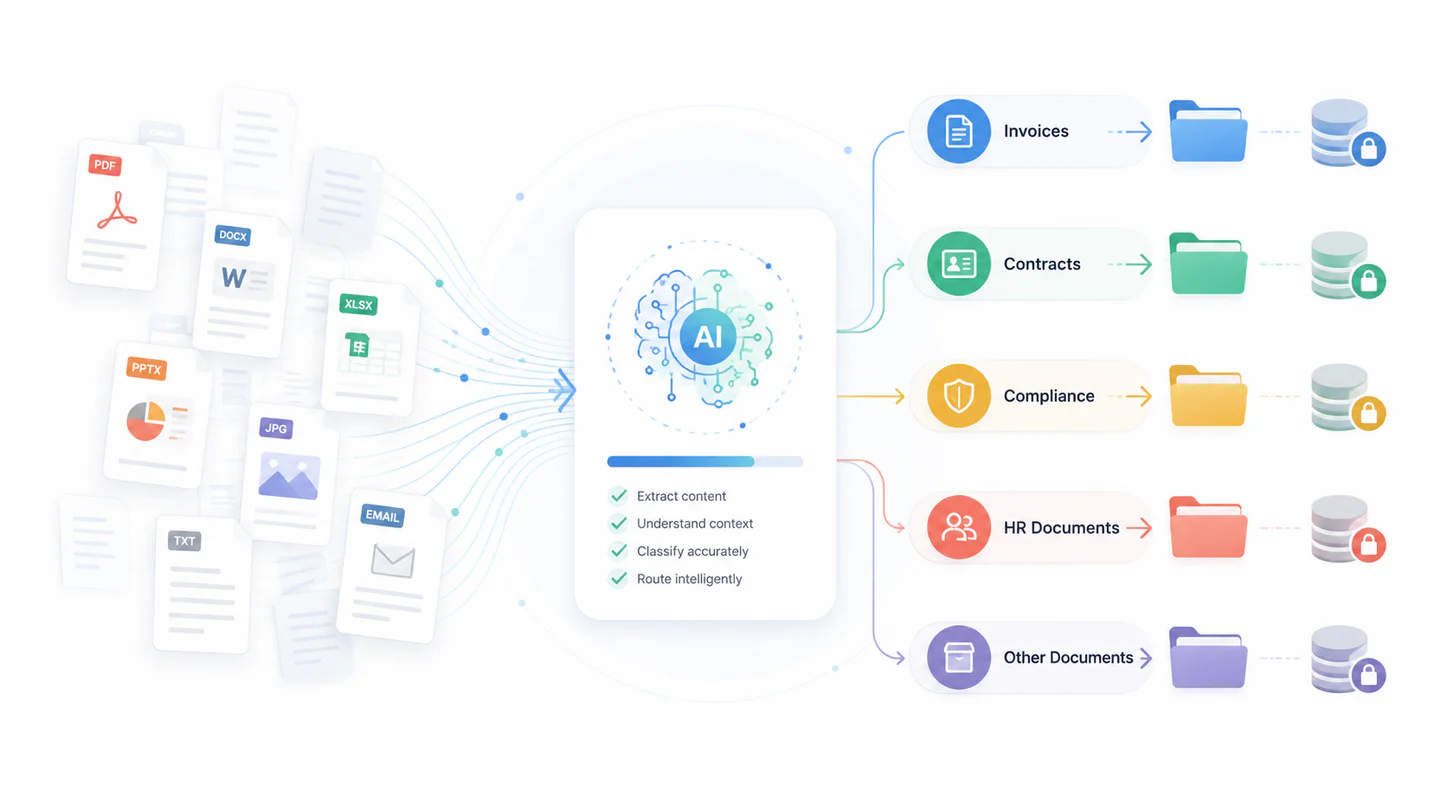
De meeste demo’s van software voor documentclassificatie zien er hetzelfde uit. Een leverancier laat een map facturen en contracten in een portaal vallen, het scherm vult zich met netjes gesorteerde documenten, en een cijfer zoals 97 procent verschijnt. Dan koopt u het, richt u het op uw eigen archief, en valt het cijfer uiteen.
Dat gat is waar deze gids over gaat. Niet wat software voor documentclassificatie is, maar hoe u twee producten van elkaar onderscheidt wanneer beide AI-classificatie, kant-en-klare integraties en beveiliging voor de onderneming claimen, en hoe u een evaluatie uitvoert die voorspelt wat u werkelijk in productie krijgt.
De korte versie: koop niet op basis van nauwkeurigheid. Koop op basis van het straight-through processing-percentage, gemeten op uw eigen documenten, met uw eigen beoordelaars in de lus.
Wat software voor documentclassificatie werkelijk doet
Software die documentclassificatie automatiseert, wijst elk binnenkomend document toe aan een zakelijke categorie op basis van wat het bevat. Dit is een inkooporder, dat is een betalingsspecificatie, dit is een ondertekende geheimhoudingsovereenkomst. Het werkt over gestructureerde formulieren, semigestructureerde documenten zoals facturen waar de velden consistent zijn maar de lay-out niet, en volledig ongestructureerde content zoals correspondentie. Het is een stap in een keten die leveranciers en kopers vaak door elkaar halen:
- OCR zet pixels om in tekens. Het heeft geen idee wat het document is.
- Classificatie bepaalt om welk soort document het gaat.
- Extractie haalt genoemde waarden eruit zodra het soort bekend is.
De volgorde is belangrijker dan hij lijkt. Extractieregels zijn meestal klassespecifiek, dus een verkeerde classificatie vergiftigt alles stroomafwaarts. Label een factuur als een pakbon en elke extractieregel vuurt tegen het verkeerde sjabloon, de verkeerde goedkeuringsketen start, en de fout komt weken later naar boven als een betaling die niemand kan traceren.
De nuttige output is daarom niet het label op zichzelf, maar het label plus een confidence score. Een classifier die het meestal bij het rechte eind heeft en zwijgt over zijn fouten, is een risico. Een classifier die zijn eigen onzekerheid rapporteert, kan voor de rest worden vertrouwd, omdat u de twijfelachtige documenten naar een persoon kunt routeren en de zekere met rust kunt laten.
Drie benaderingen, en wanneer elk het juiste antwoord is
Bijna elk product op de markt is een van deze drie, of een mengvorm. Leveranciers zeggen zelden welke, dus vraag ernaar.
| Benadering | Hoe het beslist | Sterkst wanneer | Zwakst wanneer |
|---|---|---|---|
| Regelgebaseerd | Trefwoorden, reguliere expressies, barcodes, lay-outzones | De documentset is stabiel en gestructureerd, en elke beslissing moet uitlegbaar zijn | Formaten verschuiven, of een leverancier wijzigt een sjabloon en de regels stoppen geruisloos met matchen |
| Getrainde machine learning | Getrainde modellen geleerd van uw gelabelde voorbeelden, soms startend vanuit een voorgetrainde basis | U heeft volume en geschiedenis, en klassen zijn visueel of taalkundig onderscheidend | U heeft geen gelabelde data, of een nieuwe klasse verschijnt met slechts een handvol voorbeelden |
| Large language model | Een voorgetraind model leest het document en redeneert erover, vaak zonder trainingsvoorbeelden | Klassen zijn in woorden beschreven in plaats van geleerd, lange staart van zeldzame typen, gemengde talen | Kosten per document zijn belangrijk bij hoog volume, of u heeft dezelfde input nodig om steeds hetzelfde antwoord te geven |
Twee praktische opmerkingen. Regelgebaseerde classificatie is ouderwets en toch de juiste keuze voor een gebarcodeerde, hoogvolume, onveranderlijke stroom, omdat het goedkoop, snel en controleerbaar is. En een taalmodel dat goed classificeert zonder trainingsdata kan bij tien miljoen documenten per jaar nog steeds het verkeerde antwoord zijn, puur op basis van kosten per eenheid. Vraag welke benadering welk deel van uw mix afhandelt, en wees achterdochtig bij een enkel antwoord voor alles.
Het straight-through processing-percentage is het cijfer om op te kopen
Nauwkeurigheid is een enkel cijfer dat de onderliggende verdeling verbergt, en dat is precies de informatie die u nodig heeft. De metric die uw operationele kosten voorspelt, is het straight-through processing-percentage: het aandeel documenten dat het systeem doorloopt zonder dat een persoon eraan komt, bij een betrouwbaarheidsdrempel die u tegenover een auditor kunt verdedigen.
De twee lopen snel uiteen. Vergelijk twee kandidaten op tienduizend documenten per maand, een over het geheel nauwkeuriger en een beter gekalibreerd over zijn eigen zekerheid:
| Nauwkeurig maar aarzelend | Minder nauwkeurig, goed gekalibreerd | |
|---|---|---|
| Nauwkeurigheid volgens de koptekst | 95 procent | 90 procent |
| Documenten automatisch afgehandeld bij uw drempel | 6.000 | 8.500 |
| Documenten in de beoordelingswachtrij | 4.000 | 1.500 |
| Beoordelaarsminuten bij 40 seconden elk | 2.667 | 1.000 |
De eerste kandidaat wint de demo en kost u elke maand 1.667 extra beoordelaarsminuten, ongeveer een voltijdspersoon. De tweede is minder nauwkeurig en veel goedkoper om te draaien, omdat hij zeker is wanneer hij gelijk heeft en eerlijk wanneer dat niet zo is. Kalibratie, niet ruwe nauwkeurigheid, is waarvoor u betaalt.
Vraag dan waar de fouten terechtkomen. Een verwarringsmatrix vertelt u dat; een percentage nooit. Het ene pakbon verkeerd archiveren als een ander pakbon is ruis. Een ondertekend contract verkeerd archiveren als een factuur kan een verplichting buiten uw bewaarschema en buiten het rechtenmodel plaatsen dat het had moeten beschermen. Fouten zijn niet inwisselbaar, en de kosten van een vergissing hangen volledig af van welke twee klassen zijn verwisseld.
Vraag dus elke leverancier om drie dingen: de verwarringsmatrix op uw eigen steekproef, de betrouwbaarheidsdrempel die is gebruikt om het automatische-afhandelingscijfer te produceren, en het resulterende straight-through-percentage. Een leverancier die u alleen een enkel nauwkeurigheidscijfer wil geven, vertelt u iets.
Acht criteria om elke kandidaat op te scoren
Productfunctielijsten convergeren snel. Wat kandidaten onderscheidt, is hoe elke mogelijkheid zich gedraagt op uw documenten, bij uw volumes, onder uw auditors. Scoor elke kandidaat op deze acht, en sta erop ze te testen tegen uw eigen steekproefset in plaats van het democorpus van de leverancier.
| Criterium | Hoe het te testen | Hoe een goed antwoord eruitziet |
|---|---|---|
| Classificatienauwkeurigheid | Verwerk enkele honderden van uw eigen documenten, inclusief slechte scans en meertalige bestanden | Nauwkeurigheid op uw corpus blijft binnen een paar punten van het democijfer |
| Tijd tot eerste bruikbare model | Tel kalenderdagen van gegevensoverdracht tot een werkende classifier | Weken in plaats van kwartalen, zonder een open-eindig dienstverleningstraject |
| Integratiediepte | Schrijf resultaten terug in uw ECM, ERP of dossiersysteem, niet alleen lezen uit een bewaakte map | Bidirectionele synchronisatie met veldniveau-mapping en gedefinieerde foutafhandeling |
| Lus voor menselijke beoordeling | Routeer documenten met lage betrouwbaarheid naar een beoordelaar en volg het correctiepad | Correcties voeden hertraining, en de wachtrij is zichtbaar voor operations |
| Auditbewijs | Vraag wie elk document heeft geclassificeerd, wanneer, en op welke modelversie | Een per-document spoor dat u kunt exporteren voor een auditor |
| Dataresidentie | Bevestig waar documenten worden verwerkt en of ze gedeelde modellen trainen | Verwerking in uw regio, in uw tenant, standaard zonder training op uw content |
| Gedrag bij piekbelasting | Test de piek aan het einde van de maand of het jaar, niet de gemiddelde dag | Doorvoer degradeert voorspelbaar tegen een gedocumenteerd plafond |
| Kosten in jaar drie | Modelleer volumegroei, herverwerking en beoordelaarstijd, niet alleen licentiekosten | Kosten per document dalen naarmate het volume stijgt |
Een proof of concept uitvoeren die u iets vertelt
De meeste proofs of concept zijn theater. Ze gebruiken een samengestelde steekproef, worden gescoord door de leverancier, en slagen. Een nuttige is zo opgezet dat hij kan falen.
- Trek de steekproef willekeurig. Minimaal enkele honderden documenten, getrokken uit een echte periode, niet gekozen door wie het meest enthousiast is over het project.
- Neem de lelijke exemplaren mee. Telefoonfoto’s, faxen, documenten die ondersteboven zijn gescand, meerdocument-PDF’s die eerst gesplitst moeten worden voordat er iets anders kan gebeuren, formulieren met de hand ingevuld, en elke taalmix die u daadwerkelijk ontvangt. Deze uitsluiten is hoe een proof of concept een cijfer oplevert dat u niet kunt gebruiken.
- Houd een testset achter die de leverancier nooit ziet. Als hetzelfde team afstelt en scoort, meet u hun afstelling, niet het product.
- Schrijf slagen en falen op voordat u begint. Noem het straight-through-percentage, het maximaal aanvaardbare percentage voor de specifieke verwisselingen die u zouden schaden, en de beoordelaarsminuten die u zich kunt veroorloven. Dit achteraf overeenkomen is hoe een marginaal resultaat een aankoop wordt.
- Meet beoordelaarsminuten, niet alleen nauwkeurigheid. Meet hoe lang een correctie daadwerkelijk duurt in de interface die mensen elke dag zullen gebruiken.
- Draai de piek. Stuur een volume van het einde van de maand erdoorheen en kijk wat er gebeurt met latency en met de wachtrij.
Vraag wat er gebeurt wanneer een documenttype verschijnt dat nooit in de trainingsset zat, en kijk of het systeem zegt dat het het niet weet of stilzwijgend de dichtstbijzijnde klasse kiest. Het tweede gedrag is veel duurder, en u ziet het alleen als u ervoor test.
Implementatie: cloud, on-premise, of hybride
Generieke voor- en nadelen helpen hier niet veel. Vier vragen bepalen het in de praktijk.
Waar mag content worden verwerkt, en traint het iets? Dit is meestal de bindende beperking in gereguleerde sectoren en degene die u als eerste moet vastleggen. Zorg dat schriftelijk is vastgelegd dat uw documenten niet worden gebruikt om gedeelde modellen te trainen, als dat is wat u nodig heeft.
Hoe ziet de piek eruit? Elastische capaciteit is het duidelijkste argument voor cloud, en het is alleen belangrijk als uw volume echt piekt.
Waar moet het naar schrijven, en hoe ver weg is dat? Als het systeem van record on-premise staat, voegt classificatie elders een retourreis toe aan elk document en een nieuwe faalmodus ertussen.
Wie patcht het? On-premise betekent dat uw team upgrades, modelupdates en de beveiligingspositie zelf beheert. Dat is een echte personeelskost, en het is de regel die het vaakst uit de vergelijking wordt weggelaten.
Hybride verdient zijn complexiteit wanneer een klasse content echt niet weg kan, en de rest echt profiteert van elasticiteit. Als geen van beide waar is, is hybride twee systemen om te onderhouden in plaats van een. Onze gids over cloudgebaseerd contentmanagement voor de onderneming werkt dezelfde afweging uit voor het bredere contentplatform.
Integratie gaat over terugschrijven, niet over uitlezen
Elke leverancier integreert. Bijna allemaal bedoelen ze dat ze een map of postbus kunnen bekijken, wat de gemakkelijke helft is en op zichzelf bijna nutteloos. De classificatie creëert pas waarde zodra het label, de betrouwbaarheidsscore en het auditspoor terechtkomen in het systeem waar het werk daadwerkelijk gebeurt.
Vraag door op vier dingen:
- Mapping op veldniveau. Welk doelveld ontvangt de klasse, en welk de betrouwbaarheidsscore? Als betrouwbaarheid onderweg wegvalt, bent u het vermogen kwijt om te triëren.
- Foutafhandeling. Wat gebeurt er wanneer het doelsysteem het schrijven weigert? Een retrybeleid, een dead-letter-wachtrij en een melding, of een stil verlies.
- Idempotentie. Als hetzelfde document twee keer wordt verwerkt, krijgt u dan een record of twee? Herverwerking is normaal, dus dit komt in maand twee naar voren, niet in jaar twee.
- Herclassificatie. Wanneer een beoordelaar een label corrigeert, komt de correctie dan terecht bij het systeem van record, of alleen in de trainingsset? Een systeem dat continu verbetert op basis van correcties is weinig waard als die correcties de plek waar het bedrijf daadwerkelijk leest nooit bereiken.
Het patroon om naar te streven is dat classificatie een stap is binnen een bredere intelligente documentverwerking-flow in plaats van een losstaande tool, zodat bewaring, rechten en routering allemaal het label overnemen in plaats van opnieuw handmatig te worden ingesteld. Die overname is waar het grootste deel van het rendement werkelijk vandaan komt, en dit wordt verder behandeld in ons overzicht van document- en contentmanagement.
Wat het kost, en waar de kosten werkelijk zitten
Licentiekosten zijn de regel die iedereen vergelijkt en zelden de grootste. Over drie jaar ziet de werkelijke verdeling er meestal zo uit:
- Beoordelaarstijd. Direct bepaald door het straight-through-percentage. Daarom is het nauwkeurigheidsgesprek hierboven eigenlijk een kostengesprek.
- Integratiebouw. Resultaten terugschrijven in een systeem van record, met mapping en foutafhandeling, is een project. Begroot het eenmalig en verwacht het opnieuw te bekijken wanneer het doelsysteem upgrade.
- Taxonomieonderhoud. Klassen verschuiven. Iemand moet dat bezitten, en als niemand dat doet, verslechtert de nauwkeurigheid geruisloos.
- Herverwerking. Modelupdates en gecorrigeerde taxonomieën betekenen het opnieuw draaien van historisch volume. Vraag of herverwerking wordt gemeten.
- Licentie en infrastructuur. Per document, per pagina, per gebruiker of per core, en de vorm is net zo belangrijk als het tarief.
Het gezonde signaal is dat de kosten per document dalen naarmate het volume stijgt. Als een offerte voor altijd lineair schaalt, financiert u de marge van iemand anders op uw groei. Modelleer jaar drie, niet jaar een, en vraag wat er met de prijs gebeurt wanneer het volume verdubbelt.
Waar classificatie het eerst rendement oplevert
De waarde toont zich overal waar een label een stroomafwaartse beslissing ontsluit in plaats van alleen een map op te ruimen.
In de zorg scheidt classificatie klinische van administratieve content op het moment van vastlegging, zodat records onder de juiste bewaarregel en het juiste toegangsbeleid vallen zonder dat een persoon dat kiest. In juridische zaken en contractering onderscheidt het een uitgevoerde overeenkomst van een concept, wat het verschil is tussen een bindende verplichting en een werkdossier. In financiële dienstverlening is de drijfveer meestal bewijs: aan een toezichthouder tonen welke documenten een besluit onderbouwden, en wanneer. In het onderwijs is het volume, met toelatingscycli die een jaar aan papierwerk samenpersen in enkele weken.
De gemeenschappelijke draad is dat classificatie het meest waard is waar er automatisch iets volgt. Als het label alleen een mens later helpt zoeken, is het rendement reëel maar veel kleiner. Waar bewaring en verwijdering ervan afhangen, is de case veel sterker, wat onze pagina over compliance en recordsmanagement uitwerkt.
Vijf fouten die steeds weer opduiken
- Kopen op basis van demo-nauwkeurigheid. Het democorpus is gekozen om te werken. Het uwe niet.
- Uitrollen zonder beoordelingslus. Als documenten met lage betrouwbaarheid nergens naartoe kunnen, blokkeert het systeem het werk of gokt het. Beide zijn erger dan een wachtrij.
- Te veel klassen. Veertig klassen met vage grenzen classificeren altijd slechter dan twaalf met duidelijke. Begin grof en splits alleen wanneer een splitsing iets verandert aan wat er daarna gebeurt.
- De taxonomie zonder eigenaar laten. Een classificatieschema is een levend iets. Zonder eigenaar verslechtert de nauwkeurigheid en merkt niemand het totdat iemand iets niet kan vinden.
- Negeren wat het label overneemt. Als bewaring, rechten en routering daarna nog steeds handmatig worden ingesteld, heeft u de gemakkelijke stap geautomatiseerd en alle dure stappen behouden.
Waar Contellect One past
Contellect One past classificatie toe op het moment van vastlegging, met een betrouwbaarheidsscore bij elke beslissing, zodat routering, bewaring, rechten en search allemaal een betrouwbaar label overnemen in plaats van er later opnieuw een af te leiden. Documenten met lage betrouwbaarheid gaan naar een beoordelingswachtrij, en correcties van beoordelaars voeden het model terug.
Als u opties aan het evalueren bent, behandelt de pagina over AI-documentclassificatie hoe het in meer detail werkt, en de gids over intelligente datavastlegging behandelt de vastleggingsfase die het voedt. Als u het liever test dan erover leest, vraag dan om een proof of concept op uw eigen documenten en houd ons aan de acht criteria hierboven.
