Guide d'achat : logiciels de classification
Guide neutre pour choisir un logiciel de classification documentaire : tester la précision sur vos documents, ce qu'il faut évaluer, et le coût réel.
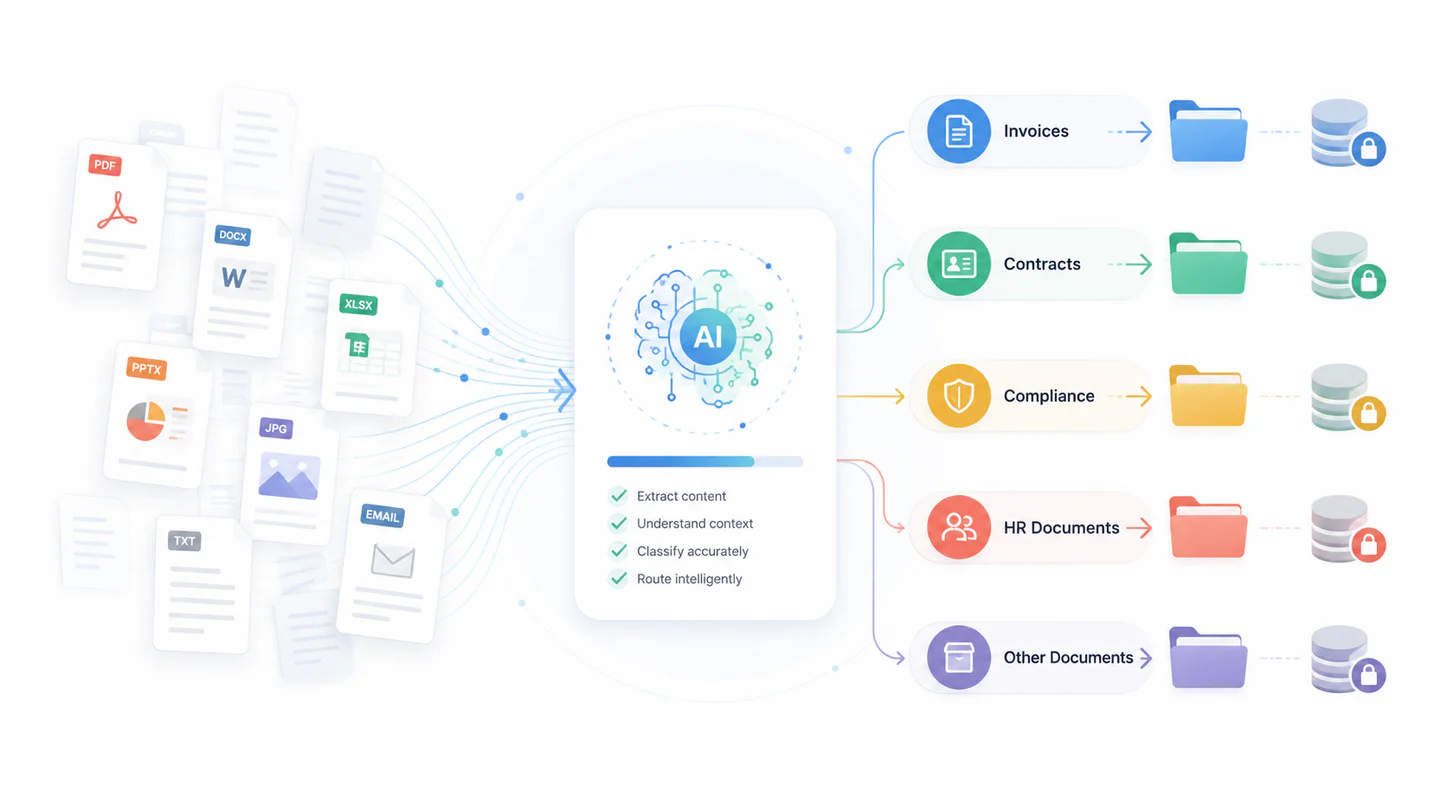
La plupart des démonstrations de logiciels de classification documentaire se ressemblent. Un fournisseur dépose un dossier de factures et de contrats dans un portail, l’écran se remplit de documents soigneusement triés, et un chiffre comme 97 % apparaît. Puis vous l’achetez, vous le pointez vers votre propre archive, et le chiffre s’effondre.
C’est de cet écart que traite ce guide. Pas ce qu’est un logiciel de classification documentaire, mais comment distinguer deux produits lorsque tous deux revendiquent la classification par IA, des intégrations préconstruites et une sécurité d’entreprise, et comment mener une évaluation qui prédit ce que vous obtiendrez réellement en production.
En résumé : arrêtez d’acheter sur la précision. Achetez sur le taux de traitement direct, mesuré sur vos propres documents, avec vos propres réviseurs dans la boucle.
Ce que fait réellement un logiciel de classification documentaire
Un logiciel qui automatise la classification documentaire attribue chaque document entrant à une catégorie métier en fonction de son contenu. Ceci est un bon de commande, cela est un avis de paiement, celui-ci est un accord de confidentialité signé. Cela fonctionne sur des formulaires structurés, des documents semi-structurés comme les factures où les champs sont constants mais pas la mise en page, et du contenu entièrement non structuré comme la correspondance. C’est une étape dans une chaîne que fournisseurs et acheteurs confondent souvent :
- OCR transforme des pixels en caractères. Il n’a aucune idée de ce qu’est le document.
- Classification décide de quel type de document il s’agit.
- Extraction en tire des valeurs nommées une fois le type connu.
L’ordre compte plus qu’il n’y paraît. Les règles d’extraction sont généralement propres à chaque classe, si bien qu’une erreur de classification contamine tout ce qui suit. Étiquetez une facture comme un bon de livraison, et chaque règle d’extraction se déclenche contre le mauvais modèle, la mauvaise chaîne d’approbation démarre, et l’erreur ressurgit des semaines plus tard sous la forme d’un paiement que personne ne peut retracer.
Le résultat utile n’est donc pas l’étiquette seule, mais l’étiquette accompagnée d’un score de confiance. Un classificateur qui a raison la plupart du temps et se tait sur ses échecs est un handicap. Celui qui signale sa propre incertitude peut être digne de confiance pour le reste, car vous pouvez orienter les documents douteux vers une personne et laisser les documents assurés tranquilles.
Trois approches, et quand chacune est la bonne réponse
Presque tous les produits du marché relèvent de l’une de ces trois approches, ou d’un mélange. Les fournisseurs le précisent rarement, alors demandez-le.
| Approche | Comment elle décide | Plus efficace quand | Plus faible quand |
|---|---|---|---|
| Fondée sur des règles | Mots-clés, expressions régulières, codes-barres, zones de mise en page | L’ensemble documentaire est stable et structuré, et chaque décision doit être explicable | Les formats dérivent, ou un fournisseur change un modèle et les règles cessent silencieusement de correspondre |
| Machine learning entraîné | Modèles entraînés à partir de vos exemples étiquetés, parfois à partir d’une base pré-entraînée | Vous disposez de volume et d’historique, et les classes sont visuellement ou linguistiquement distinctes | Vous n’avez pas de données étiquetées, ou une nouvelle classe apparaît avec seulement une poignée d’exemples |
| Grand modèle de langage | Un modèle pré-entraîné lit le document et raisonne à son sujet, souvent sans exemples d’entraînement | Les classes sont décrites en mots plutôt qu’apprises, longue traîne de types rares, langues mixtes | Le coût par document compte à fort volume, ou vous avez besoin que la même entrée donne toujours la même réponse |
Deux remarques pratiques. La classification fondée sur des règles est démodée et reste pourtant le bon choix pour un flux codé-barres, à fort volume et invariant, car elle est bon marché, rapide et auditable. Et un modèle de langage qui classifie bien sans données d’entraînement peut malgré tout être la mauvaise réponse à dix millions de documents par an, purement sur le coût unitaire. Demandez quelle approche traite quelle partie de votre mélange, et méfiez-vous d’une réponse unique pour tout.
Le taux de traitement direct est le chiffre sur lequel acheter
La précision est un chiffre unique qui masque la distribution sous-jacente, c’est-à-dire exactement l’information dont vous avez besoin. L’indicateur qui prédit votre coût opérationnel est le taux de traitement direct : la part de documents qui traversent le système sans qu’une personne n’y touche, à un seuil de confiance que vous êtes prêt à défendre devant un auditeur.
Les deux divergent rapidement. Comparez deux candidats sur dix mille documents par mois, l’un plus précis globalement et l’autre mieux calibré quant à sa propre certitude :
| Précis mais hésitant | Moins précis, bien calibré | |
|---|---|---|
| Précision affichée | 95 % | 90 % |
| Documents validés automatiquement à votre seuil | 6 000 | 8 500 |
| Documents dans la file de revue | 4 000 | 1 500 |
| Minutes de réviseur à 40 secondes chacune | 2 667 | 1 000 |
Le premier candidat gagne la démonstration et vous coûte 1 667 minutes de réviseur supplémentaires chaque mois, soit environ une personne à temps plein. Le second est moins précis et bien moins coûteux à exploiter, car il est confiant quand il a raison et honnête quand il ne l’a pas. C’est la calibration, et non la précision brute, que vous payez.
Demandez ensuite où atterrissent les erreurs. Une matrice de confusion vous le dit ; un pourcentage ne le dira jamais. Classer à tort un bon de livraison comme un autre bon de livraison est du bruit. Classer à tort un contrat signé comme une facture peut placer un engagement hors de votre calendrier de rétention et hors du modèle de permissions censé le protéger. Les erreurs ne sont pas interchangeables, et le coût d’une erreur dépend entièrement des deux classes qui ont été interverties.
Demandez donc à chaque fournisseur trois choses : la matrice de confusion sur votre propre échantillon, le seuil de confiance utilisé pour produire le chiffre de validation automatique, et le taux de traitement direct qui en résulte. Un fournisseur qui ne vous donnera qu’un seul chiffre de précision vous dit quelque chose.
Huit critères pour évaluer chaque candidat
Les listes de fonctionnalités produit convergent rapidement. Ce qui distingue les candidats, c’est le comportement de chaque capacité sur vos documents, à vos volumes, sous le regard de vos auditeurs. Évaluez chaque candidat sur ces huit critères, et insistez pour les tester sur votre propre échantillon plutôt que sur le corpus de démonstration du fournisseur.
| Critère | Comment le tester | À quoi ressemble une bonne réponse |
|---|---|---|
| Précision de classification | Testez plusieurs centaines de vos propres documents, y compris des numérisations médiocres et des fichiers à langues mixtes | La précision sur votre corpus reste proche du chiffre de démonstration |
| Délai avant un premier modèle utile | Comptez les jours calendaires entre la remise des données et un classificateur opérationnel | Des semaines plutôt que des trimestres, sans engagement de services à durée indéterminée |
| Profondeur d’intégration | Réécrivez les résultats dans votre ECM, ERP ou système de dossiers, pas seulement une lecture depuis un dossier surveillé | Synchronisation bidirectionnelle avec un mappage au niveau des champs et une gestion d’erreurs définie |
| Boucle de revue humaine | Orientez les documents à faible confiance vers un réviseur et suivez le chemin de correction | Les corrections alimentent le réentraînement, et la file est visible pour les opérations |
| Preuve d’audit | Demandez qui a classifié chaque document, quand, et sur quelle version de modèle | Une piste par document que vous pouvez exporter pour un auditeur |
| Résidence des données | Confirmez où les documents sont traités et s’ils entraînent des modèles partagés | Traitement dans votre région, dans votre tenant, sans entraînement sur votre contenu par défaut |
| Comportement sous charge de pointe | Testez le pic de fin de mois ou de fin d’année, pas la journée moyenne | Le débit se dégrade de façon prévisible face à un plafond documenté |
| Coût en année trois | Modélisez la croissance du volume, le retraitement et le temps de réviseur, pas seulement les frais de licence | Le coût par document baisse à mesure que le volume augmente |
Mener une preuve de concept qui vous apprend quelque chose
La plupart des preuves de concept sont du théâtre. Elles utilisent un échantillon sélectionné, sont notées par le fournisseur, et réussissent. Une preuve de concept utile est conçue pour pouvoir échouer.
- Tirez l’échantillon au hasard. Plusieurs centaines de documents au minimum, extraits d’une plage de dates réelle, et non choisis par la personne la plus enthousiaste au sujet du projet.
- Incluez les cas laids. Photographies prises au téléphone, télécopies, documents numérisés à l’envers, PDF multi-documents devant être scindés avant toute autre chose, formulaires remplis à la main, et tout mélange de langues que vous recevez réellement. Les exclure, c’est ainsi qu’une preuve de concept produit un chiffre inutilisable.
- Conservez un jeu de test que le fournisseur ne voit jamais. Si la même équipe règle et note, vous mesurez son réglage, pas le produit.
- Consignez les critères de réussite et d’échec avant de commencer. Fixez le taux de traitement direct, le taux maximal acceptable pour les confusions spécifiques qui vous nuiraient, et les minutes de réviseur que vous pouvez vous permettre. Convenir de cela après coup, c’est ainsi qu’un résultat marginal se transforme en achat.
- Mesurez les minutes de réviseur, pas seulement la précision. Chronométrez le temps que prend réellement une correction dans l’interface que les gens utiliseront chaque jour.
- Simulez le pic. Faites passer un volume de fin de mois et observez ce qu’il advient de la latence et de la file d’attente.
Demandez ce qui se passe lorsqu’apparaît un type de document qui n’a jamais figuré dans le jeu d’entraînement, et observez si le système dit qu’il ne sait pas ou choisit discrètement la classe la plus proche. Le second comportement est bien plus coûteux, et vous ne le verrez que si vous le testez.
Déploiement : cloud, sur site ou hybride
Les avantages et inconvénients génériques ne sont pas d’un grand secours ici. Quatre questions tranchent la décision en pratique.
Où le contenu est-il autorisé à être traité, et entraîne-t-il quoi que ce soit ? C’est généralement la contrainte contraignante dans les secteurs réglementés, et celle à régler en premier. Obtenez par écrit que vos documents ne servent pas à entraîner des modèles partagés, si c’est ce dont vous avez besoin.
À quoi ressemble le pic ? La capacité élastique est l’argument le plus clair en faveur du cloud, et elle ne compte que si votre volume est réellement en dents de scie.
Dans quoi doit-il écrire, et à quelle distance cela se trouve-t-il ? Si le système de référence est sur site, une classification hébergée ailleurs ajoute un aller-retour à chaque document et un nouveau point de défaillance entre les deux.
Qui l’entretient ? Le sur site signifie que votre équipe possède les mises à niveau, les mises à jour de modèle et la posture de sécurité. C’est un coût de personnel réel, et c’est la ligne la plus souvent omise dans la comparaison.
L’hybride justifie sa complexité lorsqu’une classe de contenu ne peut réellement pas sortir, et que le reste bénéficie réellement de l’élasticité. Si ni l’un ni l’autre n’est vrai, l’hybride représente deux systèmes à maintenir au lieu d’un seul. Notre guide sur l’ECM cloud explore le même arbitrage pour la plateforme de contenu plus large.
L’intégration se joue sur la réécriture, pas sur la lecture
Chaque fournisseur s’intègre. Chez presque tous, cela signifie qu’ils peuvent surveiller un dossier ou une boîte de réception, ce qui constitue la moitié facile et est presque inutile en soi. La classification ne crée de la valeur qu’une fois que l’étiquette, le score de confiance et la piste d’audit atterrissent dans le système où le travail se déroule réellement.
Insistez sur quatre points :
- Mappage au niveau des champs. Quel champ cible reçoit la classe, et quel champ reçoit le score de confiance ? Si la confiance est perdue en chemin, vous avez perdu la capacité de trier.
- Gestion des erreurs. Que se passe-t-il lorsque le système cible rejette l’écriture ? Une politique de nouvelle tentative, une file de lettres mortes et une alerte, ou une perte silencieuse.
- Idempotence. Si le même document est traité deux fois, obtenez-vous un enregistrement ou deux ? Le retraitement est normal, donc cela se pose dès le deuxième mois, pas la deuxième année.
- Reclassification. Lorsqu’un réviseur corrige une étiquette, la correction se propage-t-elle au système de référence, ou seulement au jeu d’entraînement ? Un système qui s’améliore continuellement grâce aux corrections vaut peu si ces corrections n’atteignent jamais l’endroit où l’entreprise lit réellement.
Le schéma à viser est que la classification soit une étape au sein d’un flux plus large de traitement intelligent des documents plutôt qu’un outil autonome, de sorte que la rétention, les permissions et l’orientation héritent tous de l’étiquette au lieu d’être redéfinis à la main. C’est cet héritage qui produit l’essentiel du retour, et il est approfondi dans notre aperçu de la gestion des documents et des contenus.
Ce que cela coûte, et où se situe réellement le coût
Les frais de licence sont la ligne que tout le monde compare, et rarement la plus importante. Sur trois ans, la répartition réelle ressemble généralement à ceci :
- Temps de réviseur. Directement déterminé par le taux de traitement direct. C’est pourquoi la conversation sur la précision ci-dessus est une conversation sur les coûts.
- Construction de l’intégration. Écrire les résultats dans un système de référence, avec mappage et gestion d’erreurs, est un projet. Budgétez-le une fois et attendez-vous à le revoir lors des mises à niveau du système cible.
- Maintenance de la taxonomie. Les classes dérivent. Quelqu’un doit en être responsable, et si personne ne l’est, la précision se dégrade silencieusement.
- Retraitement. Les mises à jour de modèle et les taxonomies corrigées impliquent de rejouer le volume historique. Demandez si le retraitement est facturé à l’usage.
- Licence et infrastructure. Par document, par page, par utilisateur ou par cœur, et la structure compte autant que le taux.
Le signal sain est que le coût par document baisse à mesure que le volume augmente. Si un devis évolue de façon linéaire indéfiniment, vous financez la marge de quelqu’un d’autre sur votre croissance. Modélisez l’année trois, pas l’année un, et demandez ce qu’il advient du prix lorsque le volume double.
Où la classification est le plus rentable en premier
La valeur apparaît partout où une étiquette débloque une décision en aval plutôt que de simplement ranger un dossier.
Dans la santé, la classification sépare le contenu clinique du contenu administratif dès la capture, de sorte que les registres relèvent de la bonne règle de rétention et de la bonne politique d’accès sans qu’une personne n’ait à choisir. Dans le juridique et les contrats, elle distingue un accord signé d’un brouillon, ce qui fait la différence entre un engagement contraignant et un dossier de travail. Dans les services financiers, le moteur est généralement la preuve : montrer à un examinateur quels documents ont soutenu une décision, et quand. Dans l’éducation, c’est le volume, avec des cycles d’admission qui concentrent une année de paperasse en quelques semaines.
Le fil conducteur est que la classification vaut le plus là où quelque chose d’automatique se produit ensuite. Si l’étiquette n’aide qu’un humain à chercher plus tard, le retour est réel mais bien plus modeste. Là où la rétention et la disposition en dépendent, l’argument est bien plus fort, ce qu’approfondit notre page conformité et gestion des archives.
Cinq erreurs qui reviennent sans cesse
- Acheter sur la précision de la démonstration. Le corpus de démonstration a été choisi pour fonctionner. Pas le vôtre.
- Déployer sans boucle de revue. Si les documents à faible confiance n’ont nulle part où aller, le système bloque le travail ou devine. Les deux sont pires qu’une file d’attente.
- Trop de classes. Quarante classes aux frontières floues classifieront toujours moins bien que douze aux frontières claires. Commencez large et ne scindez que lorsqu’une scission change ce qui se passe ensuite.
- Laisser la taxonomie sans responsable. Un schéma de classification est un organisme vivant. Sans responsable, la précision se dégrade et personne ne le remarque jusqu’à ce que quelqu’un ne trouve plus quelque chose.
- Ignorer ce qui hérite de l’étiquette. Si la rétention, les permissions et l’orientation sont encore définies à la main par la suite, vous avez automatisé l’étape facile et conservé toutes les étapes coûteuses.
Où se situe Contellect One
Contellect One applique la classification au moment de la capture, avec un score de confiance sur chaque décision, de sorte que l’orientation, la rétention, les permissions et la recherche héritent tous d’une étiquette fiable plutôt que d’en redériver une plus tard. Les documents à faible confiance vont dans une file de revue, et les corrections des réviseurs alimentent le modèle en retour.
Si vous évaluez des options, la page classification de documents par IA explique son fonctionnement plus en détail, et le guide sur la capture intelligente de données couvre l’étape de capture qui l’alimente. Si vous préférez le tester plutôt que d’en lire, demandez une preuve de concept sur vos propres documents et tenez-nous aux huit critères ci-dessus.
