Leitfaden zur Dokumentenklassifizierung
Herstellerneutraler Leitfaden zur Dokumentenklassifizierung: Genauigkeit an eigenen Dokumenten testen, Bewertungskriterien und echte Kosten.
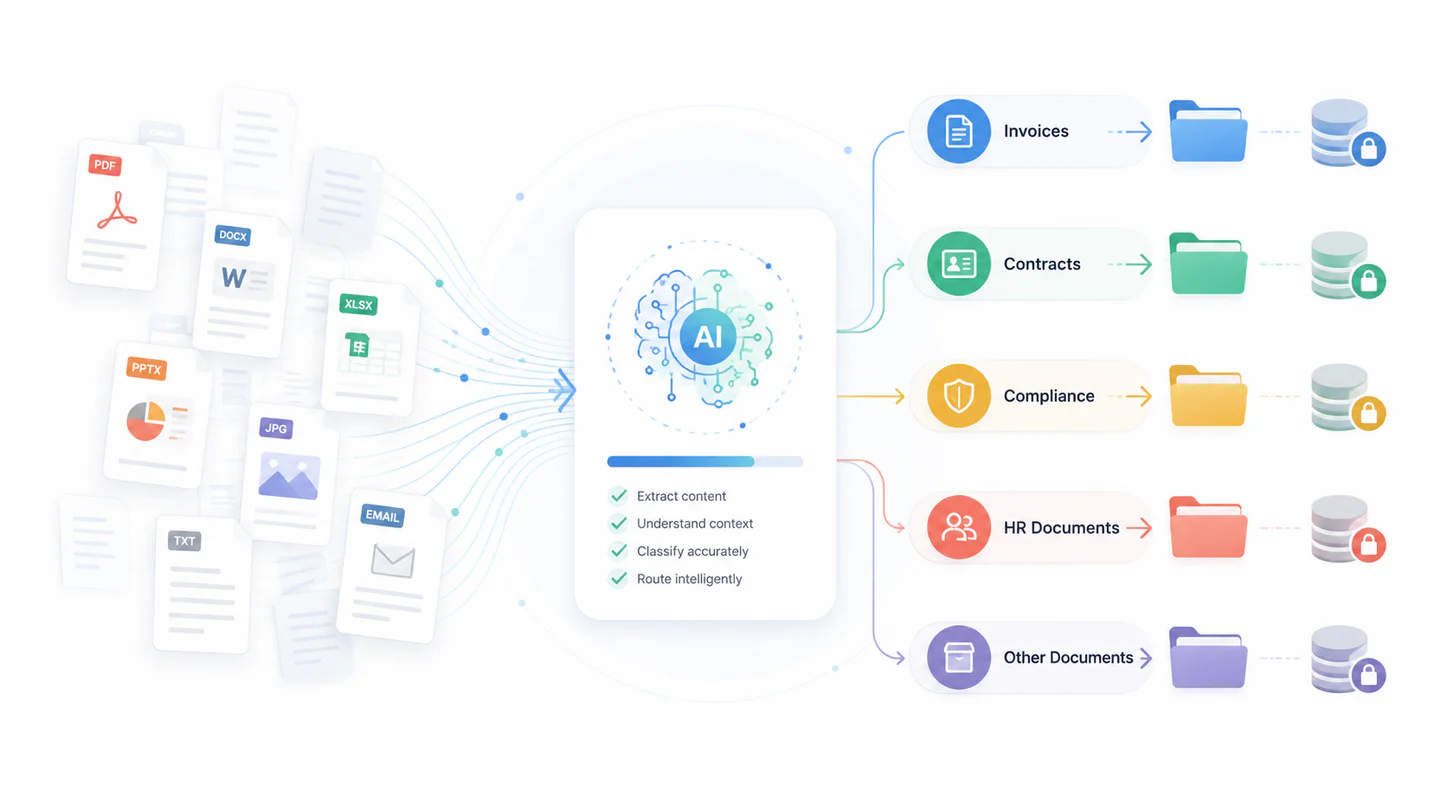
Die meisten Demos von Software zur Dokumentenklassifizierung sehen gleich aus. Ein Anbieter lädt einen Ordner mit Rechnungen und Verträgen in ein Portal, der Bildschirm füllt sich mit sauber sortierten Dokumenten, und eine Zahl wie 97 Prozent erscheint. Dann kaufen Sie die Software, richten sie auf Ihr eigenes Archiv, und die Zahl bricht zusammen.
Um genau diese Lücke geht es in diesem Leitfaden. Nicht darum, was Software zur Dokumentenklassifizierung ist, sondern wie Sie zwei Produkte unterscheiden, wenn beide KI-Klassifizierung, vorgefertigte Integrationen und Unternehmenssicherheit versprechen, und wie Sie eine Bewertung durchführen, die vorhersagt, was Sie im Produktivbetrieb tatsächlich bekommen.
Die Kurzfassung: Kaufen Sie nicht nach Genauigkeit. Kaufen Sie nach der Quote durchgängiger Verarbeitung, gemessen an Ihren eigenen Dokumenten, mit Ihren eigenen Prüfern im Loop.
Was Software zur Dokumentenklassifizierung tatsächlich leistet
Software, die Dokumentenklassifizierung automatisiert, ordnet jedes eingehende Dokument anhand seines Inhalts einer Geschäftskategorie zu. Das hier ist eine Bestellung, das dort ein Zahlungsavis, dieses eine unterschriebene Vertraulichkeitsvereinbarung. Sie funktioniert bei strukturierten Formularen, halbstrukturierten Dokumenten wie Rechnungen, bei denen die Felder konsistent, das Layout aber nicht einheitlich ist, und bei vollständig unstrukturierten Inhalten wie Korrespondenz. Es handelt sich um einen Schritt in einer Kette, die Anbieter und Käufer oft miteinander vermischen:
- OCR wandelt Pixel in Zeichen um. Es weiß nicht, um welches Dokument es sich handelt.
- Dokumentenklassifizierung entscheidet, um welche Art von Dokument es sich handelt.
- Dokumentendatenextraktion entnimmt ihm benannte Werte, sobald die Art bekannt ist.
Die Reihenfolge ist wichtiger, als es aussieht. Extraktionsregeln sind meist klassenspezifisch, sodass eine Fehlklassifizierung alles Nachgelagerte vergiftet. Wird eine Rechnung als Lieferschein gekennzeichnet, greift jede Extraktionsregel auf die falsche Vorlage, die falsche Genehmigungskette startet, und der Fehler zeigt sich Wochen später als Zahlung, die niemand nachverfolgen kann.
Der nützliche Output ist daher nicht das Label allein, sondern das Label plus ein Konfidenzwert. Ein Klassifikator, der meistens richtigliegt und über seine Fehler schweigt, ist ein Risiko. Einer, der seine eigene Unsicherheit meldet, verdient beim Rest Vertrauen, weil Sie zweifelhafte Dokumente an eine Person weiterleiten und die sicheren unangetastet lassen können.
Drei Ansätze, und wann jeder davon die richtige Antwort ist
Fast jedes Produkt am Markt ist eines dieser drei oder eine Mischung. Anbieter sagen selten, welches, also fragen Sie nach.
| Ansatz | Wie er entscheidet | Am stärksten, wenn | Am schwächsten, wenn |
|---|---|---|---|
| Regelbasiert | Schlüsselwörter, reguläre Ausdrücke, Barcodes, Layout-Zonen | Der Dokumentenbestand stabil und strukturiert ist und jede Entscheidung erklärbar sein muss | Formate driften oder ein Lieferant eine Vorlage ändert und die Regeln still aufhören zu greifen |
| Trainiertes maschinelles Lernen | Trainierte Modelle, gelernt aus Ihren gekennzeichneten Beispielen, manchmal ausgehend von einer vortrainierten Basis | Sie Volumen und Historie haben und sich Klassen visuell oder sprachlich unterscheiden | Sie keine gekennzeichneten Daten haben oder eine neue Klasse mit nur wenigen Beispielen auftaucht |
| Großes Sprachmodell | Ein vortrainiertes Modell liest das Dokument und schlussfolgert daraus, oft ohne Trainingsbeispiele | Klassen in Worten beschrieben statt gelernt werden, bei einem langen Schwanz seltener Typen, gemischten Sprachen | Die Kosten pro Dokument bei hohem Volumen entscheidend sind oder dieselbe Eingabe immer dieselbe Antwort liefern muss |
Zwei praktische Hinweise. Regelbasierte Klassifizierung ist unmodern und trotzdem die richtige Wahl für einen barcodebasierten, volumenstarken, unveränderlichen Strom, weil sie günstig, schnell und auditierbar ist. Und ein Sprachmodell, das ohne Trainingsdaten gut klassifiziert, kann bei zehn Millionen Dokumenten im Jahr allein wegen der Stückkosten die falsche Antwort sein. Fragen Sie, welcher Ansatz welchen Teil Ihres Dokumentenmixes bedient, und seien Sie misstrauisch bei einer einzigen Antwort für alles.
Die Quote durchgängiger Verarbeitung ist die Zahl, nach der Sie kaufen sollten
Genauigkeit ist eine einzelne Zahl, die die Verteilung darunter verbirgt - genau die Information, die Sie brauchen. Die Kennzahl, die Ihre Betriebskosten vorhersagt, ist die Quote durchgängiger Verarbeitung: der Anteil der Dokumente, die das System ohne menschliches Zutun durchlaufen, bei einem Konfidenzschwellenwert, den Sie einem Prüfer gegenüber verteidigen können.
Die beiden Größen driften schnell auseinander. Vergleichen Sie zwei Kandidaten bei zehntausend Dokumenten im Monat, einer insgesamt genauer, der andere besser kalibriert bezüglich seiner eigenen Sicherheit:
| Genau, aber zögerlich | Weniger genau, gut kalibriert | |
|---|---|---|
| Angegebene Genauigkeit | 95 Prozent | 90 Prozent |
| Automatisch freigegebene Dokumente bei Ihrem Schwellenwert | 6.000 | 8.500 |
| Dokumente in der Prüfwarteschlange | 4.000 | 1.500 |
| Prüferminuten bei je 40 Sekunden | 2.667 | 1.000 |
Der erste Kandidat gewinnt die Demo und kostet Sie monatlich 1.667 zusätzliche Prüferminuten - etwa eine Vollzeitstelle. Der zweite ist weniger genau und deutlich günstiger im Betrieb, weil er sicher ist, wenn er richtigliegt, und ehrlich, wenn nicht. Kalibrierung, nicht rohe Genauigkeit, ist das, wofür Sie tatsächlich bezahlen.
Fragen Sie dann, wo die Fehler landen. Eine Konfusionsmatrix sagt Ihnen das; ein Prozentsatz nie. Einen Lieferschein als einen anderen Lieferschein fehlzuklassifizieren ist Rauschen. Einen unterschriebenen Vertrag als Rechnung fehlzuklassifizieren kann eine Verpflichtung außerhalb Ihres Aufbewahrungsplans und außerhalb des Berechtigungsmodells platzieren, das sie eigentlich schützen sollte. Fehler sind nicht austauschbar, und die Kosten eines Fehlers hängen vollständig davon ab, welche zwei Klassen vertauscht wurden.
Verlangen Sie daher von jedem Anbieter drei Dinge: die Konfusionsmatrix an Ihrer eigenen Stichprobe, den Konfidenzschwellenwert, der zur automatischen Freigabezahl führt, und die daraus resultierende Quote durchgängiger Verarbeitung. Ein Anbieter, der Ihnen nur eine einzige Genauigkeitszahl gibt, sagt Ihnen damit etwas.
Acht Kriterien zur Bewertung jedes Kandidaten
Produkt-Funktionslisten gleichen sich schnell an. Was Kandidaten unterscheidet, ist, wie sich jede Fähigkeit an Ihren Dokumenten, bei Ihren Volumina, unter Ihren Prüfern verhält. Bewerten Sie jeden Kandidaten anhand dieser acht Kriterien, und bestehen Sie darauf, sie an Ihrer eigenen Stichprobe zu testen statt am Demo-Korpus des Anbieters.
| Kriterium | Wie Sie es testen | Wie eine gute Antwort aussieht |
|---|---|---|
| Klassifizierungsgenauigkeit | Testen Sie mehrere Hundert eigene Dokumente, einschließlich schlechter Scans und mehrsprachiger Dateien | Die Genauigkeit an Ihrem Korpus bleibt nahe an der Demo-Zahl |
| Zeit bis zum ersten nutzbaren Modell | Zählen Sie Kalendertage von der Datenübergabe bis zu einem funktionierenden Klassifikator | Wochen statt Quartale, ohne unbefristetes Dienstleistungsengagement |
| Integrationstiefe | Schreiben Sie Ergebnisse zurück in Ihr ECM, ERP oder Fallsystem, nicht nur Lesen aus einem überwachten Ordner | Bidirektionale Synchronisierung mit Feldzuordnung und definierter Fehlerbehandlung |
| Human-Review-Loop | Leiten Sie Dokumente mit geringer Konfidenz an einen Prüfer weiter und verfolgen Sie den Korrekturpfad | Korrekturen fließen ins erneute Training ein, und die Warteschlange ist für den Betrieb sichtbar |
| Audit-Nachweis | Fragen Sie, wer jedes Dokument klassifiziert hat, wann, und mit welcher Modellversion | Ein Nachweispfad pro Dokument, den Sie für einen Prüfer exportieren können |
| Datenresidenz | Bestätigen Sie, wo Dokumente verarbeitet werden und ob sie gemeinsame Modelle trainieren | Verarbeitung in Ihrer Region, in Ihrem Mandanten, standardmäßig ohne Training an Ihren Inhalten |
| Verhalten bei Spitzenlast | Testen Sie den Monats- oder Jahresendansturm, nicht den Durchschnittstag | Der Durchsatz sinkt vorhersehbar gegen eine dokumentierte Obergrenze |
| Kosten im dritten Jahr | Modellieren Sie Volumenwachstum, Nachbearbeitung und Prüferzeit, nicht nur Lizenzgebühren | Die Kosten pro Dokument sinken mit steigendem Volumen |
Einen aussagekräftigen Proof of Concept durchführen
Die meisten Proofs of Concept sind Theater. Sie nutzen eine kuratierte Stichprobe, werden vom Anbieter bewertet, und sie bestehen. Ein nützlicher ist so aufgesetzt, dass er auch scheitern kann.
- Ziehen Sie die Stichprobe zufällig. Mindestens mehrere Hundert Dokumente, aus einem echten Datumsbereich gezogen, nicht ausgewählt von der Person, die am begeistertsten vom Projekt ist.
- Nehmen Sie die hässlichen Fälle mit auf. Handyfotos, Faxe, kopfüber gescannte Dokumente, Multi-Dokument-PDFs, die zuerst aufgeteilt werden müssen, handschriftlich ausgefüllte Formulare und jede Sprachmischung, die Sie tatsächlich erhalten. Diese auszuschließen ist der Grund, warum ein Proof of Concept eine unbrauchbare Zahl liefert.
- Halten Sie ein Testset zurück, das der Anbieter nie sieht. Wenn dasselbe Team abstimmt und bewertet, messen Sie dessen Feinabstimmung, nicht das Produkt.
- Legen Sie Bestehen und Scheitern vor Beginn schriftlich fest. Benennen Sie die Quote durchgängiger Verarbeitung, die maximal akzeptable Rate für die spezifischen Verwechslungen, die Ihnen schaden würden, und die Prüferminuten, die Sie sich leisten können. Dies erst hinterher zu vereinbaren ist der Weg, wie ein mittelmäßiges Ergebnis zu einem Kauf wird.
- Messen Sie Prüferminuten, nicht nur Genauigkeit. Stoppen Sie, wie lange eine Korrektur tatsächlich in der Oberfläche dauert, die Menschen täglich nutzen werden.
- Simulieren Sie den Ansturm. Schleusen Sie ein Monatsend-Volumen durch und beobachten Sie, was mit Latenz und Warteschlange geschieht.
Fragen Sie, was passiert, wenn ein Dokumenttyp auftaucht, der nie im Trainingsset war, und beobachten Sie, ob das System sagt, dass es es nicht weiß, oder still die nächstliegende Klasse wählt. Das zweite Verhalten ist weitaus teurer, und Sie sehen es nur, wenn Sie explizit danach testen.
Bereitstellung: Cloud, On-Premises oder hybrid
Allgemeine Vor- und Nachteile helfen hier wenig. Vier Fragen entscheiden es in der Praxis.
Wo darf Content verarbeitet werden, und trainiert das irgendetwas? Das ist meist die bindende Einschränkung in regulierten Branchen und die, die Sie zuerst klären sollten. Lassen Sie sich schriftlich bestätigen, dass Ihre Dokumente nicht zum Training gemeinsamer Modelle genutzt werden, falls Sie das brauchen.
Wie sieht die Spitzenlast aus? Elastische Kapazität ist das klarste Argument für die Cloud, und es zählt nur, wenn Ihr Volumen tatsächlich stark schwankt.
Wohin muss geschrieben werden, und wie weit entfernt ist das? Liegt das System of Record On-Premises, fügt eine anderswo sitzende Klassifizierung jedem Dokument einen zusätzlichen Umweg und einen neuen Fehlerpunkt dazwischen hinzu.
Wer patcht es? On-Premises bedeutet, dass Ihr Team für Upgrades, Modell-Updates und die Sicherheitslage verantwortlich ist. Das ist ein echter Personalkostenposten, und es ist die Zeile, die im Vergleich am häufigsten fehlt.
Hybrid rechtfertigt seine Komplexität, wenn eine Content-Klasse das Haus wirklich nicht verlassen darf und der Rest wirklich von Elastizität profitiert. Trifft keines von beidem zu, ist Hybrid zwei zu wartende Systeme statt eines. Unser Leitfaden zu Cloud-ECM für Unternehmen behandelt denselben Kompromiss für die breitere Content-Plattform.
Bei Integration geht es um Zurückschreiben, nicht ums Lesen
Jeder Anbieter integriert. Fast alle meinen damit, dass sie einen Ordner oder ein Postfach überwachen können - das ist die einfache Hälfte und für sich genommen fast nutzlos. Die Klassifizierung schafft erst dann Wert, wenn das Label, der Konfidenzwert und der Audit-Trail im System landen, in dem die eigentliche Arbeit stattfindet.
Fragen Sie hartnäckig nach vier Dingen:
- Feldzuordnung. Welches Zielfeld erhält die Klasse, und welches den Konfidenzwert? Geht die Konfidenz unterwegs verloren, verlieren Sie die Fähigkeit zur Priorisierung.
- Fehlerbehandlung. Was passiert, wenn das Zielsystem den Schreibvorgang ablehnt? Eine Wiederholungsrichtlinie, eine Dead-Letter-Warteschlange und ein Alert, oder ein stiller Verlust.
- Idempotenz. Wird dasselbe Dokument zweimal verarbeitet, erhalten Sie einen Datensatz oder zwei? Erneute Verarbeitung ist normal, daher taucht das schon im zweiten Monat auf, nicht erst im zweiten Jahr.
- Neuklassifizierung. Korrigiert ein Prüfer ein Label, gelangt die Korrektur ins System of Record oder nur ins Trainingsset? Ein System, das sich durch Korrekturen kontinuierlich verbessert, nützt wenig, wenn diese Korrekturen nie dort ankommen, wo das Geschäft tatsächlich liest.
Das anzustrebende Muster ist, dass Klassifizierung ein Schritt innerhalb eines breiteren Flows der intelligenten Dokumentenverarbeitung (IDP) ist statt ein eigenständiges Tool, sodass Aufbewahrung, Berechtigungen und Weiterleitung das Label erben, statt erneut von Hand gesetzt zu werden. Aus dieser Vererbung stammt der Großteil des tatsächlichen Nutzens, und das wird in unserer Übersicht zu Dokumenten- und Content-Management weiter behandelt.
Was es kostet, und wo die Kosten tatsächlich liegen
Lizenzgebühren sind die Zeile, die jeder vergleicht, und selten die größte. Über drei Jahre sieht die tatsächliche Verteilung meist so aus:
- Prüferzeit. Direkt von der Quote durchgängiger Verarbeitung bestimmt. Deshalb ist das Gespräch über Genauigkeit oben eigentlich ein Gespräch über Kosten.
- Integrationsaufbau. Ergebnisse mit Zuordnung und Fehlerbehandlung in ein System of Record zu schreiben, ist ein Projekt. Budgetieren Sie es einmal, und rechnen Sie damit, es erneut anzugehen, wenn das Zielsystem aktualisiert wird.
- Taxonomiepflege. Klassen driften. Jemand muss dafür zuständig sein, und tut das niemand, verfällt die Genauigkeit still.
- Nachbearbeitung. Modell-Updates und korrigierte Taxonomien bedeuten, historisches Volumen erneut durchlaufen zu lassen. Fragen Sie, ob Nachbearbeitung gesondert abgerechnet wird.
- Lizenz und Infrastruktur. Pro Dokument, pro Seite, pro Nutzer oder pro Core - die Struktur zählt ebenso sehr wie der Satz.
Das gesunde Signal ist, dass die Kosten pro Dokument mit steigendem Volumen sinken. Skaliert ein Angebot dauerhaft linear, finanzieren Sie die Marge eines anderen mit Ihrem Wachstum. Modellieren Sie das dritte Jahr, nicht das erste, und fragen Sie, was mit dem Preis passiert, wenn sich das Volumen verdoppelt.
Wo sich Klassifizierung zuerst auszahlt
Der Wert zeigt sich überall dort, wo ein Label eine nachgelagerte Entscheidung ermöglicht, statt lediglich einen Ordner aufzuräumen.
Im Gesundheitswesen trennt Klassifizierung klinische von administrativen Inhalten bereits bei der Erfassung, sodass Unterlagen ohne menschliche Auswahl unter die richtige Aufbewahrungsregel und die richtige Zugriffsrichtlinie fallen. Im Rechts- und Vertragswesen unterscheidet sie eine unterzeichnete Vereinbarung von einem Entwurf - der Unterschied zwischen einer bindenden Verpflichtung und einer Arbeitsdatei. Im Finanzdienstleistungssektor ist der Treiber meist der Nachweis: einem Prüfer zeigen, welche Dokumente eine Entscheidung gestützt haben, und wann. Im Bildungswesen ist es das Volumen, mit Zulassungszyklen, die ein Jahr an Papierkram in wenigen Wochen bündeln.
Der gemeinsame Nenner ist, dass Klassifizierung dort am meisten wert ist, wo als Nächstes etwas Automatisches geschieht. Hilft das Label später nur bei der menschlichen Suche, ist der Nutzen real, aber viel kleiner. Hängen Aufbewahrung und Aussonderung davon ab, ist der Fall weitaus stärker, worauf unsere Seite zu Compliance und Records Management näher eingeht.
Fünf Fehler, die immer wieder auftauchen
- Nach Demo-Genauigkeit kaufen. Der Demo-Korpus wurde so gewählt, dass er funktioniert. Ihrer nicht.
- Ohne Prüfschleife live gehen. Haben Dokumente mit geringer Konfidenz keinen Weg, blockiert das System entweder die Arbeit oder rät. Beides ist schlechter als eine Warteschlange.
- Zu viele Klassen. Vierzig Klassen mit unscharfen Grenzen klassifizieren immer schlechter als zwölf mit klaren. Beginnen Sie grob und teilen Sie nur, wenn eine Teilung etwas am weiteren Vorgehen ändert.
- Die Taxonomie ohne Verantwortlichen lassen. Ein Klassifizierungsschema ist ein lebendiges Konstrukt. Ohne Verantwortlichen verfällt die Genauigkeit, und niemand bemerkt es, bis jemand etwas nicht finden kann.
- Ignorieren, was das Label erbt. Werden Aufbewahrung, Berechtigungen und Weiterleitung anschließend noch von Hand gesetzt, haben Sie den einfachen Schritt automatisiert und alle teuren behalten.
Wo Contellect One passt
Contellect One wendet Klassifizierung im Moment der Erfassung an, mit einem Konfidenzwert bei jeder Entscheidung, sodass Weiterleitung, Aufbewahrung, Berechtigungen und Suche allesamt ein verlässliches Label erben, statt später eines neu abzuleiten. Dokumente mit geringer Konfidenz gehen in eine Prüfwarteschlange, und Prüferkorrekturen fließen zurück ins Modell.
Wenn Sie Optionen bewerten, behandelt die Seite Dokumentenklassifizierung mit KI, wie das im Detail funktioniert, und der Leitfaden zur Intelligenten Datenerfassung behandelt die vorgelagerte Erfassungsstufe. Wenn Sie es lieber testen als darüber lesen, bitten Sie um einen Proof of Concept an Ihren eigenen Dokumenten und halten Sie uns an den acht Kriterien oben fest.
