Software de Clasificación Documental: Guía
Guía neutral sobre cómo elegir software de clasificación documental: cómo probar la precisión con sus documentos, qué puntuar y el coste real.
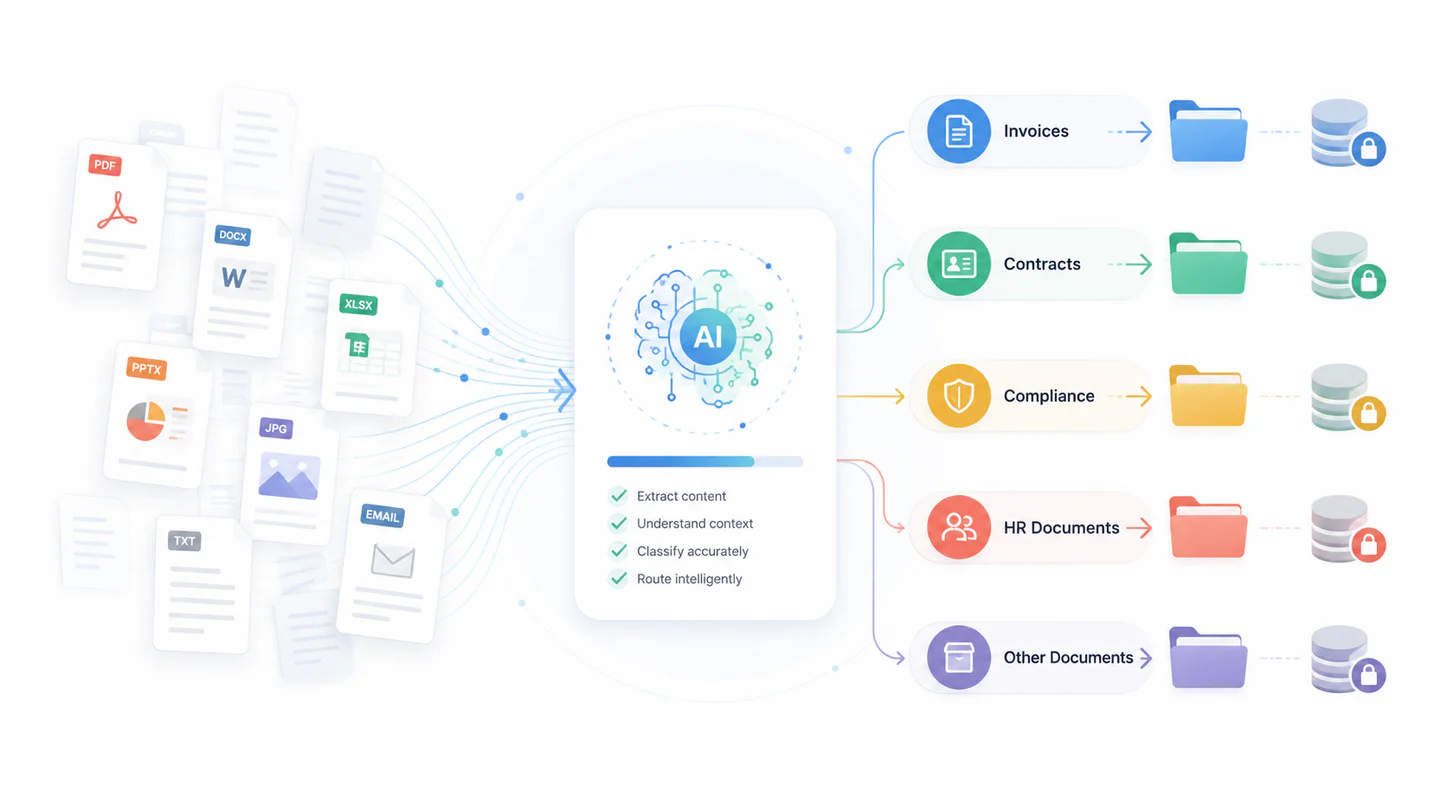
La mayoría de las demostraciones de software de clasificación documental se parecen. Un proveedor deja caer una carpeta de facturas y contratos en un portal, la pantalla se llena de documentos ordenados con precisión, y aparece una cifra como el 97 por ciento. Después lo compra, lo aplica a su propio archivo, y la cifra se desmorona.
Esa brecha es el tema de esta guía. No qué es el software de clasificación documental, sino cómo distinguir dos productos cuando ambos afirman ofrecer clasificación con IA, integraciones predefinidas y seguridad empresarial, y cómo ejecutar una evaluación que prediga lo que realmente obtendrá en producción.
La versión corta: deje de comprar por precisión. Compre por la tasa de procesamiento directo, medida con sus propios documentos, con sus propios revisores en el circuito.
Lo que realmente hace el software de clasificación documental
El software que automatiza la clasificación documental asigna cada documento entrante a una categoría de negocio según lo que contiene. Esto es una orden de compra, aquello es un aviso de remesa, esto otro es un acuerdo de confidencialidad firmado. Funciona con formularios estructurados, documentos semiestructurados como las facturas, donde los campos son coherentes pero la maquetación no lo es, y contenido totalmente no estructurado como la correspondencia. Es un paso dentro de una cadena que proveedores y compradores suelen difuminar entre sí:
- El OCR convierte píxeles en caracteres. No tiene ni idea de qué es el documento.
- La clasificación decide de qué tipo de documento se trata.
- La extracción obtiene valores concretos de él una vez que se conoce el tipo.
El orden importa más de lo que parece. Las reglas de extracción suelen ser específicas de cada clase, así que una clasificación errónea envenena todo lo que viene después. Etiquetar una factura como albarán de entrega hace que se disparen todas las reglas de extracción contra la plantilla equivocada, se inicia la cadena de aprobación equivocada, y el error aflora semanas después como un pago que nadie puede rastrear.
El resultado útil, por tanto, no es la etiqueta por sí sola, sino la etiqueta más una puntuación de confianza. Un clasificador que acierta la mayor parte del tiempo y guarda silencio sobre sus fallos es un pasivo. Uno que informa de su propia incertidumbre puede merecer confianza en el resto, porque puede enrutar los documentos dudosos a una persona y dejar tranquilos los que tienen confianza.
Tres enfoques, y cuándo cada uno es la respuesta correcta
Casi todos los productos del mercado son uno de estos tres, o una combinación. Los proveedores rara vez dicen cuál, así que pregunte.
| Enfoque | Cómo decide | Más fuerte cuando | Más débil cuando |
|---|---|---|---|
| Basado en reglas | Palabras clave, expresiones regulares, códigos de barras, zonas de maquetación | El conjunto de documentos es estable y estructurado, y necesita que cada decisión sea explicable | Los formatos cambian, o un proveedor modifica una plantilla y las reglas dejan de coincidir en silencio |
| Aprendizaje automático entrenado | Modelos entrenados con sus ejemplos etiquetados, a veces partiendo de una base preentrenada | Tiene volumen e historial, y las clases son visual o lingüísticamente distintas | No tiene datos etiquetados, o aparece una nueva clase con solo un puñado de ejemplos |
| Gran modelo de lenguaje | Un modelo preentrenado lee el documento y razona sobre él, a menudo sin ejemplos de entrenamiento | Las clases se describen con palabras en lugar de aprenderse, hay una cola larga de tipos poco frecuentes, o hay idiomas mixtos | El coste por documento importa a gran volumen, o necesita que la misma entrada dé siempre la misma respuesta |
Dos notas prácticas. La clasificación basada en reglas está pasada de moda y sigue siendo la elección correcta para un flujo con código de barras, alto volumen e invariable, porque es económica, rápida y auditable. Y un modelo de lenguaje que clasifica bien sin datos de entrenamiento puede seguir siendo la respuesta equivocada en diez millones de documentos al año, únicamente por el coste unitario. Pregunte qué enfoque gestiona qué parte de su combinación, y desconfíe de una única respuesta para todo.
La tasa de procesamiento directo es la cifra por la que comprar
La precisión es una sola cifra que oculta la distribución que hay debajo, que es exactamente la información que necesita. La métrica que predice su coste operativo es la tasa de procesamiento directo: la proporción de documentos que atraviesan el sistema sin que una persona los toque, con un umbral de confianza que esté dispuesto a defender ante un auditor.
Las dos cifras se separan con rapidez. Compare dos candidatos con diez mil documentos al mes, uno más preciso en general y otro mejor calibrado sobre su propia certeza:
| Preciso pero indeciso | Menos preciso, bien calibrado | |
|---|---|---|
| Precisión de titular | 95 por ciento | 90 por ciento |
| Documentos despejados automáticamente con su umbral | 6000 | 8500 |
| Documentos en la cola de revisión | 4000 | 1500 |
| Minutos de revisor a 40 segundos cada uno | 2667 | 1000 |
El primer candidato gana la demostración y le cuesta 1667 minutos de revisor adicionales cada mes, aproximadamente una persona a tiempo completo. El segundo es menos preciso y mucho más barato de operar, porque tiene confianza cuando acierta y es honesto cuando no. La calibración, no la precisión bruta, es lo que está pagando.
Después pregunte dónde caen los errores. Una matriz de confusión se lo dice; un porcentaje nunca lo hará. Archivar mal un albarán de entrega como otro albarán de entrega es ruido. Archivar mal un contrato firmado como una factura puede dejar un compromiso fuera de su calendario de retención y fuera del modelo de permisos que se suponía que debía protegerlo. Los errores no son intercambiables, y el coste de un error depende por completo de qué dos clases se intercambiaron.
Así que pida a cada proveedor tres cosas: la matriz de confusión sobre su propia muestra, el umbral de confianza usado para producir la cifra de despeje automático, y la tasa de procesamiento directo resultante. Un proveedor que solo le dé una única cifra de precisión le está diciendo algo.
Ocho criterios para puntuar cada candidato
Las listas de características de los productos convergen con rapidez. Lo que separa a los candidatos es cómo se comporta cada capacidad con sus documentos, a sus volúmenes, bajo sus auditores. Puntúe cada candidato con estos ocho criterios, e insista en probarlos con su propio conjunto de muestra y no con el corpus de demostración del proveedor.
| Criterio | Cómo probarlo | Cómo es una buena respuesta |
|---|---|---|
| Precisión de clasificación | Ejecute varios cientos de sus propios documentos, incluidos escaneos deficientes y archivos multilingües | La precisión en su corpus se mantiene a pocos puntos de la cifra de la demostración |
| Tiempo hasta el primer modelo útil | Cuente los días naturales desde la entrega de datos hasta un clasificador funcional | Semanas y no trimestres, sin un contrato de servicios abierto |
| Profundidad de integración | Escriba los resultados de vuelta en su ECM, ERP o sistema de casos, no solo léalos de una carpeta monitorizada | Sincronización bidireccional con mapeo a nivel de campo y tratamiento de errores definido |
| Circuito de revisión humana | Enrute los documentos de baja confianza a un revisor y siga la ruta de corrección | Las correcciones alimentan el reentrenamiento, y la cola es visible para operaciones |
| Evidencia de auditoría | Pregunte quién clasificó cada documento, cuándo, y con qué versión de modelo | Una pista por documento que pueda exportar para un auditor |
| Residencia de datos | Confirme dónde se procesan los documentos y si entrenan modelos compartidos | Procesamiento en su región, en su tenant, sin entrenar con su contenido por defecto |
| Comportamiento bajo carga máxima | Pruebe el pico de fin de mes o de fin de año, no el día promedio | El rendimiento se degrada de forma predecible frente a un límite documentado |
| Coste en el tercer año | Modele el crecimiento del volumen, el reprocesamiento y el tiempo de revisor, no solo las cuotas de licencia | El coste por documento baja a medida que sube el volumen |
Ejecutar una prueba de concepto que le diga algo
La mayoría de las pruebas de concepto son teatro. Usan una muestra seleccionada, las puntúa el proveedor, y aprueban. Una útil está diseñada para poder fallar.
- Extraiga la muestra al azar. Varios cientos de documentos como mínimo, extraídos de un rango de fechas real, y no elegidos por quien esté más entusiasmado con el proyecto.
- Incluya los feos. Fotografías de teléfono, faxes, documentos escaneados al revés, PDF con varios documentos que necesitan dividirse antes de que pueda ocurrir nada más, formularios rellenados a mano, y cualquier mezcla de idiomas que reciba de verdad. Excluir estos es como una prueba de concepto produce una cifra que no puede usar.
- Reserve un conjunto de prueba que el proveedor nunca vea. Si el mismo equipo ajusta y puntúa, está midiendo su ajuste, no el producto.
- Anote qué es aprobar y qué es suspender antes de empezar. Nombre la tasa de procesamiento directo, la tasa máxima aceptable para las confusiones específicas que le perjudicarían, y los minutos de revisor que puede permitirse. Acordar esto después es como un resultado marginal se convierte en una compra.
- Mida los minutos de revisor, no solo la precisión. Cronometre cuánto tarda realmente una corrección en la interfaz que la gente usará cada día.
- Ejecute el pico. Empuje un volumen de fin de mes y observe qué le ocurre a la latencia y a la cola.
Pregunte qué ocurre cuando aparece un tipo de documento que nunca estuvo en el conjunto de entrenamiento, y observe si el sistema dice que no lo sabe o elige en silencio la clase más cercana. El segundo comportamiento es mucho más costoso, y solo lo verá si lo pone a prueba.
Despliegue: nube, en local o híbrido
Los pros y los contras genéricos no ayudan mucho aquí. Cuatro preguntas lo deciden en la práctica.
¿Dónde se permite procesar el contenido, y entrena algo con él? Esta suele ser la restricción vinculante en los sectores regulados y la primera que hay que resolver. Consígalo por escrito de que sus documentos no se usan para entrenar modelos compartidos, si eso es lo que necesita.
¿Cómo es el pico? La capacidad elástica es el argumento más claro a favor de la nube, y solo importa si su volumen es genuinamente irregular.
¿En qué tiene que escribir, y a qué distancia está eso? Si el sistema de referencia está en local, la clasificación situada en otro lugar añade un viaje de ida y vuelta a cada documento y un nuevo modo de fallo entre ambos.
¿Quién lo parchea? En local significa que su equipo es dueño de las actualizaciones, las actualizaciones de modelo y la postura de seguridad. Ese es un coste de personal real, y es la línea que más a menudo se deja fuera de la comparación.
Lo híbrido merece su complejidad cuando una clase de contenido genuinamente no puede salir, y el resto se beneficia genuinamente de la elasticidad. Si ninguna de las dos cosas es cierta, lo híbrido son dos sistemas que mantener en lugar de uno. Nuestra guía sobre la gestión de contenido empresarial basada en la nube repasa la misma disyuntiva para la plataforma de contenido más amplia.
La integración va de escribir de vuelta, no de leer desde
Todos los proveedores integran. Casi todos quieren decir que pueden vigilar una carpeta o un buzón, que es la mitad fácil y prácticamente inútil por sí sola. La clasificación solo crea valor una vez que la etiqueta, la puntuación de confianza y la pista de auditoría llegan al sistema donde ocurre realmente el trabajo.
Insista en cuatro cosas:
- Mapeo a nivel de campo. ¿Qué campo de destino recibe la clase, y cuál recibe la puntuación de confianza? Si la confianza se pierde en el camino, ha perdido la capacidad de priorizar.
- Tratamiento de errores. ¿Qué ocurre cuando el sistema de destino rechaza la escritura? Una política de reintento, una cola de mensajes fallidos y una alerta, o una pérdida silenciosa.
- Idempotencia. Si el mismo documento se procesa dos veces, ¿obtiene un registro o dos? El reprocesamiento es normal, así que esto surge en el segundo mes, no en el segundo año.
- Reclasificación. Cuando un revisor corrige una etiqueta, ¿la corrección se propaga al sistema de referencia, o solo al conjunto de entrenamiento? Un sistema que mejora continuamente a partir de las correcciones vale poco si esas correcciones nunca llegan al lugar donde el negocio realmente lee.
El patrón al que aspirar es que la clasificación sea un paso dentro de un flujo más amplio de procesamiento inteligente de documentos en lugar de una herramienta independiente, de modo que la retención, los permisos y el enrutamiento hereden todos la etiqueta en lugar de configurarse de nuevo a mano. Esa herencia es de donde procede realmente la mayor parte del retorno, y se trata con más detalle en nuestra descripción general de gestión de documentos y contenido.
Lo que cuesta, y dónde se sitúa realmente el coste
Las cuotas de licencia son la línea que todos comparan y rara vez la más grande. A lo largo de tres años, la distribución real suele verse así:
- Tiempo de revisor. Determinado directamente por la tasa de procesamiento directo. Por eso la conversación sobre precisión de arriba es una conversación sobre costes.
- Construcción de la integración. Escribir los resultados en un sistema de referencia, con mapeo y tratamiento de errores, es un proyecto. Presupuéstelo una vez y espere revisarlo cuando el sistema de destino se actualice.
- Mantenimiento de la taxonomía. Las clases cambian con el tiempo. Alguien tiene que ser el responsable, y si nadie lo es, la precisión se degrada en silencio.
- Reprocesamiento. Las actualizaciones de modelo y las taxonomías corregidas implican volver a ejecutar el volumen histórico. Pregunte si el reprocesamiento se factura por medición.
- Licencia e infraestructura. Por documento, por página, por usuario o por núcleo, y la forma importa tanto como la tarifa.
La señal saludable es que el coste por documento baja a medida que sube el volumen. Si una cotización escala de forma lineal para siempre, está financiando el margen de otro con su crecimiento. Modele el tercer año, no el primero, y pregunte qué ocurre con el precio cuando el volumen se duplica.
Dónde da sus frutos antes la clasificación
El valor aparece dondequiera que una etiqueta desbloquee una decisión posterior en lugar de limitarse a ordenar una carpeta.
En sanidad, la clasificación separa el contenido clínico del administrativo en el punto de captura, de modo que los registros caen bajo la regla de retención y la política de acceso correctas sin que una persona elija. En el ámbito legal y contractual, distingue un acuerdo ejecutado de un borrador, que es la diferencia entre una obligación vinculante y un expediente de trabajo. En los servicios financieros, el motor suele ser la evidencia: mostrar a un inspector qué documentos respaldaron una decisión, y cuándo. En educación, es el volumen, con ciclos de admisión que concentran un año de papeleo en unas pocas semanas.
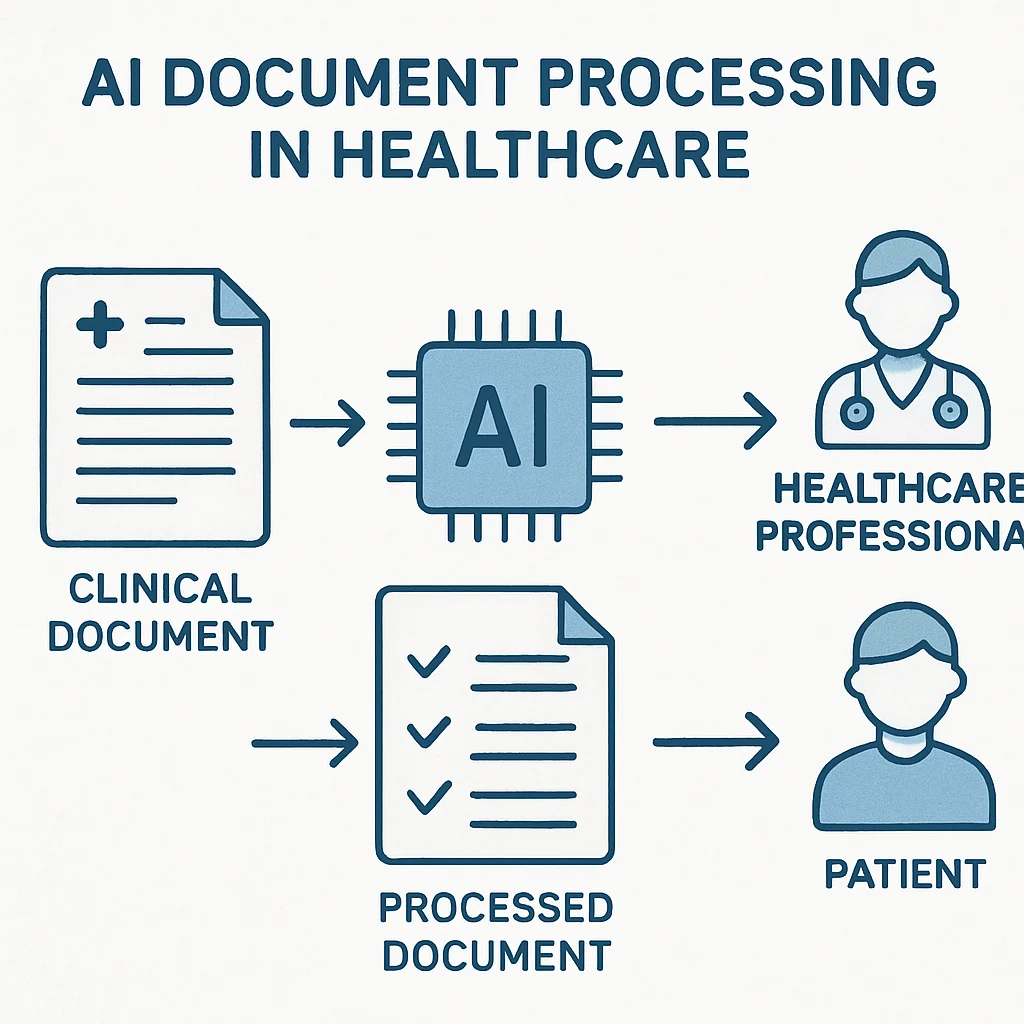
El hilo común es que la clasificación vale más donde ocurre algo automático después. Si la etiqueta solo ayuda a una búsqueda humana posterior, el retorno es real pero mucho menor. Donde la retención y la disposición dependen de ella, el argumento es mucho más sólido, algo que trata nuestra página de cumplimiento y gestión de registros.
Cinco errores que aparecen una y otra vez
- Comprar por la precisión de la demostración. El corpus de la demostración se eligió para que funcionara. El suyo no.
- Desplegar sin un circuito de revisión. Si los documentos de baja confianza no tienen adónde ir, el sistema o bien bloquea el trabajo o adivina. Ambas cosas son peores que una cola.
- Demasiadas clases. Cuarenta clases con límites difusos siempre clasificarán peor que doce con límites claros. Empiece con algo grueso y divida solo cuando una división cambie lo que ocurre después.
- Dejar la taxonomía sin propietario. Un esquema de clasificación es algo vivo. Sin un propietario, la precisión se degrada y nadie se da cuenta hasta que alguien no puede encontrar algo.
- Ignorar qué hereda la etiqueta. Si la retención, los permisos y el enrutamiento se siguen configurando a mano después, ha automatizado el paso fácil y ha conservado todos los costosos.
Dónde encaja Contellect One
Contellect One aplica la clasificación en el momento de la captura, con una puntuación de confianza en cada decisión, de modo que el enrutamiento, la retención, los permisos y la búsqueda heredan todos una etiqueta fiable en lugar de volver a deducir una más adelante. Los documentos de baja confianza van a una cola de revisión, y las correcciones de los revisores retroalimentan el modelo.
Si está evaluando opciones, la página de clasificación documental con IA cubre con más detalle cómo funciona, y la guía de captura inteligente de datos cubre la etapa de captura que la alimenta. Si prefiere probarlo antes que leer sobre ello, pida una prueba de concepto con sus propios documentos y exíjanos los ocho criterios anteriores.
