Software de Classificação Documental
Um guia neutro para escolher software de classificação de documentos: como testar a precisão nos seus documentos, o que pontuar e quanto custa.
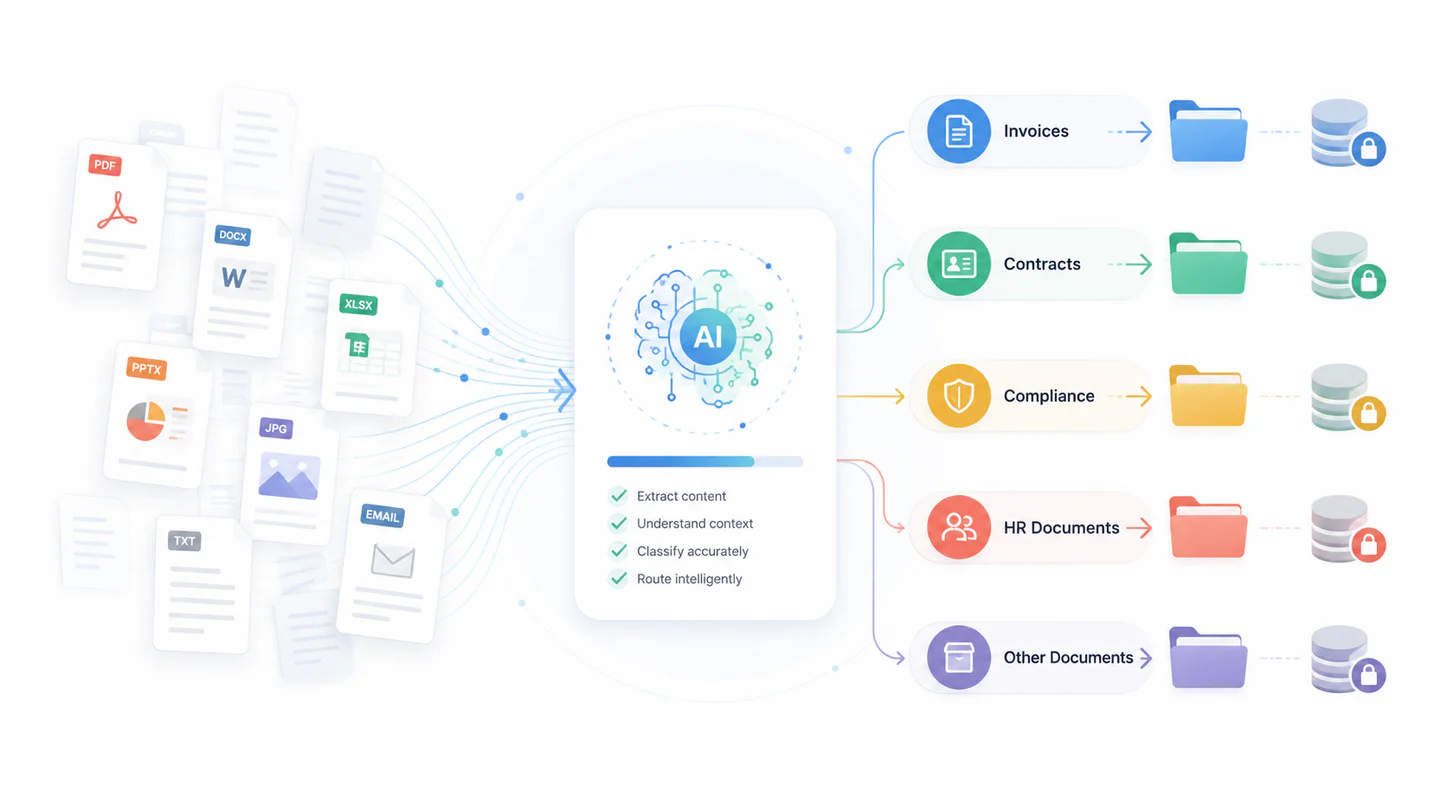
A maioria das demonstrações de software de classificação de documentos parece igual. Um fornecedor solta uma pasta de faturas e contratos em um portal, a tela se enche de documentos organizados com esmero, e um número como 97 por cento aparece. Então você compra, aponta para o seu próprio arquivo, e o número desmorona.
Essa lacuna é o assunto deste guia. Não o que é o software de classificação de documentos, mas como distinguir dois produtos quando ambos alegam classificação por IA, integrações prontas e segurança corporativa, e como conduzir uma avaliação que preveja o que você realmente obterá em produção.
A versão curta: pare de comprar com base em precisão. Compre com base na taxa de processamento direto, medida nos seus próprios documentos, com seus próprios revisores no ciclo.
O que o software de classificação de documentos realmente faz
O software que automatiza a classificação de documentos atribui cada documento recebido a uma categoria de negócio com base no que ele contém. Este é um pedido de compra, aquele é um aviso de remessa, este outro é um NDA assinado. Funciona em formulários estruturados, documentos semiestruturados como faturas em que os campos são consistentes mas o layout não é, e conteúdo totalmente não estruturado, como correspondência. É uma etapa em uma cadeia que fornecedores e compradores costumam confundir:
- OCR transforma pixels em caracteres. Não tem ideia do que é o documento.
- Classificação decide que tipo de documento é.
- Extração retira valores nomeados dele, uma vez conhecido o tipo.
A ordem importa mais do que parece. As regras de extração costumam ser específicas por classe, então um erro de classificação contamina tudo a jusante. Rotular uma fatura como uma nota de entrega faz cada regra de extração disparar contra o modelo errado, a cadeia de aprovação errada começa, e o erro surge semanas depois como um pagamento que ninguém consegue rastrear.
O resultado útil, portanto, não é o rótulo isoladamente, mas o rótulo junto com um índice de confiança. Um classificador que acerta na maior parte do tempo e fica em silêncio sobre suas falhas é um passivo. Um que relata sua própria incerteza pode ser confiado no restante, porque você consegue encaminhar os documentos duvidosos a uma pessoa e deixar os confiantes em paz.
Três abordagens, e quando cada uma é a resposta certa
Quase todo produto no mercado é uma dessas três, ou uma combinação delas. Os fornecedores raramente dizem qual, então pergunte.
| Abordagem | Como decide | Mais forte quando | Mais fraca quando |
|---|---|---|---|
| Baseada em regras | Palavras-chave, expressões regulares, códigos de barras, zonas de layout | O conjunto de documentos é estável e estruturado, e você precisa que toda decisão seja explicável | Os formatos variam, ou um fornecedor muda um modelo e as regras silenciosamente param de corresponder |
| Aprendizado de máquina treinado | Modelos treinados aprendidos a partir dos seus exemplos rotulados, às vezes partindo de uma base pré-treinada | Você tem volume e histórico, e as classes são visualmente ou linguisticamente distintas | Você não tem dados rotulados, ou uma nova classe aparece com apenas alguns exemplos |
| Grande modelo de linguagem | Um modelo pré-treinado lê o documento e raciocina sobre ele, muitas vezes sem exemplos de treinamento | As classes são descritas em palavras, em vez de aprendidas, cauda longa de tipos raros, idiomas mistos | O custo por documento importa em alto volume, ou você precisa que a mesma entrada dê sempre a mesma resposta |
Duas notas práticas. A classificação baseada em regras é fora de moda e ainda é a escolha correta para um fluxo com código de barras, alto volume e imutável, porque é barata, rápida e auditável. E um modelo de linguagem que classifica bem sem dados de treinamento ainda pode ser a resposta errada em dez milhões de documentos por ano, puramente pelo custo unitário. Pergunte qual abordagem trata qual parte da sua combinação, e desconfie de uma única resposta para tudo.
A taxa de processamento direto é o número em que basear a compra
A precisão é um único número que esconde a distribuição por trás dele, que é exatamente a informação de que você precisa. A métrica que prevê seu custo operacional é a taxa de processamento direto: a fração de documentos que atravessam o sistema sem uma pessoa tocá-los, em um limiar de confiança que você está disposto a defender diante de um auditor.
Os dois se distanciam rapidamente. Compare dois candidatos em dez mil documentos por mês, um mais preciso no geral e outro melhor calibrado sobre sua própria certeza:
| Preciso mas hesitante | Menos preciso, bem calibrado | |
|---|---|---|
| Precisão de destaque | 95 por cento | 90 por cento |
| Documentos liberados automaticamente no seu limiar | 6.000 | 8.500 |
| Documentos na fila de revisão | 4.000 | 1.500 |
| Minutos de revisor a 40 segundos cada | 2.667 | 1.000 |
O primeiro candidato vence a demonstração e custa a você 1.667 minutos extras de revisor todo mês, aproximadamente uma pessoa em tempo integral. O segundo é menos preciso e muito mais barato de operar, porque é confiante quando está certo e honesto quando não está. Calibração, não precisão bruta, é o que você está pagando.
Depois, pergunte onde os erros caem. Uma matriz de confusão diz isso; uma porcentagem nunca dirá. Arquivar incorretamente uma nota de entrega como outra nota de entrega é ruído. Arquivar incorretamente um contrato assinado como uma fatura pode colocar um compromisso fora da sua tabela de temporalidade e fora do modelo de permissão que deveria protegê-lo. Os erros não são intercambiáveis, e o custo de um engano depende inteiramente de quais duas classes foram trocadas.
Então peça a cada fornecedor três coisas: a matriz de confusão na sua própria amostra, o limiar de confiança usado para produzir o número de liberação automática, e a taxa de processamento direto resultante. Um fornecedor que só lhe dá um único número de precisão está lhe dizendo algo.
Oito critérios para pontuar cada candidato
As listas de recursos de produto convergem rapidamente. O que separa os candidatos é como cada capacidade se comporta nos seus documentos, nos seus volumes, sob seus auditores. Pontue cada candidato contra estes oito, e insista em testá-los contra sua própria amostra, e não o corpus de demonstração do fornecedor.
| Critério | Como testar | Como é uma boa resposta |
|---|---|---|
| Precisão de classificação | Rode várias centenas dos seus próprios documentos, incluindo digitalizações ruins e arquivos multilíngues | A precisão no seu corpus permanece a poucos pontos do número da demonstração |
| Tempo até o primeiro modelo útil | Conte os dias corridos da entrega dos dados até um classificador funcional | Semanas, não trimestres, sem um contrato de serviços em aberto |
| Profundidade de integração | Escreva resultados de volta no seu ECM, ERP ou sistema de casos, não apenas leia de uma pasta monitorada | Sincronização bidirecional com mapeamento em nível de campo e tratamento de erro definido |
| Ciclo de revisão humana | Encaminhe documentos de baixa confiança a um revisor e siga o caminho de correção | As correções alimentam o retreinamento, e a fila é visível para as operações |
| Evidência de auditoria | Pergunte quem classificou cada documento, quando, e em qual versão de modelo | Uma trilha por documento que você consegue exportar para um auditor |
| Residência de dados | Confirme onde os documentos são processados e se treinam modelos compartilhados | Processamento na sua região, no seu tenant, sem treinamento no seu conteúdo por padrão |
| Comportamento sob carga de pico | Teste o pico de fim de mês ou fim de ano, não o dia médio | A vazão degrada de forma previsível contra um teto documentado |
| Custo no terceiro ano | Modele crescimento de volume, reprocessamento e tempo de revisor, não apenas taxas de licença | O custo por documento cai à medida que o volume aumenta |
Conduzindo uma prova de conceito que diga algo
A maioria das provas de conceito é teatro. Usam uma amostra curada, são pontuadas pelo fornecedor, e passam. Uma útil é montada para poder falhar.
- Extraia a amostra aleatoriamente. Várias centenas de documentos no mínimo, retirados de um intervalo de datas real, não escolhidos por quem está mais entusiasmado com o projeto.
- Inclua os feios. Fotos de celular, faxes, documentos digitalizados de cabeça para baixo, PDFs multidocumento que precisam ser divididos antes que qualquer outra coisa possa acontecer, formulários preenchidos à mão, e qualquer mistura de idiomas que você genuinamente recebe. Excluir esses é como uma prova de conceito produz um número que você não pode usar.
- Reserve um conjunto de teste que o fornecedor nunca vê. Se a mesma equipe ajusta e pontua, você está medindo o ajuste dela, não o produto.
- Anote aprovação e reprovação antes de começar. Nomeie a taxa de processamento direto, a taxa máxima aceitável para as confusões específicas que prejudicariam você, e os minutos de revisor que você pode bancar. Concordar isso depois é como um resultado marginal vira uma compra.
- Meça os minutos de revisor, não apenas a precisão. Cronometre quanto tempo uma correção realmente leva na interface que as pessoas usarão todos os dias.
- Rode o pico. Empurre um volume de fim de mês pelo sistema e observe o que acontece com a latência e com a fila.
Pergunte o que acontece quando aparece um tipo de documento que nunca esteve no conjunto de treinamento, e observe se o sistema diz que não sabe ou silenciosamente escolhe a classe mais próxima. O segundo comportamento é muito mais caro, e você só verá isso se testar para isso.
Implantação: nuvem, on-premises ou híbrida
Prós e contras genéricos não ajudam muito aqui. Quatro perguntas decidem isso na prática.
Onde o conteúdo pode ser processado, e isso treina alguma coisa? Essa costuma ser a restrição vinculante em setores regulados, e a primeira a resolver. Obtenha por escrito que seus documentos não são usados para treinar modelos compartilhados, se for isso que você precisa.
Como é o pico? A capacidade elástica é o argumento mais claro para a nuvem, e só importa se o seu volume é genuinamente instável.
Em que precisa escrever, e a que distância isso está? Se o sistema de registro é on-premises, a classificação em outro lugar acrescenta uma viagem de ida e volta a cada documento e um novo modo de falha entre eles.
Quem faz os patches? On-premises significa que sua equipe é dona das atualizações, das atualizações de modelo e da postura de segurança. Isso é um custo real de equipe, e é a linha mais frequentemente deixada de fora da comparação.
O híbrido merece sua complexidade quando uma classe de conteúdo genuinamente não pode sair, e o resto genuinamente se beneficia da elasticidade. Se nenhum dos dois for verdade, o híbrido é dois sistemas para manter em vez de um. Nosso guia de ECM corporativo em nuvem trata da mesma escolha para a plataforma de conteúdo mais ampla.
Integração é sobre escrever de volta, não apenas ler
Todo fornecedor se integra. Quase todos querem dizer que conseguem monitorar uma pasta ou uma caixa de entrada, que é a metade fácil e quase inútil sozinha. A classificação só cria valor quando o rótulo, o índice de confiança e a trilha de auditoria chegam ao sistema onde o trabalho realmente acontece.
Pressione em quatro pontos:
- Mapeamento em nível de campo. Qual campo de destino recebe a classe, e qual recebe o índice de confiança? Se a confiança é descartada no caminho, você perdeu a capacidade de triagem.
- Tratamento de erro. O que acontece quando o sistema de destino rejeita a escrita? Uma política de nova tentativa, uma fila de mensagens mortas e um alerta, ou uma perda silenciosa.
- Idempotência. Se o mesmo documento é processado duas vezes, você obtém um registro ou dois? O reprocessamento é normal, então isso aparece no segundo mês, não no segundo ano.
- Reclassificação. Quando um revisor corrige um rótulo, a correção se propaga para o sistema de registro, ou apenas para o conjunto de treinamento? Um sistema que melhora continuamente a partir de correções vale pouco se essas correções nunca chegam ao lugar que o negócio realmente lê.
O padrão a buscar é que a classificação seja uma etapa dentro de um fluxo mais amplo de processamento inteligente de documentos, e não uma ferramenta isolada, para que retenção, permissões e encaminhamento herdem o rótulo, em vez de serem definidos de novo à mão. Essa herança é de onde vem a maior parte do retorno de fato, e isso é tratado com mais detalhes na nossa visão geral de gestão de documentos e conteúdo.
Quanto custa, e onde o custo realmente está
As taxas de licença são a linha que todo mundo compara e raramente a maior. Ao longo de três anos, a distribuição real costuma parecer assim:
- Tempo de revisor. Definido diretamente pela taxa de processamento direto. É por isso que a conversa sobre precisão acima é uma conversa sobre custo.
- Construção da integração. Escrever resultados em um sistema de registro, com mapeamento e tratamento de erro, é um projeto. Orce isso uma vez e espere revisitá-lo quando o sistema de destino for atualizado.
- Manutenção da taxonomia. As classes derivam. Alguém precisa ser dono disso, e se ninguém for, a precisão decai silenciosamente.
- Reprocessamento. Atualizações de modelo e taxonomias corrigidas significam reprocessar o volume histórico. Pergunte se o reprocessamento é medido.
- Licença e infraestrutura. Por documento, por página, por usuário ou por núcleo, e o formato importa tanto quanto a taxa.
O sinal saudável é que o custo por documento cai à medida que o volume aumenta. Se um orçamento escala linearmente para sempre, você está financiando a margem de outra pessoa com o seu crescimento. Modele o terceiro ano, não o primeiro, e pergunte o que acontece com o preço quando o volume dobra.
Onde a classificação compensa primeiro
O valor aparece onde um rótulo desbloqueia uma decisão a jusante, em vez de apenas organizar uma pasta.
Na saúde, a classificação separa conteúdo clínico de administrativo no ponto de captura, para que os registros caiam sob a regra de retenção certa e a política de acesso certa sem que uma pessoa escolha. No jurídico e em contratos, ela distingue um acordo executado de uma minuta, que é a diferença entre uma obrigação vinculante e um arquivo de trabalho. Em serviços financeiros, o motivador costuma ser a evidência: mostrar a um examinador quais documentos sustentaram uma decisão, e quando. Na educação, é volume, com ciclos de admissão que concentram um ano de papelada em poucas semanas.
O fio condutor comum é que a classificação vale mais onde algo automático acontece em seguida. Se o rótulo só ajuda uma busca humana depois, o retorno é real, mas muito menor. Onde a retenção e a destinação dependem dele, o argumento é muito mais forte, o que nossa página de conformidade e gestão de registros aborda.
Cinco erros que aparecem repetidamente
- Comprar com base na precisão da demonstração. O corpus da demonstração foi escolhido para funcionar. O seu não foi.
- Lançar sem um ciclo de revisão. Se os documentos de baixa confiança não têm para onde ir, o sistema ou bloqueia o trabalho ou chuta. Ambos são piores do que uma fila.
- Classes demais. Quarenta classes com limites imprecisos sempre classificarão pior do que doze com limites claros. Comece grosseiro e divida apenas quando uma divisão mudar o que acontece a seguir.
- Deixar a taxonomia sem dono. Um esquema de classificação é algo vivo. Sem um dono, a precisão decai e ninguém percebe até que alguém não consiga encontrar algo.
- Ignorar o que herda o rótulo. Se retenção, permissões e encaminhamento ainda são definidos à mão depois, você automatizou a etapa fácil e manteve todas as caras.
Onde o Contellect One se encaixa
O Contellect One aplica a classificação no momento da captura, com um índice de confiança em cada decisão, para que encaminhamento, retenção, permissões e busca herdem todos um rótulo confiável, em vez de derivar um de novo depois. Documentos de baixa confiança vão para uma fila de revisão, e as correções dos revisores realimentam o modelo.
Se você está avaliando opções, a página de classificação de documentos com IA trata de como isso funciona em mais detalhes, e o guia de captura inteligente de dados trata do estágio de captura que a alimenta. Se você prefere testar a ler sobre isso, peça uma prova de conceito nos seus próprios documentos e nos cobre pelos oito critérios acima.
