Guida software classificazione documenti
Guida imparziale alla scelta del software di classificazione documenti: come testare l'accuratezza sui vostri documenti, cosa valutare e quanto costa davvero.
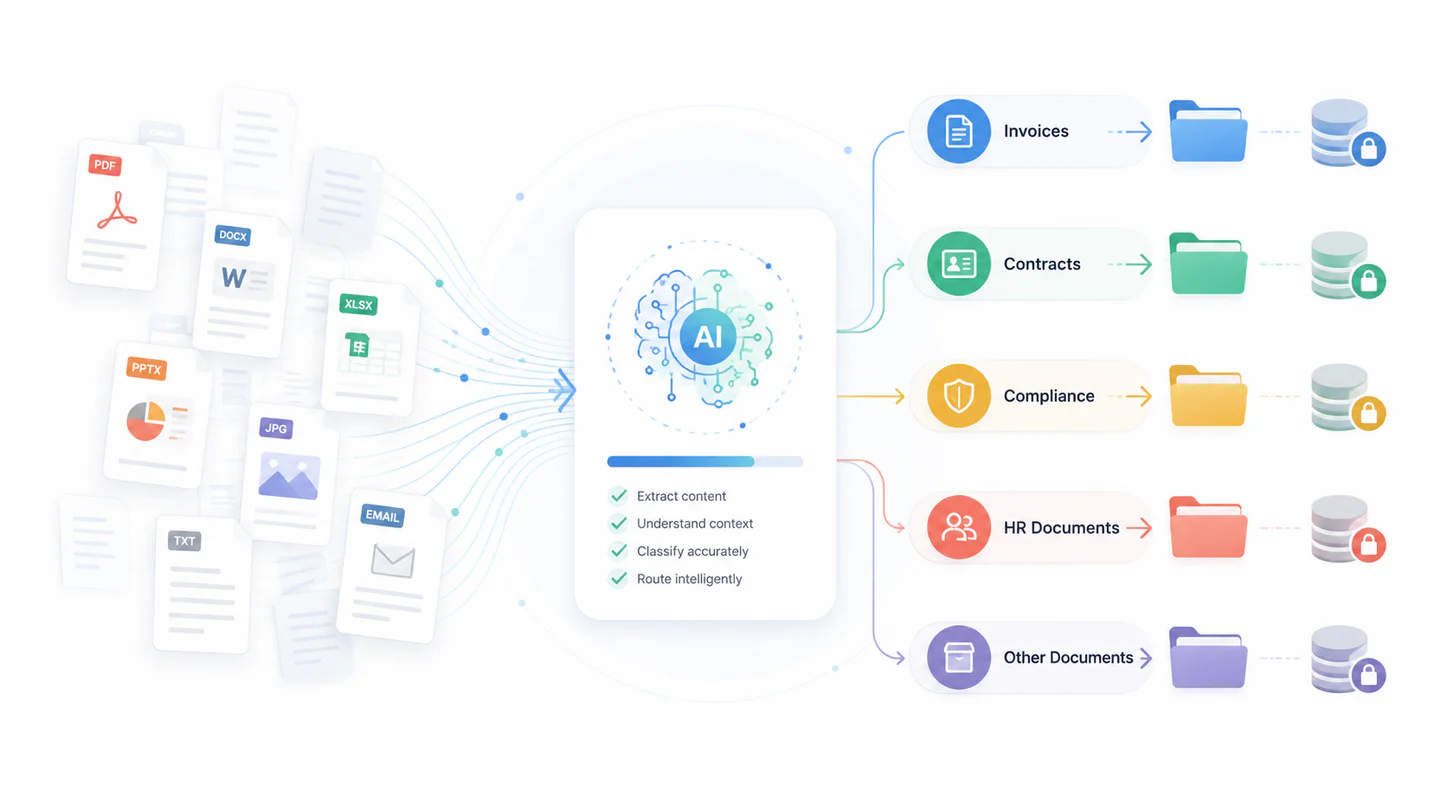
La maggior parte delle demo di software di classificazione documenti si assomiglia. Un fornitore carica una cartella di fatture e contratti in un portale, lo schermo si riempie di documenti ordinatamente smistati, e appare un numero come il 97 percento. Poi lo acquistate, lo puntate sul vostro archivio, e il numero crolla.
Questo divario è l’oggetto di questa guida. Non cos’è il software di classificazione documenti, ma come distinguere due prodotti quando entrambi rivendicano classificazione AI, integrazioni preconfigurate e sicurezza aziendale, e come condurre una valutazione che preveda cosa otterrete davvero in produzione.
La versione breve: smettete di acquistare in base all’accuratezza. Acquistate in base al tasso di elaborazione diretta, misurato sui vostri documenti, con i vostri revisori nel processo.
Cosa fa davvero il software di classificazione documenti
Il software che automatizza la classificazione documentale assegna ogni documento in arrivo a una categoria di business in base a ciò che contiene. Questo è un ordine di acquisto, quello è un avviso di pagamento, questo qui è un NDA firmato. Funziona su moduli strutturati, documenti semi-strutturati come le fatture in cui i campi sono coerenti ma il layout no, e contenuti del tutto non strutturati come la corrispondenza. È un passaggio in una catena che fornitori e acquirenti spesso confondono tra loro:
- OCR trasforma i pixel in caratteri. Non ha idea di cosa sia il documento.
- Classificazione decide che tipo di documento sia.
- Estrazione ne ricava valori nominati una volta noto il tipo.
L’ordine conta più di quanto sembri. Le regole di estrazione sono di solito specifiche per classe, quindi un errore di classificazione avvelena tutto ciò che segue a valle. Etichettate una fattura come bolla di consegna e ogni regola di estrazione scatta contro il template sbagliato, parte la catena di approvazione sbagliata, e l’errore emerge settimane dopo come un pagamento che nessuno riesce a tracciare.
L’output utile quindi non è l’etichetta da sola, ma l’etichetta più un punteggio di confidenza. Un classificatore che ha ragione la maggior parte delle volte e tace sui propri fallimenti è una passività. Uno che riporta la propria incertezza può essere affidato per il resto, perché potete instradare i documenti dubbi a una persona e lasciare in pace quelli sicuri.
Tre approcci, e quando ciascuno è la risposta giusta
Quasi ogni prodotto sul mercato è uno di questi tre, o una combinazione. I fornitori raramente dicono quale, quindi chiedete.
| Approccio | Come decide | Più efficace quando | Più debole quando |
|---|---|---|---|
| Basato su regole | Parole chiave, espressioni regolari, codici a barre, zone di layout | L’insieme di documenti è stabile e strutturato, e serve che ogni decisione sia spiegabile | I formati derivano, o un fornitore cambia un template e le regole smettono silenziosamente di corrispondere |
| Machine learning addestrato | Modelli addestrati appresi dai vostri esempi etichettati, talvolta partendo da una base pre-addestrata | Avete volume e cronologia, e le classi sono visivamente o linguisticamente distinte | Non avete dati etichettati, o appare una nuova classe con solo una manciata di esempi |
| Large language model | Un modello pre-addestrato legge il documento e ragiona su di esso, spesso senza esempi di addestramento | Le classi sono descritte a parole invece che apprese, coda lunga di tipi rari, lingue miste | Il costo per documento conta ad alto volume, o serve che lo stesso input dia sempre la stessa risposta |
Due note pratiche. La classificazione basata su regole è fuori moda ed è comunque la scelta corretta per un flusso codificato a barre, ad alto volume e immutabile, perché è economica, veloce e verificabile. E un language model che classifica bene senza dati di addestramento può comunque essere la risposta sbagliata a dieci milioni di documenti l’anno, puramente per il costo unitario. Chiedete quale approccio gestisce quale parte del vostro mix, e diffidate di una risposta unica per tutto.
Il tasso di elaborazione diretta è il numero su cui basare l’acquisto
L’accuratezza è un singolo numero che nasconde la distribuzione sottostante, che è esattamente l’informazione di cui avete bisogno. La metrica che prevede il vostro costo operativo è il tasso di elaborazione diretta: la quota di documenti che attraversano il sistema senza che una persona li tocchi, a una soglia di confidenza che siete disposti a difendere davanti a un auditor.
I due si separano rapidamente. Confrontate due candidati su diecimila documenti al mese, uno più accurato complessivamente e uno meglio calibrato sulla propria certezza:
| Accurato ma esitante | Meno accurato, ben calibrato | |
|---|---|---|
| Accuratezza dichiarata | 95 percento | 90 percento |
| Documenti liberati automaticamente alla vostra soglia | 6.000 | 8.500 |
| Documenti nella coda di revisione | 4.000 | 1.500 |
| Minuti di revisione a 40 secondi ciascuno | 2.667 | 1.000 |
Il primo candidato vince la demo e vi costa 1.667 minuti di revisione extra ogni mese, circa una persona a tempo pieno. Il secondo è meno accurato e molto più economico da gestire, perché è sicuro quando ha ragione e onesto quando non ce l’ha. È la calibrazione, non l’accuratezza grezza, quella che state pagando.
Poi chiedete dove atterrano gli errori. Una matrice di confusione ve lo dice; una percentuale non lo farà mai. Archiviare male una bolla di consegna come un’altra bolla di consegna è rumore. Archiviare male un contratto firmato come una fattura può mettere un impegno fuori dal vostro piano di conservazione e fuori dal modello di permessi che avrebbe dovuto proteggerlo. Gli errori non sono intercambiabili, e il costo di uno sbaglio dipende interamente da quali due classi sono state scambiate.
Quindi chiedete a ogni fornitore tre cose: la matrice di confusione sul vostro campione, la soglia di confidenza usata per produrre il numero di liberazione automatica, e il tasso di elaborazione diretta risultante. Un fornitore che vi darà solo una singola cifra di accuratezza vi sta dicendo qualcosa.
Otto criteri per valutare ogni candidato
Gli elenchi di funzionalità dei prodotti convergono rapidamente. Ciò che separa i candidati è come ogni capacità si comporta sui vostri documenti, ai vostri volumi, sotto i vostri auditor. Valutate ogni candidato rispetto a questi otto criteri, e insistete per testarli sul vostro campione anziché sul corpus demo del fornitore.
| Criterio | Come testarlo | Come si presenta una buona risposta |
|---|---|---|
| Accuratezza della classificazione | Elaborate diverse centinaia dei vostri documenti, incluse scansioni scadenti e file in più lingue | L’accuratezza sul vostro corpus resta entro pochi punti dalla cifra demo |
| Tempo al primo modello utile | Contate i giorni di calendario dalla consegna dei dati a un classificatore funzionante | Settimane, non trimestri, senza un impegno di servizi a tempo indeterminato |
| Profondità dell’integrazione | Scrivete i risultati nel vostro ECM, ERP o sistema di gestione dei casi, non solo leggerli da una cartella monitorata | Sincronizzazione bidirezionale con mappatura a livello di campo e gestione degli errori definita |
| Ciclo di revisione umana | Instradate i documenti a bassa confidenza a un revisore e seguite il percorso di correzione | Le correzioni alimentano il riaddestramento, e la coda è visibile alle operations |
| Evidenza di audit | Chiedete chi ha classificato ogni documento, quando, e su quale versione del modello | Una traccia per documento che potete esportare per un auditor |
| Residenza dei dati | Confermate dove vengono elaborati i documenti e se addestrano modelli condivisi | Elaborazione nella vostra regione, nel vostro tenant, senza addestramento sui vostri contenuti per impostazione predefinita |
| Comportamento sotto carico di picco | Testate il picco di fine mese o fine anno, non il giorno medio | Il throughput degrada in modo prevedibile rispetto a un tetto documentato |
| Costo al terzo anno | Modellate la crescita del volume, la rielaborazione e il tempo di revisione, non solo le licenze | Il costo per documento diminuisce all’aumentare del volume |
Condurre una proof of concept che vi dica qualcosa
La maggior parte delle proof of concept sono teatro. Usano un campione curato, vengono valutate dal fornitore, e superano il test. Una utile è impostata per poter fallire.
- Estraete il campione a caso. Almeno diverse centinaia di documenti, presi da un intervallo di date reale, non scelti da chi è più entusiasta del progetto.
- Includete quelli brutti. Foto scattate col telefono, fax, documenti scansionati capovolti, PDF multi-documento che devono essere separati prima che possa succedere qualsiasi altra cosa, moduli compilati a mano, e qualsiasi mix linguistico che ricevete realmente. Escluderli è il modo in cui una proof of concept produce un numero che non potete usare.
- Trattenete un set di test che il fornitore non vede mai. Se lo stesso team calibra e valuta, state misurando la loro calibrazione, non il prodotto.
- Scrivete cosa significa superare o fallire prima di iniziare. Definite il tasso di elaborazione diretta, il tasso massimo accettabile per le confusioni specifiche che vi danneggerebbero, e i minuti di revisione che potete permettervi. Concordare questo in seguito è il modo in cui un risultato marginale diventa un acquisto.
- Misurate i minuti di revisione, non solo l’accuratezza. Cronometrate quanto tempo richiede realmente una correzione nell’interfaccia che le persone useranno ogni giorno.
- Eseguite il picco. Fate passare un volume di fine mese e osservate cosa succede alla latenza e alla coda.
Chiedete cosa succede quando appare un tipo di documento mai presente nel set di addestramento, e osservate se il sistema dice di non sapere o sceglie silenziosamente la classe più vicina. Il secondo comportamento è molto più costoso, e lo vedrete solo se lo testate.
Implementazione: cloud, on-premises o ibrida
I pro e contro generici non aiutano molto qui. Quattro domande decidono in pratica.
Dove è consentito elaborare i contenuti, e questo addestra qualcosa? Questo è di solito il vincolo cogente nei settori regolamentati e quello da definire per primo. Fatevi mettere per iscritto che i vostri documenti non vengono usati per addestrare modelli condivisi, se è questo di cui avete bisogno.
Come si presenta il picco? La capacità elastica è l’argomento più chiaro a favore del cloud, e conta solo se il vostro volume è genuinamente irregolare.
In cosa deve scrivere, e quanto è distante? Se il sistema di record è on-premises, avere la classificazione altrove aggiunge un percorso di andata e ritorno a ogni documento e una nuova modalità di guasto tra i due.
Chi applica le patch? On-premises significa che il vostro team possiede gli aggiornamenti, gli update dei modelli e la postura di sicurezza. Questo è un costo reale di personale, ed è la voce più spesso omessa dal confronto.
L’ibrido si guadagna la propria complessità quando una classe di contenuti non può davvero uscire, e il resto beneficia davvero dell’elasticità. Se nessuna delle due condizioni è vera, l’ibrido significa due sistemi da mantenere invece di uno. La nostra guida all’ECM aziendale basato su cloud analizza lo stesso compromesso per la piattaforma di contenuti più ampia.
L’integrazione riguarda la scrittura, non la lettura
Ogni fornitore si integra. Quasi tutti intendono che possono monitorare una cartella o una casella di posta, il che è la metà facile e quasi inutile da sola. La classificazione crea valore solo una volta che l’etichetta, il punteggio di confidenza e l’audit trail atterrano nel sistema dove il lavoro avviene realmente.
Insistete su quattro cose:
- Mappatura a livello di campo. Quale campo di destinazione riceve la classe, e quale riceve il punteggio di confidenza? Se la confidenza viene scartata durante il tragitto, avete perso la capacità di smistare per priorità.
- Gestione degli errori. Cosa succede quando il sistema di destinazione rifiuta la scrittura? Una policy di retry, una coda dead-letter e un avviso, oppure una perdita silenziosa.
- Idempotenza. Se lo stesso documento viene elaborato due volte, ottenete un record o due? La rielaborazione è normale, quindi questo emerge nel secondo mese, non nel secondo anno.
- Riclassificazione. Quando un revisore corregge un’etichetta, la correzione si propaga al sistema di record, o solo al set di addestramento? Un sistema che migliora continuamente dalle correzioni vale poco se quelle correzioni non raggiungono mai il posto che il business legge realmente.
Il modello a cui puntare è che la classificazione sia un passaggio all’interno di un flusso più ampio di elaborazione intelligente dei documenti piuttosto che uno strumento a sé stante, in modo che conservazione, permessi e instradamento ereditino tutti l’etichetta invece di essere impostati di nuovo a mano. È da questa ereditarietà che deriva realmente gran parte del ritorno, ed è approfondito ulteriormente nella nostra panoramica sulla gestione documentale e dei contenuti.
Quanto costa, e dove risiede davvero il costo
Le licenze sono la voce che tutti confrontano e raramente la più grande. Su tre anni, la distribuzione reale si presenta di solito così:
- Tempo di revisione. Determinato direttamente dal tasso di elaborazione diretta. Ecco perché la discussione sull’accuratezza vista sopra è una discussione sui costi.
- Costruzione dell’integrazione. Scrivere i risultati in un sistema di record, con mappatura e gestione degli errori, è un progetto. Preventivatelo una volta e aspettatevi di rivederlo quando il sistema di destinazione si aggiorna.
- Manutenzione della tassonomia. Le classi derivano nel tempo. Qualcuno deve possedere questo compito, e se nessuno lo fa, l’accuratezza decade silenziosamente.
- Rielaborazione. Gli aggiornamenti dei modelli e le tassonomie corrette significano rieseguire il volume storico. Chiedete se la rielaborazione è misurata a consumo.
- Licenza e infrastruttura. Per documento, per pagina, per utente o per core, e la struttura conta quanto la tariffa.
Il segnale sano è che il costo per documento diminuisce all’aumentare del volume. Se un preventivo scala linearmente all’infinito, state finanziando il margine di qualcun altro sulla vostra crescita. Modellate il terzo anno, non il primo, e chiedete cosa succede al prezzo quando il volume raddoppia.
Dove la classificazione ripaga per prima
Il valore emerge ovunque un’etichetta sblocchi una decisione a valle invece di limitarsi a riordinare una cartella.
In sanità, la classificazione separa i contenuti clinici da quelli amministrativi al momento dell’acquisizione, in modo che i record ricadano sotto la regola di conservazione e la politica di accesso corrette senza che una persona debba scegliere. Nel legale e nei contratti, distingue un accordo eseguito da una bozza, che è la differenza tra un obbligo vincolante e un fascicolo di lavoro. Nei servizi finanziari, il driver è di solito l’evidenza: mostrare a un ispettore quali documenti hanno supportato una decisione, e quando. Nell’istruzione, è il volume, con cicli di ammissione che concentrano un anno di documenti in poche settimane.
Il filo conduttore è che la classificazione vale di più dove qualcosa di automatico accade dopo. Se l’etichetta aiuta solo una ricerca umana successiva, il ritorno è reale ma molto più piccolo. Dove conservazione e destinazione finale dipendono da essa, il caso è molto più forte, come approfondisce la nostra pagina sulla conformità e documenti archivistici.
Cinque errori che si ripresentano sempre
- Acquistare in base all’accuratezza della demo. Il corpus demo è stato scelto per funzionare. Il vostro no.
- Lanciare senza un ciclo di revisione. Se i documenti a bassa confidenza non hanno dove andare, il sistema blocca il lavoro oppure indovina. Entrambi sono peggio di una coda.
- Troppe classi. Quaranta classi con confini sfumati classificheranno sempre peggio di dodici con confini chiari. Iniziate in modo grossolano e suddividete solo quando una suddivisione cambia cosa succede dopo.
- Lasciare la tassonomia senza proprietario. Uno schema di classificazione è una cosa viva. Senza un proprietario, l’accuratezza decade e nessuno se ne accorge finché qualcuno non riesce a trovare qualcosa.
- Ignorare cosa eredita l’etichetta. Se conservazione, permessi e instradamento vengono ancora impostati a mano in seguito, avete automatizzato il passaggio facile e mantenuto tutti quelli costosi.
Dove si inserisce Contellect One
Contellect One applica la classificazione al momento dell’acquisizione, con un punteggio di confidenza su ogni decisione, in modo che instradamento, conservazione, permessi e ricerca ereditino tutti un’etichetta affidabile invece di ricavarne una in seguito. I documenti a bassa confidenza vanno a una coda di revisione, e le correzioni dei revisori vengono reimmesse nel modello.
Se state valutando le opzioni, la pagina classificazione documenti con AI illustra in maggiore dettaglio come funziona, e la guida all’acquisizione intelligente dei dati illustra la fase di acquisizione che la alimenta. Se preferite testarlo piuttosto che leggerne, chiedete una proof of concept sui vostri documenti e tenetici responsabili rispetto agli otto criteri sopra.
